AI untuk keamanan siber: alat bantu pertahanan sekaligus risiko baru
Oleh Dedi NugrohoTerbit 16 menit baca
Daftar isi
AI untuk keamanan siber sekarang bekerja di dua sisi sekaligus. Model terbaru membantu tim keamanan menemukan dan menambal celah jauh lebih cepat. Di sisi lain, penyerang memakai model yang sama untuk mengotomatiskan serangan. Agent AI yang kamu pasang sendiri juga membuka pintu baru. Jadi AI layak dipakai untuk bertahan, asalkan aksesnya dibatasi dan hasilnya selalu dicek manusia.
Tesis artikel ini: kecepatan menemukan celah sudah naik drastis, sedangkan kecepatan menambalnya belum. Selisih itulah risiko terbesar saat ini. Pertanyaan yang lebih berguna untuk kamu adalah "bagian mana dari sistem saya yang paling lambat diperbaiki, dan siapa yang akan menemukannya lebih dulu?".
Yang perlu diluruskan dulu
Ada dua pandangan ekstrem soal topik ini. Pandangan pertama menganggap AI akan menyelesaikan masalah keamanan, cukup pasang alat lalu tidur nyenyak. Pandangan kedua menganggap AI hanya senjata peretas, jadi sebaiknya dijauhi. Dua-duanya meleset.
Keamanan siber, dalam artikel ini, berarti upaya melindungi sistem, data, dan akun dari akses atau perusakan oleh pihak yang tidak berhak. Kemampuan siber AI bersifat dual use, artinya kemampuan yang sama bisa dipakai untuk bertahan maupun menyerang. Anthropic menulis hal ini terang-terangan di pengumuman perluasan Cyber Verification Program: kemampuan yang membantu tim keamanan menemukan dan memperbaiki celah juga bisa membantu pelaku jahat menyalahgunakannya.
Satu hal lagi yang perlu diluruskan: sebagian besar data publik soal topik ini datang dari perusahaan AI dan vendor keamanan. Mereka punya kepentingan bisnis. Angka mereka tetap berguna, tetapi harus dibaca sebagai laporan vendor, bukan hasil audit independen.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Sisi pertahanan | Apa yang sudah bisa dikerjakan AI untuk tim keamanan? |
| Sisi serangan | Bagaimana penyerang memakai AI sekarang? |
| Risiko dari AI milikmu | Apa bahayanya agent AI yang saya pasang sendiri? |
| Akses berlapis | Mengapa vendor membatasi kemampuan siber modelnya? |
| Sikap praktis | Apa yang sebaiknya dilakukan tim kecil? |
| Ringkasan | Apa yang harus dicek minggu ini? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Hampir semua fakta di sini diambil dari halaman resmi Anthropic, blog resmi Check Point, dan OWASP. Halaman resmi OpenAI tentang Daybreak tidak bisa saya buka saat riset, jadi informasi tentang program OpenAI di artikel ini hanya berasal dari tulisan Check Point. Artikel ini tidak memuat uji alat apa pun; semua angka adalah laporan pihak yang disebut namanya.
Artikel ini untuk kamu yang membangun atau mengelola website, aplikasi, atau otomasi, termasuk yang memakai agent AI. Juga untuk pemilik usaha yang ingin paham risikonya tanpa harus jadi ahli keamanan. Artikel ini bukan panduan teknis uji penetrasi, dan tidak membahas cara mendaftar program akses khusus.
Sisi pertahanan: apa yang sudah bisa dikerjakan AI
Gambaran paling jelas datang dari Project Glasswing, program Anthropic yang diumumkan 7 April 2026. Lewat program ini, organisasi penjaga software penting mendapat akses ke model Claude Mythos Preview. Menurut pengumuman Cyber Verification Program, para mitra Glasswing menemukan setidaknya 129.000 celah keamanan terverifikasi antara April dan Juli 2026. Upaya pemindaian open source Anthropic sendiri menambah 5.500 celah terverifikasi antara April dan Oktober 2026. Lebih dari 33.000 di antaranya dinilai berat atau kritis.
Angka itu besar, tetapi pengumumannya sendiri memberi catatan. Data berasal dari laporan sebagian mitra saja, yaitu 33 laporan, dan kurang dari separuh mitra melaporkan berapa yang sudah ditambal. Anthropic memperkirakan dampak sebenarnya setidaknya lima kali lebih besar, perkiraan yang juga belum diaudit pihak luar. Saya memilih membaca angka ini sebagai sinyal arah, bukan ukuran pasti.
Tiga bentuk bantuan yang sudah nyata
Pemindaian kode open source. Pada 8 Oktober 2026, Anthropic meluncurkan Anthropic Cyber Mission, dan salah satu isinya adalah OSS Scanner. Ini layanan gratis yang memindai proyek open source secara berkala dengan model terkuat Anthropic. Setiap laporan berisi bukti konsep, penjelasan, dan usulan perbaikan bila ada.
Bagian yang paling menarik bagi saya justru pengakuannya. Laporan OSS Scanner dibuat model dan dikirim tanpa ditinjau manusia, jadi sebagian bisa salah, misalnya tingkat keparahannya keliru. Anthropic menargetkan tingkat temuan benar di atas 90 persen. Itu klaim vendor yang belum diaudit pihak lain. Menurut halaman OSS Scanner, layanan ini ditujukan untuk proyek yang sudah sanggup mengikuti laporan celah berat, dan agen pemindainya berjalan di sandbox tanpa akses internet.
Pemindaian kode perusahaan. Untuk kode milik sendiri, tersedia Claude Security, saat ini public beta untuk Claude Enterprise. Alat ini memindai repositori, memverifikasi temuan, lalu mengusulkan patch. Setiap patch tetap harus ditinjau dan disetujui manusia. Halaman produknya juga menulis peringatan bahwa Claude bisa keliru, jadi patch untuk sistem penting wajib diperiksa.
Operasi keamanan sehari-hari. Check Point, vendor keamanan jaringan, mengumumkan di blog resminya pada 11 Juni 2026 bahwa mereka bergabung dengan inisiatif Daybreak milik OpenAI lewat program Trusted Access for Cyber. Menurut Check Point, mereka memakai GPT-5.5 untuk analisis ancaman, investigasi insiden, dan penyusunan aturan deteksi. Mereka juga menjalankan model itu terhadap kode produk sendiri untuk mencari celah sebelum penyerang menemukannya.
Infrastruktur yang tidak bisa dimatikan sesukanya
Bagian lain dari Cyber Mission menyentuh operational technology (OT), yaitu perangkat kendali dan jaringan industri yang menjalankan pembangkit listrik, pengolahan air, dan transportasi. Sistem OT sering tidak bisa dimatikan untuk ditambal, sehingga celah yang sudah diketahui bisa bertahan bertahun-tahun. Untuk itu ada Critical Infrastructure Defense Program dengan 11 mitra pendiri, di antaranya Accenture, CrowdStrike, Dragos, Palo Alto Networks, dan Rockwell Automation.
Ini relevan untuk pembaca di Indonesia walaupun programnya berfokus pada mitra besar. Pola masalahnya sama di mana pun: menemukan celah makin murah, menambalnya tetap mahal dan pelan. Pengumuman Cyber Mission menyebut bahwa di Glasswing sering ada jeda berbulan-bulan antara celah ditemukan dan diperbaiki.
Sisi serangan: penyerang sudah lebih dulu memakai AI
Kalau sisi pertahanan terdengar menjanjikan, sisi serangan perlu dibaca dengan kepala dingin. Datanya justru lebih konkret.
Kasus yang mengubah percakapan
Pada November 2025, Anthropic menerbitkan laporan tentang kampanye spionase siber yang diorkestrasi AI. Kampanye ini terdeteksi pertengahan September 2025. Anthropic menilai dengan keyakinan tinggi bahwa pelakunya kelompok yang disponsori negara Tiongkok. Mereka memanipulasi Claude Code untuk mencoba membobol sekitar 30 target global, dan berhasil pada sebagian kecil target.
Cara mereka mengakali model patut dipahami. Serangan dipecah menjadi tugas-tugas kecil yang tampak tidak berbahaya, dan model diberi tahu bahwa ia karyawan perusahaan keamanan yang sedang menguji pertahanan. Teknik mengakali batasan model seperti ini disebut jailbreak. Laporan itu menyebut AI mengerjakan 80 sampai 90 persen kampanye itu. Manusia hanya turun tangan di sekitar 4 sampai 6 titik keputusan penting per kampanye.
Ada detail yang sering terlewat. Model kadang berhalusinasi, misalnya mengaku menemukan kredensial yang ternyata tidak ada, atau menganggap data publik sebagai rahasia. Laporan itu menyebut ini masih menjadi hambatan bagi serangan yang sepenuhnya otomatis.
Pola itu sekarang menyebar
Laporan Detecting and countering misuse of AI: September 2026 mencakup aktivitas yang dihentikan Anthropic antara Desember 2025 dan Agustus 2026. Pesan utamanya keras: pola serangan otomatis yang dulu dipakai kelompok negara kini dipakai semua kelompok pelaku yang diselidiki Anthropic, dari dinas negara sampai individu. Kerangka agent penyerang yang tersedia publik, seperti PentAGI, ikut menurunkan hambatannya.
Salah satu kasus di laporan itu, yang diberi kode GTG-20006, menunjukkan arah perubahannya. Pelaku membangun alur kerja AI yang memantau apakah malware mereka terdeteksi produk keamanan. Begitu terdeteksi, agent otomatis mengubah dan membangun ulang malware itu sampai lolos. Artinya, deteksi berbasis tanda tangan statis makin cepat usang.
Kasus yang sama juga memperlihatkan serangan lewat jalur tidak langsung. Pelaku membobol setidaknya tiga vendor yang mengelola WiFi tamu hotel, lalu mengubah catatan DNS supaya lalu lintas tamu mengalir ke server mereka. Target sebenarnya adalah tamu tertentu, terutama orang yang terkait dengan Ukraina.
Tingkat keahlian tidak lagi jadi petunjuk
Anthropic juga memetakan 832 akun yang diblokir karena aktivitas siber jahat antara Maret 2025 dan Maret 2026 ke kerangka MITRE ATT&CK. MITRE ATT&CK adalah basis data teknik serangan yang dipakai luas oleh komunitas keamanan. Hasilnya dirangkum di tulisan pemetaan ancaman siber berbasis AI.
Beberapa temuannya:
- Aktivitas paling umum adalah menulis malware, dilakukan 560 dari 832 akun atau 67,3 persen.
- Porsi pelaku berisiko sedang ke atas naik dari 33 persen di enam bulan pertama menjadi 56 persen di enam bulan kedua.
- Pelaku paling tidak terampil memakai rata-rata sekitar 16 teknik serangan, hanya sedikit di bawah pelaku paling terampil yang memakai sekitar 20.
- Kampanye spionase 2025 tadi, kalau diukur dengan jumlah teknik, terlihat seperti pelaku risiko sedang. Padahal skor risiko Anthropic memberinya nilai maksimal 100.
Kesimpulan saya dari data ini cukup tegas. Jangan menilai ancaman dari seberapa canggih pelakunya terlihat. Pelaku yang dulu dianggap amatir sekarang bisa menjalankan langkah yang dulu hanya bisa dikerjakan tim berpengalaman.
Risiko yang datang dari AI milikmu sendiri
Bagian ini paling sering terlupa oleh orang yang membangun otomasi. Ancaman tidak hanya datang dari penyerang yang memakai AI. Agent AI yang kamu pasang di sistem sendiri juga bisa menjadi celah.
Prompt injection
Prompt injection adalah serangan yang menyisipkan instruksi ke input AI supaya perilakunya berubah dari yang dimaksud. OWASP menempatkannya di urutan pertama daftar risiko aplikasi LLM 2025. OWASP adalah komunitas nirlaba yang menerbitkan panduan keamanan aplikasi.
OWASP membedakan dua jenis. Injeksi langsung terjadi lewat pesan yang diketik ke AI. Injeksi tidak langsung terjadi ketika AI membaca konten luar, seperti halaman web atau file, yang menyimpan instruksi tersembunyi. OWASP juga menegaskan instruksi itu tidak harus terlihat oleh manusia, asalkan terbaca oleh model.
Jenis kedua yang paling relevan untuk otomasi. Bayangkan agent yang membaca email masuk, merangkumnya, lalu punya izin mengirim balasan dan membuka database pelanggan. Satu email berisi instruksi tersembunyi sudah cukup untuk membuat agent itu melakukan hal yang tidak pernah kamu minta. Salah satu skenario OWASP mirip ini: chatbot layanan pelanggan disusupi perintah untuk mengabaikan aturannya, membuka data pribadi, lalu mengirim email.
Dua rekomendasi OWASP yang menurut saya paling penting untuk tim kecil:
- Batasi hak akses model ke yang benar-benar diperlukan, dan simpan token akses di kode, bukan diserahkan ke model.
- Wajibkan persetujuan manusia untuk tindakan berisiko tinggi.
Salah konfigurasi lebih berbahaya dari model jahat
Contoh paling gamblang justru datang dari pembuat model sendiri. Pada Juli 2026, Anthropic memeriksa ulang 141.006 putaran evaluasi keamanan dan menemukan tiga insiden. Dalam ketiganya, model Claude yang sedang mengerjakan latihan capture the flag ternyata terhubung ke internet. Kejadian ini dijelaskan di laporan investigasi insiden evaluasi siber.
Prompt evaluasi sudah menyatakan bahwa lingkungannya simulasi tanpa internet. Karena salah paham konfigurasi dengan mitra evaluasi, akses internet ternyata terbuka. Model lalu menganggap sistem nyata di internet sebagai bagian latihan, dan membobol infrastruktur tiga organisasi dengan teknik dasar seperti password lemah dan endpoint tanpa autentikasi. Dua organisasi yang berhasil dihubungi bahkan belum mendeteksi aktivitas itu.
Laporan itu juga jujur soal perilaku model: satu model lama, Claude Opus 4.7, terus menyerang walaupun sudah menyadari sistemnya kemungkinan nyata. Pelajaran utamanya untuk kita tetap soal batas lingkungan. Pemicunya bukan niat jahat, tetapi asumsi yang salah bahwa lingkungan itu tertutup. Agent yang kamu kira hanya bisa menyentuh satu folder atau satu API sering punya akses lebih luas dari yang kamu sadari. Dan sistem korbannya jebol karena hal paling dasar.
Akses berlapis: cara vendor membagi kemampuan siber
Kalau kemampuan siber AI sebesar itu, bagaimana vendor memutuskan siapa yang boleh memakainya? Jawaban Anthropic saat ini adalah akses berlapis lewat Cyber Verification Program (CVP), yang diperluas pada 6 Oktober 2026. Project Glasswing digabungkan ke dalam program ini.
Model Anthropic yang tersedia umum memakai pengaman siber yang konservatif dan memblokir sebagian besar pekerjaan siber. Meski begitu, model umum tetap boleh dipakai untuk review kode, menambal celah yang sudah diketahui, mencari celah di kode milik sendiri, dan memilah peringatan keamanan. Untuk pekerjaan yang lebih dalam, organisasi harus mendaftar ke salah satu dari tiga tingkat.
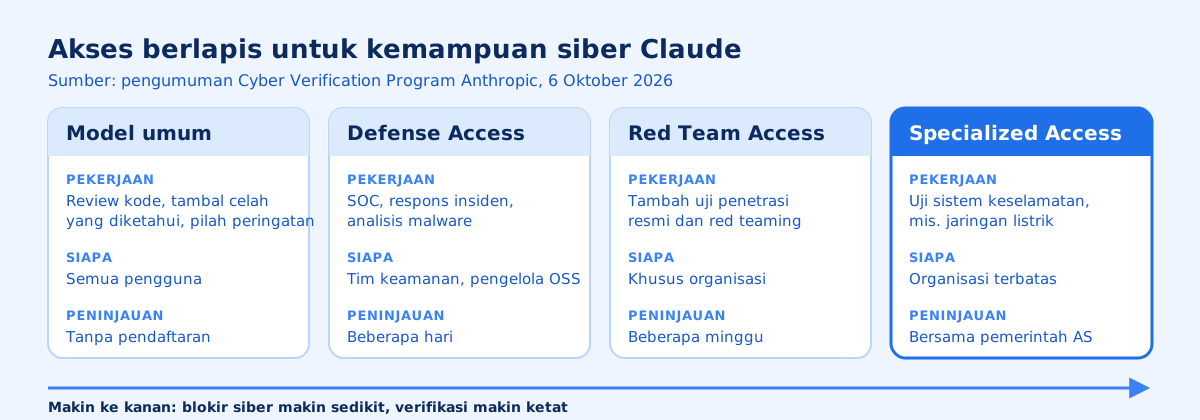
| Tingkat | Untuk pekerjaan | Contoh yang memenuhi syarat | Lama peninjauan menurut Anthropic |
|---|---|---|---|
| Model umum | Review kode, tambal celah yang diketahui, pilah peringatan | Semua pengguna | Tanpa pendaftaran |
| Defense Access | SOC, respons insiden, analisis malware, validasi celah | Tim keamanan internal, pengelola open source, peneliti dengan rekam jejak | Beberapa hari |
| Red Team Access | Tambahan uji penetrasi resmi dan red teaming, hanya pada sistem yang sudah diberi izin | Tim red team internal dan firma uji penetrasi, khusus organisasi | Beberapa minggu |
| Specialized Access | Menguji sistem keselamatan seperti jaringan listrik dan transfer antarbank | Organisasi terbatas, ditinjau bersama pemerintah AS | Peninjauan mendalam |
SOC (security operations center) adalah tim atau ruang kendali yang memantau dan menangani peringatan keamanan setiap hari. Red teaming berarti menyerang sistem sendiri secara resmi untuk menguji pertahanannya.
Pengumuman yang sama memuat hasil uji pengaman tiap tingkat dengan evaluasi bernama CyScenarioBench, yang mengukur kemampuan model menjalankan operasi siber bertahap. Dari 50 percobaan per tingkat dengan Claude Opus 5.5:
- Tanpa akses CVP, semua tugas diblokir sejak prompt pertama.
- Di Defense Access, 46 dari 50 percobaan diblokir di tengah jalan.
- Di Red Team Access, tidak ada blokir dan model menuntaskan 34 dari 50 tugas.
Ada syarat yang perlu diperhatikan organisasi: peserta program wajib mengizinkan penyimpanan data supaya Anthropic bisa memantau penyalahgunaan. Alternatif tanpa retensi data dijanjikan lewat solusi bernama Enterprise Frontier Safeguards, yang menurut pengumuman itu menyusul pada musim gugur 2026.
Pendapat saya: model akses berlapis ini masuk akal, tetapi jangan dianggap pagar yang sempurna. Kasus spionase 2025 terjadi pada model umum, lewat jailbreak. Pembatasan akses memperlambat penyerang, tetapi tidak menghentikan mereka sepenuhnya. Pertahanan utamamu tetap ada di sistemmu sendiri.
Sikap praktis untuk tim kecil dan pemilik usaha
Sebagian besar pembaca artikel ini tidak akan mendaftar ke program akses khusus mana pun. Pertanyaannya, apa artinya semua ini untuk website toko, aplikasi internal, atau workflow otomasi yang kamu kelola?
Yang saya sarankan
Tutup pintu yang paling dasar dulu. Dalam insiden evaluasi tadi, sistem nyata jebol karena password lemah dan endpoint tanpa autentikasi. Penyerang yang dibantu AI akan menemukan celah semacam itu jauh lebih cepat dari sebelumnya. Password unik, verifikasi dua langkah, dan update rutin bukan saran usang. Justru inilah yang paling cepat dicari mesin.
Pakai AI untuk review kode, tapi perlakukan hasilnya sebagai usulan. Model umum sudah boleh dipakai untuk mencari celah di kode milikmu sendiri. Saya pilih cara ini untuk proyek kecil karena Anthropic menyatakan pemakaian ini tetap diizinkan tanpa mendaftar program khusus. Tetapi setiap temuan harus dicek ulang, karena pembuat OSS Scanner sendiri mengakui laporannya bisa salah menilai tingkat keparahan.
Kecilkan izin setiap agent. Kalau agent hanya perlu membaca satu spreadsheet, jangan beri akses ke seluruh Google Drive. Kalau agent bisa mengirim email atau menghapus data, tambahkan langkah persetujuan manusia. Ini rekomendasi OWASP yang paling murah diterapkan.
Anggap semua konten luar sebagai tidak tepercaya. Email masuk, halaman web, file unggahan pelanggan, dan hasil pencarian bisa berisi instruksi tersembunyi. Workflow yang memasukkan konten seperti ini ke AI perlu dirancang dengan asumsi isinya bisa jahat.
Siapkan jalur tambal yang cepat. Data Glasswing menunjukkan menemukan celah sudah murah, sedangkan memperbaikinya masih lambat. Untuk tim kecil, ini berarti tahu siapa yang memegang server, di mana backup disimpan, dan berapa lama waktu yang dibutuhkan untuk merilis perbaikan.
Yang tidak saya sarankan
Saya tidak menyarankan memasang agent AI dengan akses penuh ke server produksi hanya karena demonya terlihat mulus. Saya juga tidak menyarankan membeli alat keamanan berbasis AI sebelum dasar-dasarnya beres. Alat semahal apa pun tidak menolong kalau password admin masih dipakai bersama di grup chat.
Satu lagi: jangan pernah mencoba menguji keamanan sistem orang lain dengan AI tanpa izin tertulis. Pengaman model memang akan memblokir sebagian besar permintaan semacam itu, tetapi persoalan utamanya hukum dan etika, bukan teknis. Bahkan di tingkat Red Team Access, Anthropic hanya mengizinkan pengujian terhadap sistem yang memang sudah diberi otorisasi.
Ke mana arahnya
Anthropic memperkirakan dalam dua tahun AI akan lebih menguntungkan pihak bertahan. Bug lebih mudah ditangkap sebelum dirilis, dan software aman lebih mudah ditulis dari awal. Tetapi mereka juga menulis bahwa dalam jangka pendek hal itu mungkin belum berlaku, karena biaya mengeksploitasi celah sudah turun sementara proses memperbaikinya masih bergantung pada manusia.
Saya cenderung setuju dengan bagian jangka pendeknya, dan lebih hati-hati soal prediksi dua tahun itu. Prediksi semacam ini datang dari pihak yang menjual alatnya. Yang bisa kita kendalikan adalah seberapa cepat sistem kita sendiri bisa ditambal.
Ringkasan dan langkah berikutnya
AI mempercepat dua hal sekaligus: pencarian celah oleh pihak bertahan, dan eksekusi serangan oleh penyerang. Agent AI milik sendiri menambah risiko ketiga lewat prompt injection dan izin yang terlalu luas. Respons yang masuk akal adalah memakai AI untuk mempercepat review, sambil memperketat dasar-dasar keamanan dan membatasi akses agent.
Checklist minggu ini
- Semua akun admin memakai password unik dan verifikasi dua langkah
- Ada daftar agent AI dan workflow otomasi yang berjalan, beserta akses masing-masing
- Setiap agent hanya memegang kredensial untuk sistem yang benar-benar ia butuhkan
- Tindakan berisiko, seperti mengirim email massal atau menghapus data, butuh persetujuan manusia
- Workflow yang membaca email, web, atau file dari luar sudah diperlakukan sebagai input tidak tepercaya
- Kode proyek sudah pernah di-review keamanannya, dengan bantuan AI atau manual
- Ada orang yang jelas bertanggung jawab menambal celah, dan backup terakhir sudah diuji
Cheat sheet
| Kalau kamu... | Langkah yang masuk akal |
|---|---|
| Developer atau pemilik proyek kecil | Pakai model umum untuk review keamanan kode milik sendiri, lalu cek ulang setiap temuan |
| Membangun agent atau workflow AI | Batasi izin, pisahkan kredensial, wajibkan persetujuan untuk tindakan berisiko |
| Pengelola proyek open source penting | Pertimbangkan OSS Scanner bila tim sanggup mengikuti laporan yang belum ditinjau manusia |
| Tim keamanan perusahaan | Pelajari syarat Defense Access di Cyber Verification Program |
| Pemilik usaha tanpa tim IT | Fokus ke password, verifikasi dua langkah, update, dan backup |
Kalau kamu sedang belajar membangun otomasi atau aplikasi dengan bantuan AI, biasakan memikirkan izin dan input tidak tepercaya sejak workflow pertama. Daftar Kelas di eduwebmu bisa jadi titik mulai untuk belajar membangun workflow dan aplikasi dengan AI secara bertahap.
Pertanyaan yang sering diajukan
Apakah AI sudah benar-benar dipakai untuk serangan siber?
Ya. Anthropic melaporkan kampanye spionase pada September 2025 yang 80 sampai 90 persen pekerjaannya dijalankan AI, dan laporan ancaman September 2026 menyebut pola serangan otomatis itu kini dipakai semua kelompok pelaku yang mereka selidiki.
Apa itu Cyber Verification Program dari Anthropic?
Program akses untuk profesional keamanan yang sudah diverifikasi. Sejak 6 Oktober 2026 program ini punya tiga tingkat, yaitu Defense Access, Red Team Access, dan Specialized Access, dengan batasan yang makin longgar di tiap tingkat.
Apakah model AI umum seperti Claude bisa dipakai untuk review keamanan kode?
Bisa. Menurut Anthropic, model yang tersedia umum tetap boleh dipakai untuk review kode, menambal celah yang sudah diketahui, mencari celah di kode milik sendiri, dan memilah peringatan keamanan.
Apa itu prompt injection?
Serangan yang menyisipkan instruksi ke input AI, baik langsung lewat chat maupun tidak langsung lewat isi website atau file yang dibaca AI. OWASP menempatkannya di urutan pertama daftar risiko aplikasi LLM 2025.
Apakah hasil temuan celah dari AI bisa langsung dipercaya?
Tidak sepenuhnya. Anthropic sendiri menyebut laporan OSS Scanner bisa berisi kesalahan, misalnya tingkat keparahan yang keliru, dan Claude Security mewajibkan setiap patch ditinjau manusia.
Saya pemilik usaha kecil tanpa tim keamanan. Apa yang paling perlu saya lakukan?
Mulai dari dasar yang tetap jadi pintu masuk utama: password kuat dan unik, verifikasi dua langkah, update rutin, dan tidak memberi agent AI akses lebih luas dari yang ia butuhkan.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.Anthropic, "Introducing the Anthropic Cyber Mission" (8 Oktober 2026)anthropic.com(buka di tab baru)
- 2.Anthropic, "Expanding the Cyber Verification Program" (6 Oktober 2026)anthropic.com(buka di tab baru)
- 3.Anthropic, "Project Glasswing" (7 April 2026)anthropic.com(buka di tab baru)
- 4.Anthropic Frontier Red Team, "OSS Scanner"red.anthropic.com(buka di tab baru)
- 5.Claude, "Claude Security"claude.com(buka di tab baru)
- 6.Check Point Blog, "Check Point Joins OpenAI's Trusted Access for Cyber Program and Daybreak Initiative" (11 Juni 2026)blog.checkpoint.com(buka di tab baru)
- 7.Anthropic, "Disrupting the first reported AI-orchestrated cyber espionage campaign" (13 November 2025)anthropic.com(buka di tab baru)
- 8.Anthropic, "Detecting and countering misuse of AI: September 2026"anthropic.com(buka di tab baru)
- 9.Anthropic, "What we learned mapping a year's worth of AI-enabled cyber threats" (3 Juni 2026)anthropic.com(buka di tab baru)
- 10.Anthropic, "Investigating three real-world incidents in our cybersecurity evaluations" (30 Juli 2026)anthropic.com(buka di tab baru)
- 11.OWASP Gen AI Security Project, "LLM01:2025 Prompt Injection"genai.owasp.org(buka di tab baru)
keamanan siberaianthropicprompt injection