Biaya AI agent: cara membatasi anggaran supaya tidak bocor
Oleh Dedi NugrohoTerbit 15 menit baca
Daftar isi
Biaya AI agent membengkak karena agent memutuskan sendiri berapa kali ia memanggil model dan alat. Cara membatasinya adalah memasang rem berlapis: batas per sesi, anggaran bulanan per agent, batas belanja di akun vendor, lalu alarm tagihan sebagai cadangan. Alarm saja tidak cukup, karena datang setelah uang terpakai.
Tesis artikel ini: kebocoran anggaran agent hampir selalu masalah desain, jarang masalah harga. Di Anthropic, harga per token Opus terbaru justru turun: input Claude Opus 5.5 $4 per juta token, sedangkan Opus 5 masih $5. Yang membuat tagihan kaget adalah putaran yang tidak dibatasi, konteks yang terus menggemuk, dan batas yang baru dipasang setelah kejadian.
Yang perlu diluruskan dulu
AI agent di artikel ini artinya program yang memakai model AI untuk memutuskan langkah berikutnya sendiri, memanggil alat seperti pencarian web atau database, lalu mengulang sampai tugasnya dianggap selesai. Bedanya dengan chatbot biasa ada di kata "mengulang". Chatbot menjawab sekali per pesan. Agent bisa memanggil model lima, dua puluh, atau lima puluh kali untuk satu permintaan.
Salah kaprah pertama soal biaya adalah anggapan bahwa memilih model murah sudah cukup. Model murah memang membantu. Tetapi agent yang terjebak berputar tetap bisa menghabiskan anggaran, hanya lebih lambat. Salah kaprah kedua: menganggap notifikasi tagihan sama dengan batas. Notifikasi memberi tahu, batas menghentikan. Dua hal ini sering tertukar.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Dari mana biaya agent datang | Komponen apa saja yang ditagih, dan mana yang paling sering terlupa? |
| Contoh hitungan | Seperti apa tagihan satu sesi agent dalam angka nyata? |
| Rem berlapis | Batas apa yang tersedia di vendor model, n8n, dan AWS? |
| Alarm bukan rem | Kenapa notifikasi tagihan datang terlambat? |
| Menekan biaya per tugas | Bagaimana membuat tiap tugas lebih murah tanpa mengorbankan hasil? |
| Ringkasan | Apa yang dicek sebelum agent dilepas ke produksi? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Angka harga dan batas diambil dari halaman resmi Anthropic, catatan rilis n8n, serta dokumentasi dan blog resmi AWS pada tanggal itu. Harga model berubah cukup sering, jadi cek ulang halaman harga sebelum menghitung anggaran. Artikel ini tidak memuat hasil uji biaya sendiri. Semua contoh angka berasal dari dokumentasi vendor.
Artikel ini untuk kamu yang sudah atau akan menjalankan agent untuk pekerjaan nyata: agent layanan pelanggan, agent riset, atau workflow n8n yang memakai node AI Agent. Kalau kamu hanya memakai aplikasi chat AI dengan langganan bulanan tetap, sebagian besar isi artikel ini belum relevan. Tagihanmu sudah dibatasi oleh harga langganan.
Dari mana biaya agent datang
Hampir semua vendor model menagih per token. Token adalah potongan teks yang diproses model, kira-kira sepotong kata. Harga dibedakan antara token input (yang kamu kirim ke model) dan token output (yang ditulis model). Di halaman harga resmi Anthropic, satuannya MTok, yaitu satu juta token.
Sebagai gambaran, ini harga dasar tiga model Claude generasi 5.5 per 2 November 2026. Anthropic juga menjual Claude Fable 5.1 untuk penalaran paling berat, dengan harga lebih tinggi: $10 input dan $50 output per MTok.
| Model | Input per MTok | Output per MTok | Baca cache per MTok |
|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0,20 |
| Claude Sonnet 5.5 | $2 | $10 | $0,10 |
| Claude Haiku 5.5 (prompt sampai 100.000 token) | $0,10 | $0,50 | $0,01 |
| Claude Haiku 5.5 (prompt di atas 100.000 token) | $0,50 | $2,50 | $0,05 |
Perhatikan dua hal. Pertama, output lima kali lebih mahal dari input di ketiga model. Kedua, Haiku 5.5 punya harga bertingkat: begitu satu permintaan membawa prompt di atas 100.000 token, seluruh permintaan itu dihitung dengan harga lima kali lipat. Untuk agent yang konteksnya terus bertambah, batas 100.000 token ini gampang terlewati tanpa disadari.
Sekarang bagian yang sering luput. Agent tidak hanya membayar pertanyaan pengguna dan jawaban akhir. Menurut bagian tool use pricing di halaman harga yang sama, token tambahan datang dari:
- Definisi alat. Nama, deskripsi, dan skema setiap alat yang kamu berikan ke agent ikut dikirim sebagai input di setiap panggilan.
- Prompt sistem untuk alat. Begitu ada alat, API menambahkan prompt sistem khusus yang jumlah tokennya berbeda per model.
- Blok pemanggilan dan hasil alat. Permintaan agent ke alat, beserta hasil yang dikembalikan alat, masuk lagi sebagai token di panggilan berikutnya.
- Biaya alat di sisi server. Pencarian web di Claude API dikenai $10 per 1.000 pencarian, di luar biaya token untuk isi hasil pencariannya.
- Alat yang berat definisinya. Anthropic menyebut toolset computer use menambah sekitar 4.500 token input per permintaan, dan toolset browser use sekitar 6.600 token.
Polanya kini terlihat. Setiap putaran agent mengirim ulang riwayat percakapan, semua definisi alat, dan semua hasil alat sebelumnya. Kalau hasil pencarian web berisi ribuan token, hasil itu ikut terbawa di setiap putaran selanjutnya. Biaya input tumbuh seperti bola salju, padahal pengguna hanya mengirim satu pesan.
Ada juga faktor yang tidak terlihat di tabel harga. Anthropic menulis bahwa Claude 4.7 ke atas memakai tokenizer baru yang menghasilkan sekitar 30 persen lebih banyak token untuk teks yang sama. Tokenizer adalah bagian yang memecah teks menjadi token. Jadi saat membandingkan model lama dan baru, harga per MTok saja bisa menyesatkan. Hitung ulang dengan teks nyata milikmu.
Contoh hitungan satu sesi agent
Supaya tidak abstrak, saya pakai contoh resmi dari bagian Claude Managed Agents di halaman harga Anthropic. Claude Managed Agents adalah layanan agent terkelola milik Anthropic yang ditagih dari dua sisi: token dan lama sesi berjalan. Contohnya satu sesi coding selama satu jam dengan Claude Opus 5.5, memakai 50.000 token input dan 15.000 token output.
| Komponen | Hitungan | Biaya |
|---|---|---|
| Token input | 50.000 × $4 / 1.000.000 | $0,20 |
| Token output | 15.000 × $20 / 1.000.000 | $0,30 |
| Waktu sesi | 1 jam × $0,08 | $0,08 |
| Total | $0,58 |
Kalau 40.000 dari token input itu dibaca dari cache, biaya input turun menjadi $0,04 untuk token yang tidak di-cache ditambah $0,008 untuk token cache. Totalnya menjadi $0,428. Prompt caching adalah fitur yang menyimpan bagian awal prompt yang sama, sehingga panggilan berikutnya cukup membaca simpanan itu dengan tarif jauh lebih rendah.
Angka $0,58 per sesi terlihat kecil. Masalahnya ada di perkalian. Agent layanan pelanggan yang melayani 2.000 sesi sebulan dengan pola serupa sudah menyentuh lebih dari $1.000. Itu belum menghitung sesi yang macet dan berputar lebih lama dari biasanya. Hitungan ini perkalian sederhana dari contoh Anthropic, bukan data pemakaian nyata.
Dua catatan dari halaman yang sama perlu kamu ketahui. Waktu sesi hanya dihitung saat status sesi running. Waktu menunggu pesan atau konfirmasi pengguna tidak ditagih. Lalu, diskon Batch API tidak berlaku untuk sesi Managed Agents, karena sesinya interaktif dan tidak punya mode batch.
Pelajaran yang saya ambil dari contoh ini: output adalah komponen terbesar meskipun jumlah tokennya paling kecil. Agent yang diminta menulis laporan panjang di setiap langkah akan jauh lebih mahal daripada agent yang diminta menjawab ringkas lalu menulis laporan sekali di akhir.
Rem berlapis: batas di vendor, platform, dan aplikasi
Saya membagi batas anggaran menjadi tiga lapis. Makin dekat ke agent, makin cepat rem bekerja. Makin dekat ke akun, makin kasar rem itu, karena ia menghentikan semua aplikasi sekaligus.
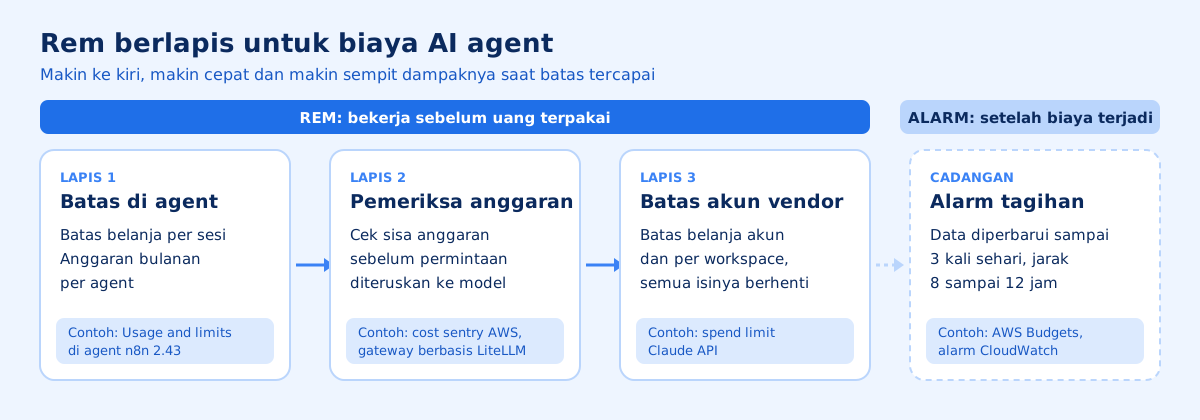
Lapis 1: batas di level agent
Ini lapis yang paling dekat dengan masalah. Contoh nyatanya ada di n8n. Menurut catatan rilis n8n, versi 2.43 yang rilis 6 Oktober 2026 menambahkan kartu Usage and limits di pengaturan agent. Isinya:
- Belanja bulan berjalan untuk agent itu.
- Anggaran bulanan yang bisa diatur.
- Batas belanja per sesi (session spend cap).
- Ambang peringatan opsional antara 10 dan 100 persen dari anggaran bulanan.
Catatan rilis itu juga menyebut dua detail penting. Anggaran harus diisi lebih dari 0 supaya berlaku, dan mengosongkannya berarti mematikan pengamannya. Saat menguji di preview builder, agent yang menyentuh batas atau ambang akan menampilkan kartu untuk menaikkan batas atau menutup peringatan tanpa menghentikan proses. Catatan rilis menyebut chat yang sudah dipublikasikan tidak terpengaruh oleh perilaku kartu itu. Lalu di versi 2.45 (20 Oktober 2026), panel anggaran diperbarui otomatis setiap kali satu giliran agent selesai.
Pendapat saya: batas per sesi lebih berguna daripada anggaran bulanan. Anggaran bulanan melindungi dompet, tetapi saat ia tercapai semua pengguna ikut terhenti. Batas per sesi menghentikan satu percakapan yang macet tanpa mengganggu yang lain. Pasang keduanya, dan pasang batas sesi lebih dulu.
Lapis 2: pemeriksa anggaran sebelum memanggil model
Lapis kedua berada di antara aplikasi dan vendor model. Idenya sederhana: setiap permintaan ke model dicek dulu terhadap sisa anggaran, baru diteruskan.
AWS menjelaskan pola ini di seri Build a proactive AI cost management system for Amazon Bedrock yang terbit 22 Oktober 2025. Solusi yang mereka sebut cost sentry mengambil data pemakaian token dari CloudWatch, membandingkannya dengan batas per model yang disimpan di database, lalu memutuskan apakah permintaan boleh diteruskan. Ada juga batas default untuk model yang belum punya anggaran sendiri. Amazon Bedrock adalah layanan AWS untuk mengakses banyak model AI lewat satu API.
Kalimat paling penting dari tulisan itu menurut saya: pengembang perlu memasang circuit breaker dan batas konsumsi di aplikasinya sendiri. Circuit breaker adalah pemutus otomatis yang menghentikan panggilan begitu kondisi tertentu terpenuhi. AWS juga menyebut alternatif yang sudah jadi, yaitu Generative AI Gateway Solution di AWS Solutions Library yang memakai LiteLLM untuk menegakkan batas anggaran.
Lapis ini masuk akal kalau kamu menjalankan beberapa agent atau beberapa klien dari satu akun. Untuk satu agent kecil, lapis 1 dan lapis 3 biasanya sudah cukup. Membangun cost sentry sendiri butuh kerja engineering yang tidak sedikit.
Lapis 3: batas belanja di akun vendor
Lapis terakhir adalah batas di akun penyedia model. Di Claude API, dokumentasi rate limits Anthropic menyebut setiap tier punya batas belanja bulanan:
| Tier | Batas belanja bulanan |
|---|---|
| Start | $500 |
| Build | $1.000 |
| Scale | $200.000 |
| Custom | Tanpa batas bawaan, diatur bersama tim akun |
Begitu batas tier tercapai, pemakaian API berhenti sampai 00:00 UTC tanggal 1 bulan berikutnya, kecuali kamu meminta kenaikan tier. Permintaan ditolak dengan HTTP 429 dan kode enforced_spend_limit_reached.
Yang lebih berguna untuk pengendalian adalah batas yang kamu pasang sendiri. Kamu bisa mengatur batas belanja sendiri di bawah batas tier lewat halaman Billing di Claude Console, dan bisa juga memasang batas per workspace. Workspace adalah pembagian di dalam satu organisasi, misalnya satu workspace per proyek atau per klien. Satu pengecualian: workspace default tidak bisa diberi batas belanja. Saat batas buatan sendiri tercapai, permintaan ditolak dengan HTTP 400 dan pesan yang menyebut kapan akses pulih.
Batas akun adalah jaring pengaman terakhir. Jangan jadikan ia rem utama, karena saat tercapai seluruh aplikasi di akun itu berhenti bersamaan.
Alarm bukan rem
Banyak tim merasa aman karena sudah memasang notifikasi tagihan. Masalahnya ada di waktu. Menurut panduan AWS Budgets, data AWS Budgets diperbarui sampai tiga kali sehari, biasanya 8 sampai 12 jam setelah pembaruan sebelumnya. Dokumen yang sama menyebut ada jeda antara saat biaya terjadi dan saat notifikasi dikirim.
Bayangkan agent yang macet pukul sembilan malam. Kalau notifikasi baru datang besok pagi, agent itu sudah berputar semalaman. Inilah yang dimaksud tulisan AWS soal cost sentry: alarm anggaran dan deteksi anomali biaya membantu menemukan pemakaian yang tinggi, tetapi sifatnya reaktif. Mereka menyebut alarm sebagai indikator yang tertinggal, sedangkan batas sebelum permintaan adalah indikator yang mendahului.
Bukan berarti alarm tidak berguna. AWS Budgets bisa mengirim peringatan untuk biaya aktual maupun biaya yang diperkirakan, dan bisa menjalankan budget action. Contoh dari dokumentasinya adalah menerapkan kebijakan IAM yang menolak pembuatan sumber daya baru begitu ambang tertentu tercapai. Alarm cocok untuk menangkap tren: biaya bulan ini naik dua kali lipat dibanding bulan lalu, atau satu proyek tiba-tiba mendominasi tagihan.
Untuk memantau lebih cepat, tulisan resmi AWS Effective cost optimization strategies for Amazon Bedrock (10 Juni 2025) menyebut metrik CloudWatch seperti InputTokenCount dan OutputTokenCount yang bisa dipasangi alarm. Tulisan yang sama menyarankan application inference profiles dan tag alokasi biaya supaya pemakaian bisa dipisah per aplikasi, tim, atau penyewa.
Urutan yang saya sarankan: rem dulu, baru alarm. Batas sesi dan batas akun mencegah kerugian besar. Alarm dan dasbor membantu kamu memahami pola biaya dan menyetel ulang batas itu setiap bulan.
Menekan biaya per tugas tanpa mengorbankan hasil
Batas mencegah kebocoran. Tetapi kalau biaya per tugas memang tinggi, batas hanya akan membuat agent sering berhenti. Bagian ini soal membuat tiap tugas lebih murah. Sumber utamanya adalah bagian cost optimization strategies di halaman harga Anthropic dan tulisan biaya Bedrock dari AWS. Keduanya sampai pada saran yang mirip.
Pilih model per langkah, bukan per agent
Anthropic menyarankan Haiku untuk tugas sederhana, Sonnet untuk sebagian besar beban produksi, dan Opus untuk penalaran paling rumit. AWS memberi saran serupa untuk agent: pecah satu agent besar menjadi beberapa agent kecil yang khusus, pakai model murah untuk tugas sederhana, dan simpan model premium untuk penalaran berat. Koordinatornya cukup agent ringan.
Selisih harganya besar. Input Haiku 5.5 untuk prompt pendek $0,10 per MTok, sedangkan Opus 5.5 $4 per MTok, empat puluh kali lipat. Kalau langkah klasifikasi, ringkasan pendek, atau ekstraksi data bisa ditangani model kecil, penghematannya terasa langsung. Saya tidak menyarankan memakai model paling besar untuk semua langkah hanya karena hasilnya "lebih aman". Itu cara tercepat membuat anggaran bocor dengan rapi.
Pakai prompt caching untuk konteks yang berulang
Agent sangat cocok dengan caching karena definisi alat dan prompt sistemnya sama di setiap putaran. Di halaman harga Anthropic, membaca cache untuk Opus 5.5 dan Sonnet 5.5 hanya 0,05 kali harga input dasar. Menulis ke cache justru lebih mahal: untuk Opus 5.5, menulis ke cache 5 menit $5 per MTok dan ke cache 1 jam $8 per MTok, dibanding input biasa $4.
Artinya caching hanya menguntungkan kalau isi yang di-cache memang dipakai ulang beberapa kali dalam masa simpannya. Agent dengan sesi panjang dan banyak putaran hampir selalu untung. Agent yang hanya dipanggil sesekali dengan prompt berbeda-beda bisa rugi. Di n8n, opsi prompt caching tersedia di node Anthropic Chat Model sejak versi 2.37 dan di operasi Message pada node Anthropic sejak 2.42. Menurut catatan rilis n8n, keduanya mati secara default.
Pindahkan yang tidak mendesak ke batch
Batch adalah mode pengiriman banyak permintaan sekaligus yang diproses tidak secara langsung. Anthropic memberi potongan 50 persen untuk input dan output lewat Batch API. AWS menyebut potongan yang sama, 50 persen lebih murah dari harga on-demand, untuk model tertentu di batch inference Bedrock. Contoh dari AWS: deskripsi produk baru dibuat sekaligus setiap malam, bukan saat pengunjung membuka halaman.
Batch tidak cocok untuk agent yang melayani percakapan langsung. Tetapi banyak pekerjaan "agent" sebenarnya tidak butuh jawaban instan: merangkum tiket harian, mengecek data pesaing, atau menyiapkan draf laporan mingguan. Pekerjaan semacam ini kandidat kuat untuk batch.
Rapikan apa yang dibawa agent di setiap putaran
Bagian ini jarang dibahas di halaman harga, tetapi mengikuti langsung dari cara tool use ditagih. Beberapa kebiasaan yang saya sarankan:
- Berikan agent hanya alat yang ia butuhkan untuk tugas itu. Setiap definisi alat ikut terkirim di setiap panggilan.
- Potong hasil alat sebelum dikembalikan ke agent. Hasil pencarian atau isi halaman web yang panjang sebaiknya diringkas atau dibatasi jumlah karakternya.
- Batasi jumlah putaran maksimum per tugas, terpisah dari batas belanja. Ini menangkap agent yang berputar walau tiap putarannya murah.
- Minta jawaban ringkas di langkah perantara dan simpan tulisan panjang untuk langkah terakhir, karena output adalah komponen termahal.
Ringkasan dan langkah berikutnya
Checklist sebelum agent masuk produksi
- Tahu model apa yang dipakai di setiap langkah, dan harga input serta outputnya per MTok
- Sudah menghitung perkiraan biaya satu sesi normal dari token input, output, dan alat
- Batas belanja per sesi sudah dipasang (misalnya session spend cap di agent n8n)
- Anggaran bulanan per agent sudah diisi lebih dari 0, dengan ambang peringatan
- Batas belanja akun di bawah batas tier sudah diatur di console vendor
- Agent produksi dan eksperimen dipisah ke workspace atau proyek berbeda
- Jumlah putaran maksimum per tugas sudah dibatasi
- Alarm tagihan aktif, dan semua orang paham bahwa alarm datang terlambat
- Prompt caching dinilai untuk konteks yang berulang, batch dinilai untuk tugas yang tidak mendesak
Cheat sheet
| Masalah | Rem yang paling tepat | Contoh fitur |
|---|---|---|
| Satu sesi berputar tanpa henti | Batas per sesi dan batas putaran | Session spend cap agent n8n |
| Satu agent menghabiskan jatah bulanan | Anggaran bulanan per agent | Usage and limits di agent n8n (2.43+) |
| Banyak agent atau klien dalam satu akun | Pemeriksa anggaran sebelum memanggil model | Cost sentry AWS, gateway berbasis LiteLLM |
| Eksperimen mengganggu produksi | Batas per workspace | Workspace limit di Claude Console |
| Tagihan akun tak terkendali | Batas belanja akun | Spend limit Claude API, budget action AWS |
| Tren biaya naik pelan-pelan | Alarm dan dasbor | AWS Budgets, metrik token CloudWatch |
| Biaya per tugas memang tinggi | Model lebih kecil, caching, batch | Haiku untuk langkah ringan, Batch API potongan 50 persen |
Langkah berikutnya yang saya sarankan sebelum membangun agent dengan akun API sendiri: ukur dulu seberapa jauh model kecil bisa menangani tugasmu. Di AI Tools eduwebmu, kamu bisa mencoba tugas yang sama di model Standar (Haiku), Pro (Sonnet 5.5), dan Premium (Opus) memakai Saldo AI. Catat di langkah mana hasil Standar sudah cukup. Daftar itu menjadi dasar keputusan model per langkah, dan memberi gambaran anggaran sebelum kamu mengurus batas belanja di console vendor.
Pertanyaan yang sering diajukan
Kenapa biaya AI agent lebih sulit ditebak daripada chatbot biasa?
Agent menentukan sendiri berapa kali ia memanggil model dan alat. Setiap putaran mengirim ulang konteks, definisi alat, dan hasil alat sebagai token input, sehingga satu tugas bisa memakan puluhan panggilan.
Apakah AWS Budgets bisa menghentikan tagihan Amazon Bedrock secara otomatis?
AWS Budgets terutama mengirim notifikasi, dan datanya diperbarui sampai tiga kali sehari. Ada fitur budget action, misalnya menerapkan kebijakan IAM yang menolak pembuatan sumber daya baru, tetapi blog resmi AWS tentang biaya Bedrock menyebut alarm anggaran bersifat reaktif.
Apa yang terjadi kalau batas belanja di Claude API tercapai?
Kalau batas tier tercapai, permintaan ditolak dengan HTTP 429 sampai 00:00 UTC tanggal 1 bulan berikutnya, kecuali tier dinaikkan. Kalau batas yang kamu pasang sendiri tercapai, permintaan ditolak dengan HTTP 400 sampai batas dinaikkan atau dihapus.
Di versi n8n berapa agent punya pengaturan anggaran bulanan?
Kartu Usage and limits untuk agent muncul di catatan rilis n8n 2.43 (6 Oktober 2026). Isinya belanja bulan berjalan, anggaran bulanan, batas belanja per sesi, dan ambang peringatan 10 sampai 100 persen.
Apakah prompt caching selalu membuat agent lebih murah?
Hanya bila bagian awal prompt yang sama benar-benar dipakai ulang. Menulis ke cache justru lebih mahal dari input biasa, sedangkan membaca dari cache jauh lebih murah.
Model mana yang sebaiknya dipakai agent supaya hemat?
Mulai dari model termurah yang hasilnya masih cukup untuk tugasmu, lalu naikkan hanya untuk langkah yang butuh penalaran berat. Anthropic menyarankan Haiku untuk tugas sederhana, dan AWS menyarankan model murah untuk tugas ringan serta model mahal untuk tugas rumit.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.Anthropic, "Pricing" (Claude Platform Docs)docs.claude.com(buka di tab baru)
- 2.Anthropic, "Rate limits" (bagian Spend limits)docs.claude.com(buka di tab baru)
- 3.n8n Docs, "Release notes" (entri n8n 2.37 rilis 2026-08-25, 2.42 rilis 2026-09-29, 2.43 rilis 2026-10-06, 2.45 rilis 2026-10-20)docs.n8n.io(buka di tab baru)
- 4.AWS Machine Learning Blog, "Build a proactive AI cost management system for Amazon Bedrock, Part 1" (22 Oktober 2025)aws.amazon.com(buka di tab baru)
- 5.AWS Machine Learning Blog, "Effective cost optimization strategies for Amazon Bedrock" (10 Juni 2025)aws.amazon.com(buka di tab baru)
- 6.AWS Documentation, "Managing your costs with AWS Budgets"docs.aws.amazon.com(buka di tab baru)
ai agentbiaya ain8nanthropicfinops