LLM self-hosted vs API cloud dalam otomasi: kapan pakai yang mana
Oleh Dedi NugrohoTerbit 17 menit baca
Daftar isi
LLM self-hosted cocok untuk data yang tidak boleh keluar dari jaringanmu, atau untuk volume permintaan besar dan stabil. API cloud cocok untuk volume kecil sampai sedang, tugas yang butuh model terkuat, dan tim yang tidak punya orang untuk merawat server. Di n8n, keduanya bisa hidup dalam satu workflow dan dipilih per permintaan.
Tesis artikel ini: pertanyaannya hampir tidak pernah "self-hosted atau API", tetapi "permintaan mana lewat jalur mana". Memilih satu kubu di awal mudah menjebak. Membeli GPU demi mengirit tidak masuk akal bila tagihan API-nya cuma beberapa dolar sebulan, seperti simulasi di bab biaya nanti. Sebaliknya, mengirim data pelanggan mentah ke API tanpa membaca ketentuan penyedianya juga keputusan yang ceroboh. Keputusan yang lebih sehat dibuat per jenis tugas.
Yang perlu diluruskan dulu
Ada tiga anggapan umum soal LLM self-hosted yang perlu diluruskan sebelum masuk ke hitungan.
Anggapan pertama, self-hosted pasti lebih murah karena "tidak bayar per token". Ini setengah benar. Kamu memang tidak membayar per token, tetapi membayar perangkat keras, listrik, dan waktu orang yang merawatnya. Blog resmi n8n yang terbit 22 Oktober 2026 menulisnya terang: untuk pemakaian rendah atau tidak menentu, cloud bisa lebih ekonomis.
Anggapan kedua, self-hosted otomatis aman dan patuh aturan. Artikel n8n yang sama menegaskan bahwa menjalankan model sendiri tidak membuat sistem otomatis patuh regulasi. Kamu tetap butuh pengaman di akses, pencatatan log, dan penyimpanan. n8n bahkan menulis bahwa sebagian model cloud, terutama yang punya SLA enterprise, bisa memiliki kontrol akses dan pengaman yang lebih kuat.
Anggapan ketiga, semua data yang dikirim ke API pasti dipakai melatih model. Untuk dua penyedia besar, kebijakan resminya berkata lain. Detailnya ada di bab privasi.
Supaya istilahnya sama dulu, berikut definisi singkat yang dipakai sepanjang artikel:
- LLM (large language model): model AI yang membaca dan menghasilkan teks, misalnya untuk merangkum email atau mengklasifikasi tiket.
- API cloud: kamu mengirim teks ke server penyedia seperti OpenAI atau Anthropic, lalu membayar sesuai jumlah token yang diproses.
- Token: potongan kecil teks yang dihitung penyedia untuk menagih. Harga biasanya ditulis per satu juta token (MTok).
- Self-hosted: model dijalankan di mesin yang kamu kendalikan, entah komputer kantor, server sendiri, atau server sewaan.
- Open-weight: model yang bobot hasil latihnya boleh diunduh dan dijalankan sendiri.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Dua jalur, beda tanggung jawab | Apa saja yang harus kamu urus di masing-masing jalur? |
| Hitung biaya dengan angka resmi | Berapa sebenarnya biaya API untuk volume otomasi biasa? |
| Privasi dan kepatuhan | Apa yang terjadi pada data saat dikirim ke API? |
| Kemampuan dan perangkat keras | Model apa yang realistis dijalankan sendiri? |
| Pola hibrida di n8n | Bagaimana satu workflow memilih jalur per permintaan? |
| Ringkasan | Apa yang dicek sebelum memutuskan? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Harga API berubah cukup sering, jadi angka di sini adalah harga di halaman resmi pada tanggal itu. Saya tidak menyertakan harga GPU atau sewa server, karena variasinya terlalu besar dan saya tidak punya sumber resmi yang bisa dipakai sebagai patokan umum. Hitungan biaya di artikel ini adalah simulasi aritmetika dari harga resmi dengan asumsi volume yang saya tulis terang, bukan data pemakaian nyata.
Artikel ini untuk kamu yang sudah atau akan memakai AI di dalam workflow otomasi, misalnya di n8n, dan sedang menimbang apakah perlu menjalankan model sendiri. Artikel ini tidak cocok bila kamu mencari panduan memasang Ollama langkah demi langkah. Itu topik tutorial, dan dokumentasi resminya sudah cukup jelas.
Dua jalur, beda tanggung jawab
Cara termudah membandingkan keduanya adalah melihat siapa yang mengurus apa. Blog n8n membagi tumpukan LLM self-hosted menjadi lima lapis. Saya pakai pembagian itu karena membantu melihat pekerjaan yang tersembunyi.
- Perangkat keras. GPU menyediakan VRAM (memori kartu grafis) dan daya hitung. Keduanya menentukan model apa yang bisa jalan dan seberapa cepat jawabannya.
- Model. Model open-weight yang kamu pilih untuk tugasnya.
- Inference runtime. Perangkat lunak yang memuat model lalu membukanya untuk aplikasi lain, biasanya lewat API. Contoh yang disebut n8n adalah Ollama dan vLLM.
- Lapisan retrieval. Bila model butuh informasi internal, sistem mencari dokumen relevan lalu menambahkannya ke permintaan. Teknik ini disebut RAG (retrieval-augmented generation).
- Lapisan aplikasi. Antarmuka chat, API, atau workflow yang mengirim permintaan dan memakai jawabannya.
Dengan API cloud, lapis satu sampai tiga diurus penyedia. Kamu cukup memikirkan lapis empat dan lima. Dengan self-hosted, kelimanya tanggung jawabmu, termasuk saat GPU penuh, model perlu diperbarui, atau server mati jam dua pagi.
Ringkasan perbedaannya, disusun dari tabel di blog n8n:
| Aspek | LLM self-hosted | API cloud |
|---|---|---|
| Privasi | Kendali lebih besar atas tempat data diproses | Penyedia memproses data sesuai ketentuan layanannya |
| Biaya | Biaya tetap infrastruktur dan operasional lebih tinggi | Dibayar sesuai pemakaian token |
| Latensi | Bisa stabil bila kapasitas lokal cukup | Tergantung jaringan, kapasitas penyedia, dan batas laju |
| Kemampuan | Terbatas pada model yang sanggup kamu jalankan | Akses lebih mudah ke model terbaru dan terkuat |
| Perawatan | Diurus tim internal | Sebagian besar diurus penyedia |
Ada satu nuansa baru yang perlu kamu tahu. Batas antara "open-weight" dan "self-hosted" makin kabur. Halaman harga Ollama kini menawarkan model cloud dengan bayar per token, misalnya gpt-oss:20b seharga $0,07 per juta token input dan $0,30 per juta token output. Artinya, memakai Ollama atau model open-weight tidak sama dengan data pasti diproses di mesinmu. Yang menentukan adalah di mana model itu dijalankan.
Hitung biaya dengan angka resmi
Bagian ini yang paling sering bikin keputusan meleset, jadi saya pakai angka. Semua harga di bawah diambil dari halaman harga Anthropic dan halaman harga OpenAI pada 2 November 2026, dalam dolar AS per satu juta token.
| Model | Input | Output | Catatan |
|---|---|---|---|
| Claude Haiku 5.5 | $0,10 | $0,50 | Untuk prompt sampai 100.000 token |
| gpt-6-luna | $0,10 | $0,50 | Konteks pendek |
| gpt-6.1-terra | $1,00 | $5,00 | Konteks pendek |
| Claude Sonnet 5.5 | $2,00 | $10,00 | |
| Claude Opus 5.5 | $4,00 | $20,00 |
Tabel ini sengaja tidak memuat model termahal. Di halaman yang sama, Claude Fable 5.1 dan gpt-6-astra sama-sama dihargai $10 input dan $50 output per MTok. Untuk otomasi sehari-hari, model sekelas itu jarang dibutuhkan.
Anthropic menyebut Haiku 5.5 ditujukan untuk tugas bervolume tinggi seperti klasifikasi, ekstraksi, dan routing. Itu persis jenis tugas yang paling banyak ada di workflow otomasi.
Simulasi: 1.000 email sehari
Ambil contoh workflow yang membaca 1.000 email masuk per hari, lalu mengklasifikasikan dan merangkumnya. Anggap tiap email rata-rata 1.500 token input dan 300 token output. Angka ini asumsi untuk simulasi, bukan data dari sistem nyata.
Dalam sebulan (30 hari) ada 30.000 permintaan. Totalnya 45 juta token input dan 9 juta token output. Hitungannya:
| Model | Biaya input | Biaya output | Total per bulan |
|---|---|---|---|
| Claude Haiku 5.5 atau gpt-6-luna | 45 × $0,10 = $4,50 | 9 × $0,50 = $4,50 | sekitar $9 |
| gpt-6.1-terra | 45 × $1 = $45 | 9 × $5 = $45 | sekitar $90 |
| Claude Sonnet 5.5 | 45 × $2 = $90 | 9 × $10 = $90 | sekitar $180 |
| Claude Opus 5.5 | 45 × $4 = $180 | 9 × $20 = $180 | sekitar $360 |
Dua hal langsung terlihat. Pertama, untuk tugas klasifikasi sederhana, model kecil di API sudah sangat murah. Membeli dan merawat GPU demi menghemat sekitar sembilan dolar sebulan jelas tidak masuk akal. Kedua, pilihan model jauh lebih berpengaruh pada tagihan daripada pilihan self-hosted atau cloud. Selisih Haiku dan Opus pada simulasi ini 40 kali lipat.
Penyedia API juga menyediakan potongan untuk pekerjaan yang tidak perlu dijawab seketika. Anthropic menyebut Batch API memberi diskon 50 persen untuk token input dan output. OpenAI juga mencantumkan harga batch terpisah yang besarnya separuh harga standar untuk model yang tertera di halaman itu. Untuk laporan malam hari atau pemrosesan arsip, ini memangkas biaya tanpa mengganti arsitektur.
Biaya self-hosted yang sering lupa dihitung
Di sisi self-hosted, komponen biayanya lebih banyak dan sebagian tidak muncul di tagihan:
- Perangkat keras dengan VRAM cukup, dibeli atau disewa.
- Listrik dan pendinginan, bila mesinnya ada di kantor.
- Waktu orang untuk memasang, memperbarui model, memantau, dan memperbaiki saat macet.
- Kapasitas cadangan. GPU yang menganggur malam hari tetap dibayar.
- Biaya mengevaluasi ulang model setiap kali ada versi baru.
Blog n8n menyebut titik impas (breakeven) sebagai titik ketika total biaya sistem sendiri menjadi lebih rendah daripada biaya API. Di bawah volume itu, API lebih hemat. Di atasnya, self-hosted mulai menang, asalkan kualitas model lokalnya cukup untuk tugas itu.
Ada jalan tengah yang disebut n8n untuk pemrosesan batch: menyewa VPS dengan GPU dan menyalakannya hanya saat ada data yang perlu diproses. Biayanya mengikuti jam pemakaian, dan n8n menyebut cara ini memberi privasi data yang relatif terjaga. Kata "relatif" itu penting, karena servernya tetap milik penyedia sewaan. Pola ini cocok untuk pekerjaan berkala seperti merangkum arsip dokumen sebulan sekali.
Pendapat saya: untuk usaha kecil dan tim yang baru mulai, jalur default adalah API dengan model kecil. Pindahkan tugas ke model lokal hanya bila ada alasan yang bisa kamu tulis dalam satu kalimat, seperti "data rekam medis tidak boleh keluar dari jaringan klinik". Alasan "biar hemat" perlu dibuktikan dengan hitungan seperti di atas, bukan perasaan.
Privasi dan kepatuhan: apa yang sebenarnya terjadi pada data
Ini alasan paling kuat untuk self-hosted, sekaligus yang paling sering disalahpahami. Mari lihat apa kata penyedianya sendiri.
Halaman kebijakan data OpenAI menyatakan bahwa sejak 1 Maret 2023, data yang dikirim ke API OpenAI tidak dipakai untuk melatih atau memperbaiki model, kecuali pelanggan secara eksplisit memilih ikut berbagi. Namun OpenAI tetap membuat log pemantauan penyalahgunaan (abuse monitoring) untuk semua pemakaian API. Log itu bisa berisi prompt dan jawaban, dan disimpan hingga 30 hari, kecuali hukum mewajibkan lebih lama atau penyimpanan lebih lama dibutuhkan untuk mencegah bahaya. Kontrol Zero Data Retention dan Modified Abuse Monitoring tersedia, tetapi butuh persetujuan OpenAI terlebih dahulu.
Pusat privasi Anthropic menyatakan bahwa secara default, input dan output dari produk komersial seperti Anthropic API tidak dipakai untuk melatih model. Pengecualiannya bila pengguna sengaja mengirim umpan balik atau memilih mengizinkan.
Dari sisi lokasi pemrosesan, halaman harga Anthropic menyebut opsi inference_geo untuk memaksa pemrosesan hanya di Amerika Serikat pada model Claude 4.6 ke atas. Dengan opsi ini, semua harga token dikali 1,1, artinya naik 10 persen. Ini contoh penyedia API menjual kendali lokasi data sebagai fitur berbayar. Halaman yang sama juga menyebut endpoint regional di Amazon Bedrock dan Google Cloud dengan harga tersendiri. Opsi resmi khusus "data diproses di Indonesia" tidak disebut di halaman itu.
Jadi, kapan privasi benar-benar memaksa self-hosted? Menurut saya ada tiga situasi:
- Kontrak atau aturan internal melarang data keluar. Misalnya klien korporat yang menulis di perjanjian bahwa dokumen mereka tidak boleh diproses pihak ketiga. Kebijakan "tidak dilatih" dari penyedia tidak menjawab larangan ini, karena datanya tetap berpindah ke server penyedia.
- Regulasi membatasi transfer data ke luar negeri. Blog n8n mencontohkan GDPR Bab V di Eropa yang mengatur syarat transfer data pribadi ke negara ketiga. Kalau usahamu tunduk pada aturan serupa, cek dulu ke penasihat hukum. Artikel ini tidak membahas detail regulasi Indonesia karena saya belum memverifikasinya ke teks resmi.
- Log 30 hari pun tidak bisa diterima. Untuk data sangat sensitif, retensi log penyalahgunaan bisa jadi masalah, dan kontrol retensi nol tidak otomatis tersedia untuk semua pelanggan.
Di luar tiga situasi itu, sebagian besar data otomasi bisnis kecil masih wajar dikirim ke API. Contohnya email pertanyaan produk, ringkasan rapat, dan klasifikasi tiket. Syaratnya, kamu sudah membaca ketentuan penyedia dan tidak mengirim data yang tidak perlu.
Kemampuan dan perangkat keras: model apa yang realistis
Alasan kedua orang ragu self-hosted adalah kualitas. Model open-weight yang muat di satu GPU biasa umumnya lebih kecil daripada model terkuat di API. Blog n8n menulis bahwa penyedia cloud memberi akses ke model frontier, yaitu model paling mampu saat ini untuk penalaran yang rumit. Bila tugas memang butuh kemampuan itu, tambahan latensi ke cloud bisa sepadan.
Berikut beberapa model open-weight yang dicontohkan n8n, beserta perkiraan VRAM minimum. Parameter (B = miliar) menunjukkan ukuran model. Makin besar, umumnya makin mampu, tetapi makin rakus memori.
| Model | Parameter | VRAM minimum (perkiraan n8n) | Cocok untuk |
|---|---|---|---|
| Phi-4-mini | 3,8B | sekitar 8 GB | Titik awal dengan perangkat terbatas |
| Qwen3 8B | 8B | sekitar 8 GB (konfigurasi 8-bit) | Chat, coding, multibahasa |
| Gemma 3 12B | 12B | 12 sampai 16 GB (terkuantisasi) | Penalaran umum, ringkasan, teks dan gambar |
| DeepSeek R1-Distill-Qwen-14B | 14B | 12 sampai 16 GB (terkuantisasi) | Tugas yang berat di penalaran |
| Mistral Small 3.1 | 24B | 12 sampai 16 GB (4-bit), 44 sampai 55 GB (tanpa kuantisasi) | Function calling, dokumen panjang |
| Llama 4 Scout | 109B total, 17B aktif | 55 sampai 80 GB | Deployment privat kelas atas |
Kuantisasi adalah teknik menyimpan bobot model dengan bit lebih sedikit supaya muat di memori yang lebih kecil. Menurut n8n, kuantisasi sedang umumnya mempertahankan sebagian besar kualitas. Kompresi yang terlalu agresif bisa menurunkan hasil pada tugas rumit seperti penalaran angka. Bila model tidak muat di VRAM, runtime bisa memindahkan sebagian beban ke memori biasa atau CPU, dan jawabannya jadi jauh lebih lambat.
Soal kecepatan, model lokal bisa memberi latensi yang stabil karena tidak ada perjalanan bolak-balik lewat internet. Tetapi n8n juga mengingatkan bahwa model besar di perangkat terbatas bisa jauh lebih lambat daripada layanan cloud yang sudah dioptimasi. Artinya, laptop dengan GPU pas-pasan yang menjalankan model 14B untuk 1.000 email sehari berisiko membuat antrean workflow menumpuk. Ini perkiraan saya dari peringatan n8n tersebut, bukan hasil pengukuran.
Saran n8n yang menurut saya paling praktis: cari dulu model terkecil yang sanggup mengerjakan tugasmu dengan andal, baru pasang di infrastruktur sendiri. n8n menyarankan mencoba model open-weight lewat penyedia seperti OpenRouter dulu, sehingga kamu tidak perlu membeli perangkat keras sebelum tahu modelnya cukup bagus. Naik ke model lebih besar hanya bila hasilnya terbukti membaik untuk workflow itu.
Tugas otomasi yang menurut saya cocok untuk model lokal kecil:
- Klasifikasi pendek: tiket ini keluhan, pertanyaan, atau spam.
- Ekstraksi field dari teks berpola: nama, nomor pesanan, tanggal.
- Deteksi data sensitif sebelum teks diteruskan ke tempat lain.
- Ringkasan pendek dokumen internal yang tidak boleh keluar.
Tugas yang tidak saya sarankan dipaksa ke model lokal kecil: penalaran bertahap yang panjang, agen yang harus memilih banyak tool, analisis dokumen hukum yang panjang, dan penulisan konten untuk publik. Di tugas-tugas itu, selisih kemampuan dengan model API terbaru biasanya paling terasa.
Pola hibrida di n8n: satu workflow, dua jalur
Kalau jawabannya "tergantung permintaan", kamu butuh tempat untuk menaruh aturan pemilihannya. Blog n8n menyarankan aturan itu tidak ditanam di tiap aplikasi, karena akan sulit diperiksa dan diubah saat model dan aturan bertambah. Workflow otomasi adalah tempat yang wajar untuk itu.
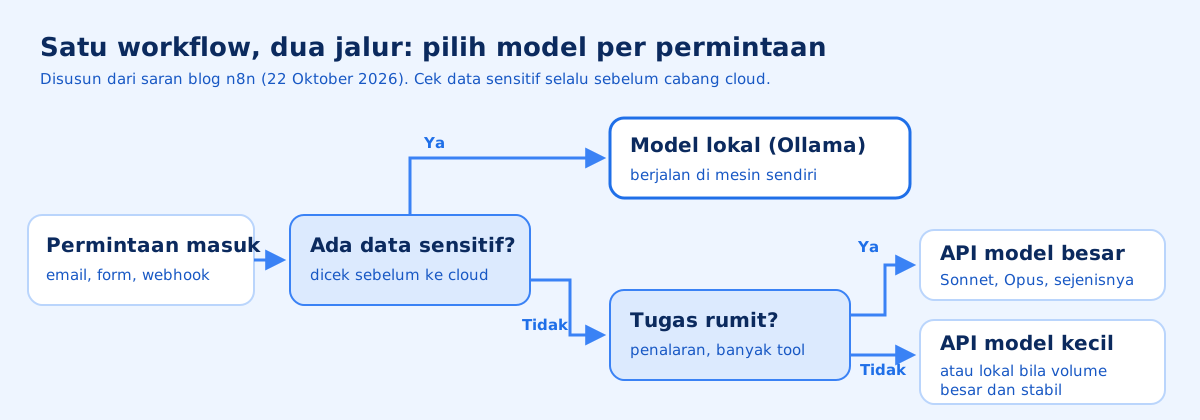
Komponen yang disebut di blog dan dokumentasi n8n:
- Jalur lokal. Node Ollama Chat Model dengan credential Ollama. Menurut dokumentasi credential Ollama, credential ini berisi Base URL server Ollama dan API key opsional untuk proxy yang memakai autentikasi.
- Jalur cloud. Node chat model penyedia API, misalnya OpenAI Chat Model atau Anthropic Chat Model.
- Pemilih model. Node Model Selector memilih salah satu model yang tersambung berdasarkan aturan. Aturannya diperiksa berurutan dan berhenti di aturan pertama yang cocok. Kalau dua aturan sama-sama cocok, hanya yang paling atas yang dipakai.
- Pemisah cabang. Node If untuk dua cabang, atau Switch untuk banyak cabang dengan langkah lanjutan yang berbeda.
Model Selector cocok bila agen atau rantai yang sama hanya perlu berganti otak. If atau Switch cocok bila langkah setelahnya juga berbeda, misalnya jalur lokal menyimpan hasil ke server internal sedangkan jalur cloud boleh menulis ke Google Sheets.
Aturan yang menurut saya paling penting
Blog n8n memberi satu aturan yang sering terlewat: pemeriksaan data sensitif harus dilakukan sebelum permintaan dikirim ke cloud. Bila penentuan sensitif atau tidak butuh AI yang membaca isinya, jalankan pemeriksaan itu secara lokal. Jangan sampai teks rahasia sudah terkirim ke API hanya untuk ditanya "ini rahasia atau bukan?".
Urutan ini menjelaskan kenapa model lokal kecil tetap berguna di arsitektur yang sebagian besar memakai API. Tugasnya bukan menjawab semua permintaan. Tugasnya menjadi penjaga pintu yang murah dan tidak pernah mengirim data ke luar.
Selain itu, n8n menyarankan aturan routing memakai informasi yang sudah ada bila memungkinkan, misalnya penanda sensitivitas, jenis tugas, volume, atau skor kerumitan. Aturan berbasis data yang sudah ada lebih mudah diaudit daripada aturan yang ditentukan AI setiap kali.
Batas yang perlu kamu tahu
Ada beberapa catatan dari dokumentasi n8n yang memengaruhi desain:
- Lokasi n8n menentukan apakah Ollama terjangkau. Default Base URL adalah
http://localhost:11434. Bila n8n dan Ollama berjalan di kontainer Docker terpisah, keduanya perlu berada di jaringan Docker yang sama dan Base URL memakai nama kontainer Ollama. Kesimpulan saya dari situ: n8n Cloud tidak bisa menjangkau Ollama di laptopmu tanpa kamu membuka akses dari internet, dan membuka akses itu punya risiko sendiri. Dokumentasi n8n tidak membahas skenario ini secara khusus. - Contoh model di dokumentasi node terlihat usang. Halaman node Ollama Chat Model masih menyebut model Llama 2 (Llama2, Llama2 13B, Llama2 70B) sebagai pilihan. Rujuk pustaka model Ollama untuk pilihan yang lebih baru, lalu uji sendiri.
- Paket demo bukan untuk produksi. n8n menyediakan paket self-hosted AI berbasis Docker Compose berisi n8n, Ollama, Qdrant, dan PostgreSQL. Dokumentasinya sendiri menyebut paket ini untuk uji coba dan bukti konsep, dan perlu diamankan sebelum dipakai di produksi.
Saya pribadi memilih memulai hibrida dari sisi cloud. Bangun workflow dengan API model kecil dulu, ukur volume dan jenis datanya selama beberapa minggu, lalu pindahkan hanya bagian yang terbukti perlu ke model lokal. Arah sebaliknya, memasang server GPU dulu lalu mencari tugas untuknya, lebih sering berakhir dengan perangkat mahal yang menganggur.
Ringkasan dan langkah berikutnya
Checklist sebelum memilih jalur
- Saya sudah menuliskan jenis tugas AI di workflow saya (klasifikasi, ekstraksi, ringkasan, agen, penulisan)
- Saya sudah memperkirakan volume per bulan dan menghitung biaya API dengan harga resmi terbaru
- Saya sudah membandingkan beberapa ukuran model API, bukan hanya model paling mahal
- Saya tahu data apa saja yang dikirim ke model, dan sudah membuang yang tidak perlu
- Saya sudah membaca kebijakan data penyedia API yang saya pakai
- Bila ada data yang dilarang keluar, pemeriksaannya dilakukan sebelum cabang cloud
- Bila memilih self-hosted, ada orang yang bertanggung jawab merawat server dan modelnya
- Kedua jalur sudah diuji dengan kasus nyata, termasuk satu kasus sensitif
Cheat sheet
| Situasi | Pilihan yang saya sarankan |
|---|---|
| Volume kecil atau belum pasti | API model kecil seperti Haiku 5.5 atau gpt-6-luna |
| Tugas butuh penalaran rumit atau agen dengan banyak tool | API model besar |
| Pekerjaan berkala yang tidak perlu dijawab seketika | Batch API (diskon 50 persen di Anthropic) atau GPU sewaan yang dinyalakan saat perlu |
| Data dilarang keluar jaringan oleh kontrak atau aturan | Model lokal lewat Ollama atau vLLM, dengan n8n self-hosted |
| Volume besar, stabil, dan tugasnya sederhana | Hitung titik impas, lalu pertimbangkan model lokal |
| Campuran semua di atas | Workflow hibrida dengan Model Selector, If, atau Switch |
Kalau kamu ingin belajar menyusun workflow n8n secara runtut sebelum menambahkan jalur kedua, cek Kelas Automation di daftar Kelas eduwebmu. Setelah itu, coba tulis ulang satu workflow AI milikmu dengan dua jalur, lalu bandingkan hasil dan biayanya selama sebulan.
Pertanyaan yang sering diajukan
Apakah LLM self-hosted selalu lebih murah daripada API?
Tidak. Untuk volume kecil atau tidak menentu, API model kecil biasanya lebih hemat karena kamu hanya membayar token yang terpakai. Self-hosted mulai masuk akal saat volumenya besar dan stabil sehingga biaya perangkat keras dan perawatan tersebar ke banyak permintaan.
Apakah data yang saya kirim lewat API dipakai untuk melatih model?
Menurut kebijakan resmi OpenAI dan Anthropic, data dari API tidak dipakai untuk melatih model secara default. Namun OpenAI tetap menyimpan log pemantauan penyalahgunaan hingga 30 hari, kecuali pelanggan disetujui untuk kontrol retensi khusus.
Berapa VRAM yang dibutuhkan untuk menjalankan model sendiri?
Tergantung ukuran model. Tabel di blog n8n menyebut sekitar 8 GB untuk model kecil seperti Phi-4-mini atau Qwen3 8B, dan 55 sampai 80 GB untuk Llama 4 Scout.
Apakah node Ollama di n8n bisa dipakai di n8n Cloud?
Credential Ollama di n8n hanya butuh Base URL dan API key opsional, jadi n8n harus bisa menjangkau alamat server Ollama kamu. Untuk Ollama yang jalan di laptop atau jaringan internal, pola yang paling lurus adalah n8n self-hosted di jaringan yang sama.
Apakah memakai Ollama berarti data pasti tetap di komputer saya?
Belum tentu. Ollama kini juga menjual akses model cloud dengan bayar per token, dan menurut halaman harganya model cloud itu di-host terutama di Amerika Serikat. Pastikan model yang dipanggil workflow memang berjalan di mesin milikmu.
Bagaimana n8n memilih model lokal atau cloud dalam satu workflow?
Bisa lewat node Model Selector yang memeriksa aturan berurutan dan memakai model dari aturan pertama yang cocok. Untuk cabang workflow yang lebih besar, n8n menyarankan node If atau Switch.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.n8n Blog, "Self-Hosted LLM vs. Cloud APIs: How to Route Between Them" (22 Oktober 2026)blog.n8n.io(buka di tab baru)
- 2.n8n Docs, "Ollama Chat Model"docs.n8n.io(buka di tab baru)
- 3.n8n Docs, "Ollama Chat Model common issues"docs.n8n.io(buka di tab baru)
- 4.n8n Docs, "Ollama credentials"docs.n8n.io(buka di tab baru)
- 5.n8n Docs, "Model Selector"docs.n8n.io(buka di tab baru)
- 6.n8n Docs, "Deploy with the AI starter kit"docs.n8n.io(buka di tab baru)
- 7.Anthropic, "Pricing" (Claude Platform Docs)platform.claude.com(buka di tab baru)
- 8.OpenAI, "Pricing" (OpenAI API Docs)platform.openai.com(buka di tab baru)
- 9.OpenAI, "Data controls in the OpenAI platform"platform.openai.com(buka di tab baru)
- 10.Anthropic Privacy Center, "Is my data used for model training?"privacy.claude.com(buka di tab baru)
- 11.Ollama, berandaollama.com(buka di tab baru)
- 12.Ollama, "Pricing"ollama.com(buka di tab baru)
- 13.Ollama, "Models" (pustaka model)ollama.com(buka di tab baru)
- 14.vLLM Docsdocs.vllm.ai(buka di tab baru)
llmself-hostedollaman8notomasi