Menguji aplikasi hasil vibe coding dengan bantuan AI
Oleh Dedi NugrohoTerbit 17 menit baca
Daftar isi
Menguji aplikasi hasil vibe coding dengan bantuan AI berarti meminta agent menjalankan alur pengguna yang kamu tulis dalam bahasa sehari-hari, lalu memeriksa bukti hasilnya. Ada dua jalur utama: AI yang menulis kode tes untukmu, seperti test agent Playwright, dan AI yang langsung menjalankan tes dari niat, seperti Amazon Nova Act. Keduanya tetap butuh pengawasan manusia.
Tesis artikel ini: kecepatan vibe coding baru aman kalau kecepatan mengujinya ikut naik. Kalau aplikasi bisa kamu bangun dalam satu sore, tetapi mengeceknya masih dengan mengklik manual setiap kali ada perubahan, kamu akan berhenti mengecek. Saat itulah bug mulai menumpuk diam-diam. AI bisa menutup celah itu, asalkan kamu tahu apa yang ia buktikan dan apa yang tidak.
Yang perlu diluruskan dulu
Vibe coding adalah cara membangun aplikasi dengan menyuruh AI menulis kode lewat bahasa sehari-hari, sering tanpa membaca kodenya baris per baris. Cara ini mempercepat pembuatan. Yang sering terlupa, cara ini juga menghapus satu lapis pengaman lama: dulu, orang yang menulis kode setidaknya pernah membaca kodenya sendiri.
Ada tiga salah kaprah yang perlu diluruskan sebelum masuk ke alatnya.
Pertama, "AI-nya sudah bilang semua fitur jalan." Kalimat dari coding agent itu ringkasan, belum bukti. Agent bisa saja hanya memeriksa bahwa kode tidak error saat dijalankan, tanpa pernah membuka halaman seperti pengguna.
Kedua, "Tes itu urusan perusahaan besar." Justru proyek kecil yang paling rentan. Satu orang membangun, satu orang mengecek, dan orangnya sama. Kalau kamu tidak punya waktu mengklik ulang semua alur setelah setiap perubahan, tes otomatis adalah satu-satunya pengecek yang tidak lelah.
Ketiga, "Kalau pakai AI tester, saya tidak perlu paham apa-apa." Ini yang paling berbahaya. Tester AI hanya menguji apa yang kamu minta. Kalau aturan bisnisnya tidak kamu tulis, tidak ada yang mengujinya.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Kenapa mudah rusak diam-diam | Apa yang membuat aplikasi hasil vibe coding rapuh? |
| Dua cara AI membantu menguji | Apa beda AI yang menulis tes dengan AI yang menjalankan tes? |
| Pelajaran dari tim yang sudah memakainya | Apa yang dilaporkan Epsilon, First Orion, dan QA Studio? |
| Memilih jalur untuk proyekmu | Mana yang cocok untuk kondisi saya? |
| Batas dan jebakan | Kapan tes AI bisa menyesatkan? |
| Ringkasan | Apa yang dikerjakan minggu ini? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Fakta tentang Amazon Nova Act, QA Studio, dan studi kasus pelanggannya diambil dari blog resmi AWS dan halaman produk AWS. Angka hasil di studi kasus itu adalah benchmark internal perusahaan pelanggan yang dimuat di blog vendor, jadi saya tulis sebagai klaim, belum sebagai fakta netral. Fakta Playwright diambil dari dokumentasi resminya. Harga Nova Act tidak dibahas karena berubah-ubah dan sebaiknya kamu cek langsung di halaman harga resmi AWS. Artikel ini juga bukan panduan instalasi.
Artikel ini untuk kamu yang membangun aplikasi web dengan coding agent, baik untuk bisnis sendiri, klien, atau proyek sampingan, dan mulai khawatir setiap kali menambah fitur. Artikel ini kurang cocok kalau kamu mencari langkah teknis menyiapkan framework tes. Untuk itu, dokumentasi resmi alat yang kamu pilih tetap rujukan terbaik.
Kenapa aplikasi hasil vibe coding mudah rusak diam-diam
Masalah utamanya bukan kualitas kode AI. Masalahnya ada pada cara kerja kita saat vibe coding: perubahan datang cepat, dalam potongan besar, dan jarang dibaca utuh.
Bayangkan kamu meminta agent "rapikan tampilan halaman checkout". Agent mengganti struktur halaman, memindahkan tombol, dan mengganti nama beberapa komponen. Tampilannya memang lebih rapi. Namun ada satu hal kecil yang ikut berubah: kode kupon diskon kini tidak terkirim ke server. Tidak ada pesan error. Pelanggan hanya membayar harga penuh, lalu marah.
Bug seperti ini disebut regresi, yaitu fitur yang tadinya berjalan menjadi rusak karena perubahan di tempat lain. Cara klasik menangkap regresi adalah tes otomatis yang menjalankan ulang alur penting setiap kali kode berubah.
Tes klasik punya masalah sendiri
Tes UI klasik bekerja dengan alamat elemen di halaman. Alamat ini disebut selector, yaitu penunjuk teknis seperti "tombol dengan kelas tertentu di dalam kotak tertentu". Tes menyuruh browser mengklik selector itu, lalu memeriksa hasilnya.
Di sinilah tabrakannya dengan vibe coding. Agent AI suka menulis ulang struktur halaman. Setiap kali struktur berubah, selector ikut berubah, dan tes gagal walaupun fiturnya sebenarnya baik-baik saja. Lama-lama kamu lelah memperbaiki tes yang "gagal palsu", lalu mematikannya. Sejak itu aplikasimu berjalan tanpa jaring pengaman.
Masalah ini tidak hanya dialami pembuat aplikasi sendirian. Dalam tulisan resmi AWS tentang QA Studio, tim AWS menyebut framework otomasi bergantung pada detail implementasi seperti selector UI. Akibatnya tes rusak saat developer merapikan kode atau desainer mengubah tata letak, padahal fungsinya tetap utuh. First Orion, perusahaan layanan komunikasi bermerek, melaporkan hal serupa: ID elemen dan atribut halaman berubah lebih cepat daripada kemampuan tim QA memperbaiki skrip Selenium dan Playwright mereka.
Kalau tim QA profesional saja kewalahan, wajar kalau kamu yang membangun sendirian juga kewalahan.
Niat lebih awet daripada alamat
Gagasan yang muncul dari masalah ini sederhana: tulis tes sebagai niat, jangan sebagai mekanik. Niat adalah apa yang ingin dibuktikan, misalnya "pastikan saldo poin terlihat". Mekanik adalah cara teknis membuktikannya, misalnya "cari elemen dengan selector sekian, lalu periksa apakah terlihat".
Niat jarang berubah. Selama aplikasimu masih punya fitur saldo poin, kalimat "pastikan saldo poin terlihat" tetap benar, di mana pun tombolnya dipindah. Inilah yang membuat AI menarik untuk pengujian: model yang bisa "melihat" layar dapat menerjemahkan niat menjadi klik pada saat tes dijalankan.
Dua cara AI membantu menguji aplikasi
Kalau dilihat dari dokumentasi resmi Playwright dan AWS, bantuan AI untuk pengujian UI terbagi menjadi dua jalur besar. Keduanya sama-sama memakai AI, tetapi menghasilkan benda yang berbeda.
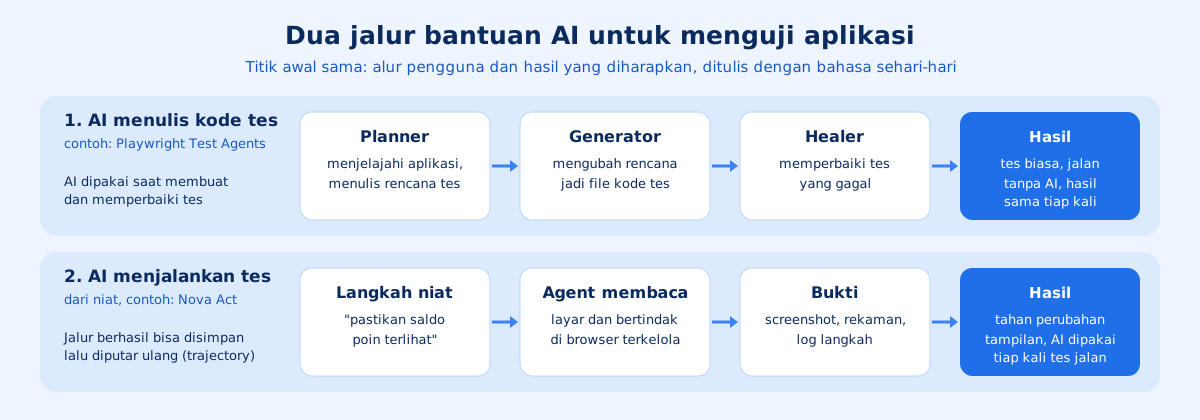
Jalur pertama: AI yang menulis kode tes
Di jalur ini, AI membantu menghasilkan tes biasa. Setelah jadi, tes berjalan tanpa AI, cepat, dan hasilnya sama setiap kali.
Contoh yang paling jelas adalah Playwright Test Agents. Playwright adalah framework populer untuk mengotomasi browser dalam pengujian. Dokumentasinya menyebut tiga agent bawaan:
- Planner menjelajahi aplikasi dan menghasilkan rencana tes dalam format Markdown. Ia bisa diberi dokumen PRD (dokumen kebutuhan produk) sebagai konteks.
- Generator mengubah rencana itu menjadi file tes Playwright, sambil memeriksa selector dan asersinya secara langsung di aplikasi.
- Healer menjalankan tes, dan saat ada yang gagal, mencari elemen pengganti di tampilan terbaru lalu mengusulkan perbaikan.
Dokumentasinya menyediakan pemasangan agent ini untuk VS Code, Claude Code, Codex, dan OpenCode. Artinya, kalau kamu sudah vibe coding dengan salah satu alat itu, jalur ini paling dekat dengan cara kerjamu sekarang.
Ada pula alat yang lebih tua dan lebih sederhana, yaitu test generator Playwright atau codegen. Kamu mengklik aplikasi seperti biasa, dan Playwright mencatat klik itu menjadi kode tes. Menurut dokumentasinya, codegen memilih locator berdasarkan peran elemen, teks, dan test id. Pilihan ini membuat tes lebih tahan terhadap perubahan kecil dibanding selector berbasis kelas CSS.
Kelebihan jalur ini: hasil akhirnya kode tes biasa. Kamu bisa menjalankannya ribuan kali tanpa biaya model AI, menyimpannya di repositori, dan membacanya kapan pun. Kekurangannya: tes tetap terikat pada locator, jadi tetap bisa patah saat tampilan berubah besar. Healer membantu, tetapi perbaikannya tetap perlu kamu tinjau.
Jalur kedua: AI yang menjalankan tes dari niat
Di jalur ini, tes tidak pernah menjadi kode selector. Langkah tesnya tetap berupa kalimat, dan agent AI membaca layar setiap kali tes berjalan.
Contoh yang paling banyak didokumentasikan saat ini adalah Amazon Nova Act. Halaman produknya menyebut Nova Act sebagai layanan AWS untuk membangun agent yang mengotomasi alur kerja di antarmuka browser. Mesinnya model khusus Nova 2 Lite, dan agent-nya disusun dengan campuran bahasa sehari-hari dan kode Python. Pengujian web end-to-end adalah salah satu kegunaan yang disebut di halaman itu.
Dalam praktik, tes berbentuk daftar langkah seperti "isi nama dan deskripsi agent", lalu "kalau muncul kotak tur pengenalan, pilih lewati". Nova Act melihat halaman, menentukan elemen mana yang dimaksud, lalu bertindak. Browser-nya bisa disediakan oleh Amazon Bedrock AgentCore Browser, layanan browser terkelola dari AWS, sehingga kamu tidak perlu merawat server browser sendiri.
Kelebihan jalur ini: tes lebih tahan terhadap perubahan tampilan, dan bisa ditulis atau ditinjau orang yang tidak menulis kode. Kekurangannya: setiap langkah melibatkan model AI, jadi ada biaya dan waktu tambahan. Selain itu, AI bisa memilih jalan berbeda di dua kali percobaan. Bagian berikutnya menunjukkan bagaimana tim nyata menangani masalah ini.
Perbandingan singkat
| Aspek | AI menulis kode tes (contoh: Playwright Test Agents) | AI menjalankan tes dari niat (contoh: Amazon Nova Act) |
|---|---|---|
| Bentuk tes | File kode tes Playwright | Daftar langkah dalam bahasa sehari-hari |
| AI dipakai saat | Membuat dan memperbaiki tes | Setiap kali tes dijalankan (replay trajectory mengurangi kerja model) |
| Tahan perubahan tampilan | Sedang, bergantung kualitas locator | Lebih tahan, karena agent membaca layar |
| Hasil berulang | Sama setiap kali | Bisa beda jalur, perlu teknik tambahan |
| Siapa bisa menulis | Perlu orang yang bisa membaca kode | Bisa ditulis orang nonteknis |
| Cocok untuk | Proyek kecil sampai menengah, satu tim | Banyak tim, banyak aplikasi, sudah di AWS |
Pelajaran dari tim yang sudah memakainya
Empat tulisan di blog machine learning AWS memberi gambaran paling konkret tentang pengujian berbasis niat di lingkungan produksi. Ingat, ini blog vendor, dan semua angka hasil di bawah adalah klaim dari benchmark internal pelanggan.
Epsilon: niat di atas Playwright, bukan pengganti
Tulisan Building intent-driven UI testing with Amazon Nova Act (29 Oktober 2026) membahas Epsilon, perusahaan data dan layanan pemasaran di bawah Publicis Groupe. Bagian yang paling saya sukai ada di awal: tim mereka menyebut praktik tes UI lama mereka tidak rusak. Suite regresi berbasis Playwright tetap menjadi tulang punggung. Tes berbasis niat ditambahkan di atasnya.
Ini pendekatan yang sehat, dan saya sarankan kamu tiru. Jangan buang tes yang sudah jalan hanya karena ada cara baru.
Beberapa praktik dari tulisan itu yang relevan untuk pembuat aplikasi skala kecil:
- Tulis langkah sebagai niat. Contoh mereka: "Confirm the rewards balance is visible", dibandingkan dengan baris kode panjang berisi selector.
- Tangani kondisi dengan kalimat. Langkah seperti "kalau kotak tur muncul, pilih lewati" atau "kalau kotak pencarian belum terlihat, gulir sampai muncul" biasanya butuh percabangan kode di framework klasik.
- Simpan jalur yang berhasil. Epsilon menyimpan trajectory, yaitu catatan langkah yang diambil agent saat tes lulus, lalu memutarnya ulang untuk tes berikutnya. Menurut mereka, cara ini memangkas "proses berpikir" model yang berulang, sehingga lebih cepat dan lebih murah.
- Ambil screenshot di setiap langkah. Dengan begitu, saat tes gagal, kamu langsung melihat di langkah mana dan seperti apa layarnya.
Angka yang mereka laporkan: satu alur 18 langkah butuh 5 sampai 10 menit untuk ditulis dengan Nova Act. Skrip Playwright setaranya butuh 30 sampai 90 menit, dengan panjang sekitar 80 sampai 150 baris kode. Mereka menyebutnya penulisan tes 4 sampai 6 kali lebih cepat, berdasarkan benchmark internal Epsilon. Trajectory yang disimpan juga dilaporkan lulus 100 persen saat diputar ulang, setelah fase eksplorasi yang biasanya butuh 4 sampai 5 kali perbaikan prompt.
Angka 100 persen itu perlu dibaca hati-hati. Itu tingkat lulus saat memutar ulang jalur yang sudah terbukti berhasil. Itu tidak berarti agent selalu benar saat pertama kali menjelajah.
First Orion: agent tidak tahu aturan yang tidak ditulis
Tulisan First Orion accelerates QA automation using Amazon Nova Act (11 Agustus 2026) bercerita tentang tim QA yang kewalahan karena aplikasi web mereka bertambah banyak. Mereka membangun antarmuka tempat analis QA menulis kasus uji dalam bahasa Inggris biasa, lalu Nova Act menjalankannya.
Hasil yang mereka klaim: siklus QA berkurang hingga 20 sampai 25 persen untuk jenis pengujian tertentu. Mereka juga memperkirakan hemat waktu engineering 25 sampai 30 persen, dan cakupan tes naik lebih dari 15 persen di beberapa kasus.
Bagian yang lebih berguna buat kita justru bagian pelajarannya. Tiga hal yang mereka akui terus terang:
- Jalur navigasi awalnya tidak konsisten. Dengan kondisi awal yang sama, Nova Act bisa sampai ke tujuan lewat jalan yang berbeda. Mereka memperbaikinya dengan menyetel parameter di SDK.
- Prompt tetap perlu disetel. Kasus uji dalam bahasa Inggris tidak otomatis bekerja baik. Mereka mengikuti panduan struktur prompt dari dokumentasi AWS.
- Agent tidak punya pengetahuan institusi. Prasyarat yang tidak diucapkan, pola navigasi, dan aturan bisnis harus ditulis eksplisit di kasus uji.
Poin ketiga itu menurut saya kalimat terpenting di seluruh studi kasus. Agent AI tidak tahu bahwa kupon diskon hanya berlaku untuk pembelian di atas nominal tertentu, kecuali kamu menuliskannya.
QA Studio: menguji saja belum cukup, perlu tahu kesehatannya
AWS juga merilis QA Studio, solusi referensi yang dibangun dengan Nova Act dan dipasang di akun AWS milik pengguna. Bagian pertama serinya (31 Maret 2026) menjelaskan dasarnya. Tes ditulis dalam bahasa sehari-hari dan bisa dihasilkan dari deskripsi perjalanan pengguna lewat Amazon Bedrock. Data rahasia saat pengisian formulir diambil dari AWS Secrets Manager. Setiap eksekusi menyimpan rekaman, hasil, dan log trajectory dengan screenshot.
Bagian ketiganya (28 Oktober 2026) membahas apa yang terjadi saat tes sudah banyak. Ada dua ide yang bisa kamu pinjam walaupun tidak memakai AWS sama sekali:
- Skor kesehatan yang menghukum tes plin-plan. QA Studio menghitung skor 0 sampai 100 dari tingkat lulus, lalu menguranginya dengan penalti untuk tes flaky. Flaky adalah tes yang kadang lulus kadang gagal tanpa ada perubahan kode. Dengan begitu, aplikasi yang tesnya lulus tetapi sering berganti hasil tidak terlihat sempurna palsu.
- Daftar tes flaky tujuh hari terakhir. Tes diurutkan berdasarkan seberapa sering hasilnya berbalik. Tujuannya menemukan kegagalan sesekali sebelum berubah menjadi masalah di produksi.
QA Studio juga punya pembagian akses per tim dengan lima peran, dari Admin sampai Viewer. Untuk pembuat aplikasi sendirian, bagian ini belum relevan. Untuk agensi kecil yang memegang aplikasi beberapa klien, idenya mulai berguna.
Memilih jalur untuk proyekmu
Saya tidak akan bilang satu jalur lebih baik untuk semua orang. Yang saya pakai sebagai patokan adalah tiga pertanyaan: siapa yang menulis tes, seberapa sering tampilan berubah, dan di mana aplikasimu berjalan.
Kalau kamu membangun sendirian
Pilihan saya: mulai dari AI yang menulis kode tes. Minta coding agent yang sudah kamu pakai membuat tes Playwright untuk tiga sampai lima alur terpenting, atau pakai Playwright Test Agents bila alatmu didukung. Alasannya praktis. Tes jadi berjalan gratis, cepat, dan hasilnya sama setiap kali. Kamu juga tidak menambah satu layanan cloud baru yang harus dipahami.
Yang tidak saya sarankan adalah meminta agent yang sama menulis fitur sekaligus menulis tes dalam satu permintaan, lalu langsung percaya. Risikonya, agent menulis tes yang cocok dengan kode yang baru ia tulis, termasuk kesalahannya. Tulis dulu skenario dan hasil yang diharapkan dengan bahasamu sendiri, baru minta agent mengubahnya menjadi tes.
Kalau kamu bersama tim kecil dengan anggota nonteknis
Di sini nilai tes berbasis niat mulai terasa. Pemilik produk atau admin operasional bisa menulis dan meninjau langkah seperti "masuk sebagai pelanggan, tambahkan dua barang, pakai kupon, pastikan total turun". Mereka paling tahu aturan bisnisnya.
Kamu tidak harus langsung memakai layanan terkelola. Langkah pertamanya bisa sesederhana menyimpan skenario berbahasa sehari-hari di satu dokumen bersama, lalu developer mengubahnya menjadi tes. Itu sudah menangkap separuh manfaat: aturan bisnis tertulis dan bisa ditinjau.
Kalau kamu sudah di AWS dan memegang banyak aplikasi
Nova Act dan QA Studio layak dicoba. Epsilon memilih AgentCore Browser Tool justru karena tidak mau merawat file browser, server tampilan, dan siklus sesi sendiri. Autentikasi lewat IAM dan jejak audit CloudTrail juga memudahkan urusan izin dan audit. Pastikan kamu memeriksa harga dan kuota di halaman resmi AWS sebelum memutuskan, karena bagian itu tidak saya bahas di sini.
Pola yang saya sarankan untuk hampir semua orang
Gabungkan keduanya secara bertahap, mengikuti contoh Epsilon:
- Tes kode biasa untuk alur yang stabil dan kritis, misalnya masuk dan pembayaran.
- Tes berbasis niat untuk alur yang tampilannya sering berubah atau yang ingin ditinjau orang nonteknis.
- Rekaman dan screenshot sebagai bukti, apa pun jalurnya.
Batas dan jebakan pengujian dengan AI
Hype soal "AI tester" sering menutupi batasnya. Ini lima jebakan yang paling relevan untuk pembuat aplikasi kecil.
Lulus belum tentu benar
Tes berbasis niat menguji apa yang kamu tulis. Kalau kamu menulis "pastikan halaman konfirmasi muncul", agent akan lulus saat halaman itu muncul, walaupun totalnya salah hitung. Tulis hasil yang diharapkan sespesifik mungkin, termasuk angka, teks, dan status.
Masalah serupa ada di jalur pertama. Dokumentasi Playwright menyebut healer akan mengembalikan tes yang lulus, atau tes yang dilewati bila ia menilai fungsinya memang rusak. Itu perilaku yang masuk akal. Namun tetap tinjau setiap perbaikan healer, karena perbaikan locator yang terlalu longgar bisa membuat tes lulus pada elemen yang salah.
Hasil bisa berbeda di setiap percobaan
Model AI tidak selalu mengambil jalan yang sama. First Orion mengalaminya, dan Epsilon menjawabnya dengan memutar ulang trajectory yang sudah terbukti. Kalau kamu memakai agent untuk menjalankan tes, siapkan cara memastikan hasilnya konsisten sebelum menjadikannya syarat rilis.
Ada biaya di setiap eksekusi
Di jalur kedua, model bekerja setiap kali tes berjalan. Semakin sering tes dijalankan, semakin terasa biayanya. Teknik replay trajectory dari Epsilon ada justru untuk menekan biaya dan waktu pada eksekusi berulang. Untuk proyek kecil, ini alasan kuat memulai dari jalur pertama.
Data dan kredensial
Tes yang masuk ke aplikasi butuh akun. Jangan menulis kata sandi asli di dalam skenario. QA Studio memakai AWS Secrets Manager untuk ini. Di alat lain, pakai akun uji khusus dengan data palsu, terpisah dari akun pelanggan.
Tes tidak menggantikan cek keamanan
Tes UI membuktikan alur pengguna berjalan. Tes UI tidak membuktikan aplikasimu aman dari akses yang tidak sah, kebocoran data, atau celah di server. Untuk aplikasi yang menyimpan data orang lain, pengecekan keamanan tetap pekerjaan terpisah.
Ringkasan dan langkah berikutnya
Vibe coding mempercepat membangun. Pengujian dengan bantuan AI mempercepat membuktikan. Mulailah dari sedikit alur yang paling mahal kalau rusak, tulis niatnya dengan bahasamu sendiri, lalu pilih apakah AI akan mengubahnya menjadi kode tes atau menjalankannya langsung.
Checklist minggu ini
- Menuliskan tiga sampai lima alur pengguna paling kritis dalam bahasa sehari-hari
- Setiap alur punya hasil yang diharapkan yang spesifik, termasuk angka atau teks
- Aturan bisnis yang "semua orang tahu" sudah ditulis eksplisit di skenario
- Ada akun uji dan data palsu, terpisah dari akun pelanggan
- Skenario sudah diubah menjadi tes otomatis, lewat kode tes atau agent
- Setiap eksekusi menyimpan bukti: screenshot, rekaman, atau log langkah
- Tes dijalankan setiap kali coding agent selesai mengubah kode
- Ada catatan tes flaky, dan tes flaky diperbaiki atau dimatikan dengan sengaja
Cheat sheet
| Kondisi | Pilihan awal yang saya sarankan |
|---|---|
| Membangun sendirian, aplikasi kecil | Coding agent atau Playwright Test Agents menulis kode tes |
| Ingin merekam alur tanpa menulis kode | Test generator (codegen) Playwright, lalu rapikan hasilnya |
| Ada anggota tim nonteknis | Skenario niat di dokumen bersama, ditinjau mereka |
| Tampilan berubah hampir setiap minggu | Tes berbasis niat untuk alur yang paling sering berubah |
| Sudah di AWS, banyak aplikasi dan tim | Coba Amazon Nova Act dan QA Studio |
| Alur stabil dan kritis seperti pembayaran | Tetap pakai kode tes biasa sebagai tulang punggung |
Langkah berikutnya yang paling berguna justru terjadi sebelum kode ditulis. Tes yang baik lahir dari daftar fitur dan alur pengguna yang jelas. AI MVP Generator di eduwebmu bisa membantumu memetakan fitur inti dan alur pengguna dari ide aplikasimu. Ambil alur dari hasilnya, tulis hasil yang diharapkan untuk masing-masing, dan jadikan itu daftar tes pertamamu.
Pertanyaan yang sering diajukan
Apakah aplikasi hasil vibe coding perlu diuji kalau AI-nya sudah bilang kodenya jalan?
Perlu. Pernyataan AI bahwa kodenya jalan bukan bukti. Yang jadi bukti adalah tes yang mengulang alur pengguna nyata dan hasilnya bisa kamu lihat sendiri.
Apa bedanya tes berbasis niat dengan tes biasa?
Tes biasa menulis langkah teknis, misalnya klik elemen dengan alamat tertentu di halaman. Tes berbasis niat menulis tujuan dalam bahasa sehari-hari, misalnya pastikan saldo poin terlihat, lalu agent AI mencari sendiri caranya di layar.
Apakah saya harus memakai Amazon Nova Act untuk menguji aplikasi?
Tidak harus. Nova Act cocok untuk tim yang sudah memakai AWS dan butuh layanan terkelola. Untuk proyek kecil, test agent bawaan Playwright yang menghasilkan kode tes biasa sering lebih masuk akal.
Apakah tes yang dijalankan AI bisa lulus padahal aplikasinya salah?
Bisa. Agent bisa mencapai tujuan lewat jalur yang berbeda, atau penulis tes lupa menyebut aturan bisnis yang penting. Karena itu hasil tes tetap perlu dicek lewat rekaman, screenshot, atau log langkah.
Saya bukan programmer. Bisakah saya menulis tes untuk aplikasi saya?
Bisa untuk tahap skenario. Kamu cukup menulis alur pengguna dan hasil yang diharapkan dalam bahasa sehari-hari. Bagian menjalankan dan merawat tes di CI biasanya tetap butuh orang yang paham teknis.
Berapa banyak tes yang perlu dibuat untuk MVP?
Mulai dari tiga sampai lima alur paling kritis, misalnya daftar, masuk, dan transaksi utama. Tambah tes setiap kali menemukan bug, supaya bug yang sama tidak kembali.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.AWS Machine Learning Blog, "Building intent-driven UI testing with Amazon Nova Act" (29 Oktober 2026)aws.amazon.com(buka di tab baru)
- 2.AWS Machine Learning Blog, "Accelerating software delivery with agentic QA automation using Amazon Nova Act, Part 3" (28 Oktober 2026)aws.amazon.com(buka di tab baru)
- 3.AWS Machine Learning Blog, "Accelerating software delivery with agentic QA automation using Amazon Nova Act" (31 Maret 2026)aws.amazon.com(buka di tab baru)
- 4.AWS Machine Learning Blog, "First Orion accelerates QA automation using Amazon Nova Act" (11 Agustus 2026)aws.amazon.com(buka di tab baru)
- 5.AWS, halaman produk Amazon Nova Actaws.amazon.com(buka di tab baru)
- 6.Playwright Docs, "Playwright Test Agents"playwright.dev(buka di tab baru)
- 7.Playwright Docs, "Generating tests" (test generator)playwright.dev(buka di tab baru)
vibe codingpengujianAI agentQA