Mistral Large 4 open-weight: apa artinya bagi pengguna Indonesia
Oleh Dedi NugrohoTerbit 10 menit baca
Daftar isi
Mistral Large 4 adalah model AI terbesar Mistral, sekitar 1 triliun parameter, yang bobotnya dirilis terbuka pada 29 Oktober 2026. Kamu boleh mengunduh, memodifikasi, dan memakainya untuk bisnis, kecuali menjual akses model sebagai layanan tanpa lisensi tambahan. Untuk kebanyakan pengguna Indonesia, jalur paling realistis tetap API atau penyedia cloud, karena menjalankannya sendiri butuh server GPU kelas pusat data.
Tesis artikel ini: open-weight itu soal kendali dan pilihan, dan sama sekali tidak berarti gratis. Rilis ini penting bagi tim yang butuh data tetap di server sendiri, misalnya instansi atau perusahaan dengan aturan kerahasiaan ketat. Bagi pekerja kantoran, pebisnis kecil, atau pembuat konten, dampaknya tidak langsung: harga API yang lebih bersaing dan lebih banyak penyedia yang bisa menyajikan model ini.
Yang perlu diluruskan dulu
Istilah open-weight sering disamakan dengan open source. Open-weight artinya file bobot model (angka-angka hasil pelatihan yang membentuk "otak" model) boleh diunduh dan dijalankan sendiri. Data pelatihan dan resep lengkapnya belum tentu ikut dibuka. Mistral sendiri menyebut laporan teknis lengkap baru akan menyusul.
Kesalahpahaman kedua: model terbuka berarti bisa dipasang di komputer rumahan. Untuk model sebesar ini, anggapan itu meleset jauh, dan bab tentang server di bawah menjelaskan kenapa.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Isi rilisnya | Model seperti apa yang sebenarnya dibuka? |
| Lisensi | Apa yang boleh dan tidak boleh dilakukan dengan bobotnya? |
| Kebutuhan server | Seberapa berat menjalankannya sendiri? |
| Tiga jalur pemakaian | Lewat jalur mana sebaiknya mulai mencoba? |
| Bahasa Indonesia dan klaim benchmark | Seberapa jauh angka resmi bisa dipercaya? |
| Ringkasan | Apa langkah konkret berikutnya? |
Catatan jujur. Artikel ini ditulis 2 November 2026, empat hari setelah bobot dirilis. Semua fakta diambil dari pengumuman resmi Mistral tertanggal 29 Oktober 2026, model card di Hugging Face, dokumentasi Mistral, dan blog Hugging Face. Artikel ini tidak memuat uji mandiri, jadi semua angka performa di sini adalah klaim vendor. Laporan teknis lengkap belum terbit, sehingga sebagian detail bisa berubah.
Artikel ini untuk kamu yang memakai AI untuk kerja atau bisnis dan ingin tahu apakah perlu melirik Mistral. Panduan teknis memasang model di server tidak dibahas di sini.
Isi rilis Mistral Large 4 dalam angka
Menurut model card resmi di Hugging Face, Mistral Large 4 adalah model Mixture-of-Experts (MoE). MoE adalah arsitektur yang membagi model menjadi banyak "ahli" kecil, lalu hanya memanggil sebagian untuk setiap potongan teks. Hasilnya, model berukuran raksasa tidak perlu menghitung seluruh parameternya setiap saat.
Angka pentingnya:
- Total sekitar 1 triliun parameter, dengan 49 miliar parameter aktif per token (52 miliar bila lapisan embedding dan output ikut dihitung).
- 128 ahli, empat dipilih per token, ditambah satu ahli bersama yang selalu aktif.
- Jendela konteks 1 juta token. Konteks adalah jumlah teks yang bisa "dibaca" model sekaligus dalam satu permintaan.
- Menerima teks dan gambar, keluarannya teks. Menurut dokumentasi Mistral dan blog Hugging Face, pembaca gambarnya berupa encoder Pixtral berukuran 1,6 miliar parameter.
- Tiga tingkat penalaran: low, medium, dan high sebagai default.
Satu detail yang sering terlewat: penalaran tidak bisa dimatikan. Pengumuman Mistral menyebut mode low kini menggantikan mode None. Menurut blog Hugging Face, meminta tingkat "none" tetap dijalankan sebagai high. Mistral menyarankan low untuk balasan obrolan cepat, medium untuk tugas harian, dan high untuk tugas rumit atau agen. Pilihan ini berpengaruh ke biaya. Model card mencatat batas token keluaran ikut mencakup token penalaran, dan Mistral sendiri menyebut tiga mode ini sebagai cara mengatur tarik-ulur antara performa dan biaya.
Linimasanya juga perlu diluruskan. Halaman model di dokumentasi Mistral mencatat public preview pada 6 Oktober 2026. Versi yang bobotnya dirilis 29 Oktober adalah versi perbaikan. Menurut Mistral, model ini mendapat tambahan tiga minggu reinforcement learning (pelatihan lanjutan dengan umpan balik berupa skor) setelah preview.
Lisensi: boleh dipakai bisnis, dengan satu pagar
Mistral merilis bobotnya di bawah Mistral Ecosystem Open-Weight License, yaitu modifikasi dari lisensi MIT. Teksnya pendek, kurang dari satu halaman.
Yang diizinkan: memakai, menyalin, memodifikasi, mendistribusikan, menjual salinan, melatih lanjut (fine-tuning), dan membuat turunan. Syaratnya, pemberitahuan hak cipta dan lisensi wajib ikut disertakan.
Pagarnya ada di poin kedua. Kalau kamu atau afiliasimu menjalankan bisnis Model as a Service, kamu wajib membuat lisensi komersial terpisah dengan Mistral sebelum memakai model untuk tujuan komersial. Lisensi mendefinisikan Model as a Service sebagai memberi pihak ketiga akses ke model untuk inferensi atau pelatihan lanjutan, misalnya lewat API. Pihak ketiga itu juga punya kendali berarti atas input, parameter, atau data latih.
Lisensi juga menyebut pengecualian yang relevan untuk pebisnis kecil:
- Pemakaian internal yang tidak membuka model ke pihak ketiga tidak terkena syarat tadi.
- Produk untuk pengguna akhir yang hanya menanam kemampuan model di fitur tertentu juga dikecualikan. Menurut pembacaan saya, chatbot layanan pelanggan di toko online masuk kategori ini.
- Sekadar meneruskan permintaan ke model yang di-hosting pihak lain juga tidak termasuk.
- Pemakaian lewat produk resmi Mistral, misalnya API Mistral, juga tidak terkena syarat tersebut.
Pendapat saya, lisensi ini cukup ramah untuk pemakai biasa. Batasnya menyasar penyedia infrastruktur yang ingin menjual ulang model, dan tidak menyasar perusahaan yang membangun aplikasi di atasnya.
Kebutuhan server: di sini kenyataannya terasa
Ukuran 1 triliun parameter punya konsekuensi. Contoh konfigurasi di model card memakai 8 GPU dalam satu server, dengan catatan angka itu bisa disesuaikan. Blog Hugging Face menyebut resep Inference Endpoints mereka berjalan di 8 GPU NVIDIA H200. Versi NVFP4, yaitu format bobot yang lebih ringkas, malah mensyaratkan GPU generasi Blackwell.
Untuk opsi paling hemat, tim Hugging Face menyebut kuantisasi 2-bit bisa berjalan di satu komputer Apple Silicon Ultra dengan memori 512 GB. Kuantisasi adalah teknik memperkecil bobot dengan mengorbankan sedikit ketelitian. Dalam pengukuran mereka di M3 Ultra, kecepatan menghasilkan teksnya sekitar 15 token per detik. Itu masih bisa dipakai untuk eksperimen, tapi terlalu lambat untuk melayani banyak pengguna.
Pendapat saya, untuk sebagian besar UMKM dan profesional di Indonesia, menjalankan sendiri bukan pilihan yang masuk akal. Menyewa atau membeli server berisi 8 GPU kelas pusat data adalah investasi besar, sementara API cukup dibayar sesuai pemakaian. Model card sendiri menyarankan API Mistral bila hasil penyajian lokal kurang optimal. Pengecualiannya adalah organisasi yang memang wajib menyimpan data di infrastruktur sendiri.
Tiga jalur memakai Mistral Large 4
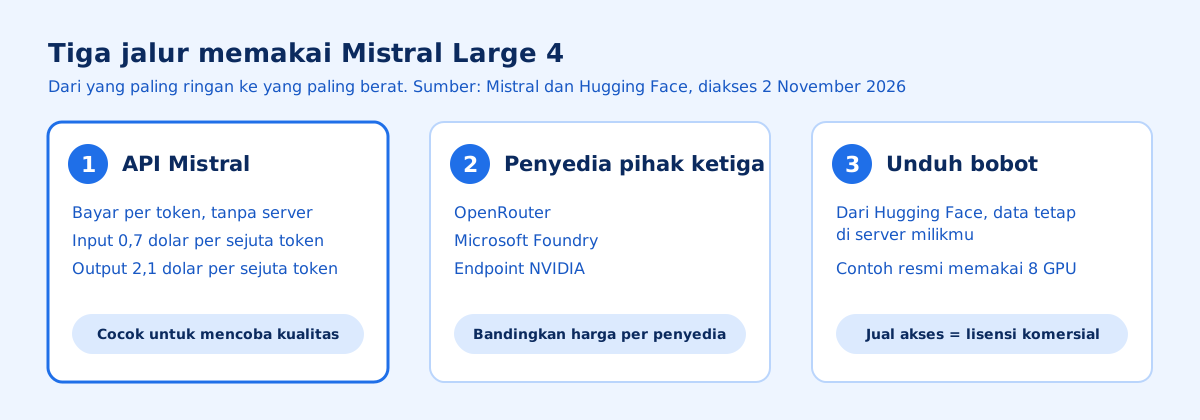
Pengumuman Mistral menyebut model ini bisa dipakai lewat Mistral Studio, Mistral API, OpenRouter, Microsoft Foundry, endpoint yang di-hosting NVIDIA, atau diunduh langsung dari Hugging Face. Saya kelompokkan menjadi tiga jalur.
Jalur 1: API Mistral
Ini jalur yang saya sarankan untuk mencoba. Menurut dokumentasi Mistral, harga model mistral-large-4 adalah 0,7 dolar AS per sejuta token input dan 2,1 dolar per sejuta token output. Input yang di-cache lebih murah, 0,07 dolar per sejuta token. Token adalah potongan kata yang dipakai model untuk menghitung panjang teks.
Harga ini dalam dolar, jadi tagihan rupiahnya ikut kurs. Mode penalaran high juga cenderung menghasilkan lebih banyak token, sehingga biaya per permintaan bisa melampaui perkiraan kasar.
Jalur 2: penyedia pihak ketiga
OpenRouter cocok kalau kamu ingin membandingkan beberapa model dari satu akun. Microsoft Foundry cocok untuk perusahaan yang sudah memakai Azure, karena Mistral menyebut ada opsi deployment privat untuk pengembang Azure. NVIDIA juga menyediakan endpoint yang di-hosting. Saya belum memeriksa harga Mistral Large 4 di masing-masing penyedia ini, jadi bandingkan sendiri sebelum memilih.
Jalur 3: unduh bobot dan hosting sendiri
Jalur ini masuk akal hanya bila ada alasan kuat. Misalnya data tidak boleh keluar dari server milikmu, butuh fine-tuning dengan data internal, atau ingin lepas dari ketergantungan pada satu penyedia. Bagi instansi dan perusahaan dengan regulasi ketat di Indonesia, menurut saya inilah nilai terbesar rilis open-weight.
Pendapat saya: mulai dari jalur 1, pindah ke jalur 3 hanya kalau ada kewajiban, jangan sekadar karena penasaran. Kalau tujuanmu sekadar membandingkan kualitas, API sudah cukup.
Bahasa Indonesia dan klaim benchmark
Kabar baik untuk pembaca di sini: model card mencantumkan kode bahasa Indonesia (id) dan Melayu (ms) dalam daftar bahasanya. Mistral mengklaim model ini fasih di lebih dari 160 bahasa. Namun materi resmi yang menjadi sumber artikel ini tidak memuat angka benchmark khusus Bahasa Indonesia. Kualitas jawabannya untuk tugas lokal, misalnya surat resmi atau istilah pajak Indonesia, belum terverifikasi.
Untuk angka performa, perlakukan semuanya sebagai klaim vendor. Menurut Mistral, model ini mencetak 48% di Artificial Analysis Coding Agent Index, setara GLM-5.3, dengan rata-rata 47% lebih sedikit token per tugas. Di Terminal-Bench 4.0 skornya 41%, naik 13 poin dibanding versi preview. Di Artificial Analysis Intelligence Index v5 skornya 26, tertinggi di antara model open-weight dari negara Barat. Model card mengakui bahwa model open-weight dari Tiongkok mencetak skor lebih tinggi di indeks gabungan itu.
Selain coding, keunggulan yang paling ditonjolkan Mistral ada di keamanan siber defensif. Mistral mengklaim skor 51% di Artificial Analysis Cyber Index dan tingkat penolakan rata-rata 96,6% untuk permintaan siber yang berbahaya. Mistral juga mengakui ada potensi model membantu serangan nyata, sehingga mereka memantau lalu lintas dan akan terus memperbarui pengamannya dalam beberapa bulan ke depan.
Ringkasan dan langkah berikutnya
Checklist sebelum memilih Mistral Large 4
- Saya tahu kebutuhan saya: mencoba kualitas, membangun produk, atau wajib hosting sendiri
- Saya sudah menghitung biaya API dalam rupiah dengan kurs hari ini
- Saya paham tingkat penalaran low, medium, dan high memengaruhi jumlah token
- Rencana bisnis saya tidak termasuk menjual akses model sebagai layanan, atau sudah menghubungi Mistral
- Model sudah diuji dengan contoh tugas berbahasa Indonesia milik sendiri
- Kalau memilih hosting sendiri, saya punya akses ke server 8 GPU kelas pusat data
Cheat sheet
| Kondisi kamu | Jalur yang saya sarankan |
|---|---|
| Ingin mencoba kualitasnya | API Mistral atau OpenRouter |
| Membangun fitur AI di aplikasi sendiri | API Mistral, cek lisensi bila akan di-hosting sendiri |
| Perusahaan yang sudah di Azure | Microsoft Foundry |
| Data wajib tetap di server sendiri | Unduh bobot dari Hugging Face, siapkan 8 GPU |
| Ingin menjual akses model ke pihak lain | Hubungi Mistral untuk lisensi komersial |
| Sekadar penasaran, tanpa anggaran server | Jangan hosting sendiri, cukup lewat API |
Model baru akan terus datang setiap bulan. Bekal yang lebih awet adalah kemampuan menilai model dan merangkainya menjadi alur kerja yang berguna. Kalau kamu ingin belajar membangun aplikasi atau otomasi berbasis AI secara terstruktur, lihat daftar Kelas di eduwebmu dan pilih yang sesuai tujuanmu.
Pertanyaan yang sering diajukan
Kapan bobot Mistral Large 4 dirilis?
Mistral merilis bobot versi yang sudah diperbaiki pada 29 Oktober 2026. Sebelumnya model ini sudah tersedia sebagai public preview sejak 6 Oktober 2026, menurut dokumentasi Mistral.
Apakah Mistral Large 4 gratis dipakai untuk bisnis?
Bobotnya boleh dipakai untuk keperluan komersial dan nonkomersial tanpa biaya lisensi. Pengecualiannya, perusahaan yang menjalankan bisnis Model as a Service wajib membuat lisensi komersial terpisah dengan Mistral.
Apakah Mistral Large 4 bisa dijalankan di laptop?
Secara praktis tidak. Versi terkecil yang disebut tim Hugging Face, kuantisasi 2-bit, butuh satu komputer Apple Silicon Ultra dengan RAM 512 GB, sedangkan contoh konfigurasi di model card memakai satu server berisi 8 GPU.
Apakah Mistral Large 4 mendukung Bahasa Indonesia?
Model card mencantumkan Bahasa Indonesia dan Bahasa Melayu dalam daftar bahasanya, dan Mistral mengklaim model ini fasih di lebih dari 160 bahasa. Kualitas jawabannya dalam Bahasa Indonesia belum terverifikasi lewat uji independen.
Berapa harga API Mistral Large 4?
Menurut dokumentasi Mistral, harganya 0,7 dolar AS per sejuta token input, 0,07 dolar per sejuta token input yang di-cache, dan 2,1 dolar per sejuta token output.
Apakah fitur reasoning Mistral Large 4 bisa dimatikan?
Tidak. Pilihannya low, medium, atau high (default), dan Mistral menempatkan low sebagai pengganti mode None. Menurut blog Hugging Face, meminta none tetap dijalankan sebagai high.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.Mistral AI, "Mistral Large 4 (Le Chonk) is now open weight" (29 Oktober 2026)mistral.ai(buka di tab baru)
- 2.Hugging Face, model card "mistralai/Mistral-Large-4-1T-A52B"huggingface.co(buka di tab baru)
- 3.Mistral Ecosystem Open-Weight License (berkas LICENSE di repositori model)huggingface.co(buka di tab baru)
- 4.Hugging Face Blog, "Welcome Le Chonk: Mistral Large 4 on Hugging Face" (29 Oktober 2026)huggingface.co(buka di tab baru)
- 5.Mistral Docs, halaman model "Mistral Large 4"docs.mistral.ai(buka di tab baru)
mistralopen-weightmodel aillm