Kapan model AI kecil sudah cukup untuk pekerjaanmu
Oleh Dedi NugrohoTerbit 16 menit baca
Daftar isi
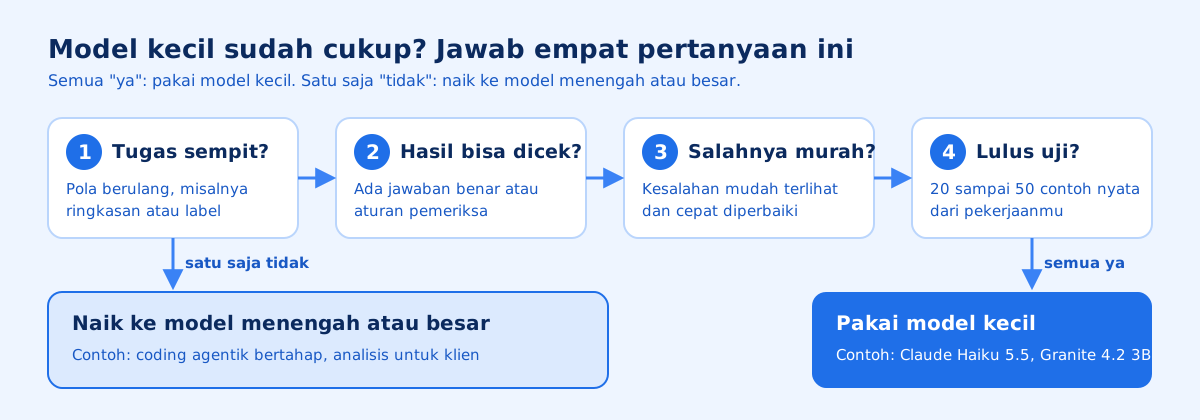
Model AI kecil sudah cukup ketika tugasmu sempit, berulang, dan hasilnya mudah dicek. Contohnya merangkum, memberi label, mengekstrak data dari formulir, atau menjawab pertanyaan pelanggan yang polanya jelas. Begitu tugasnya terbuka, panjang, atau mahal kalau salah, misalnya coding agentik yang rumit, naiklah ke model menengah atau besar.
Tesis artikel ini: ukuran model sebaiknya ditentukan oleh hasil uji di contoh tugasmu sendiri, dan titik awal yang paling hemat adalah model kecil. Sepanjang Agustus sampai Oktober 2026 muncul banyak model kecil yang serius, dari Claude Haiku 5.5 sampai model terbuka yang muat di laptop. Godaannya adalah memakai model paling mahal untuk semua hal karena terasa lebih aman. Rasa aman itu ada harganya, dan sering tidak sebanding dengan selisih kualitasnya.
Yang perlu diluruskan dulu soal model kecil
Kata "kecil" di sini relatif, dan untuk model terbuka ukurannya biasa disebut dalam jumlah parameter. Parameter adalah angka-angka hasil pelatihan yang menyimpan "pengetahuan" model, dan makin banyak parameter, makin besar memori yang dibutuhkan untuk menjalankannya. Sebagai gambaran, Liquid AI menyebut model teks LFM3 berukuran 1,7 miliar parameter muat di sekitar 1 GB memori, cukup kecil untuk laptop dan ponsel.
Untuk model tertutup seperti Claude, kecil berarti kelas termurah dan tercepat di keluarganya. Halaman pengumuman Claude Haiku 5.5 tidak menyebut jumlah parameternya, jadi Haiku disebut kecil karena perannya, sedangkan ukuran fisiknya tidak diumumkan.
Salah kaprah kedua: model kecil dianggap versi "bodoh" dari model besar. Kenyataannya, jarak kemampuan itu tidak sama rata di semua jenis tugas. Untuk menjawab soal pilihan ganda tingkat pascasarjana, jaraknya bisa tipis. Untuk mengerjakan tugas coding panjang di terminal, jaraknya bisa hampir dua kali lipat. Angka-angkanya saya bahas di bab berikut.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Tiga jenis model kecil | Model kecil apa saja yang relevan saat ini, dan bedanya apa? |
| Pekerjaan yang cukup dengan model kecil | Tugas sehari-hari mana yang aman diserahkan ke model kecil? |
| Tanda perlu naik kelas | Kapan model kecil justru membuang waktu? |
| Cara menguji sendiri | Bagaimana memutuskan tanpa menebak? |
| Lewat API atau di perangkat sendiri | Kapan model lokal masuk akal? |
| Ringkasan | Apa yang dicek sebelum memilih? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Semua angka diambil dari halaman resmi Anthropic, Liquid AI, IBM, dan Google, dan sebagian besar adalah hasil uji milik vendor sendiri. Saya belum menjalankan uji tandingan untuk artikel ini. Perlakukan angka tolok ukur (benchmark, yaitu kumpulan soal standar untuk membandingkan model) sebagai petunjuk arah, dan putuskan berdasarkan uji di datamu sendiri.
Artikel ini untuk kamu yang memakai AI untuk kerja harian atau mulai menyusun otomasi kecil, lalu bertanya-tanya model mana yang pas. Artikel ini tidak membahas cara memasang model di komputer atau menulis kode untuk API. Kalau kamu peneliti yang butuh perbandingan arsitektur model, sumber di bagian akhir lebih cocok untukmu.
Tiga jenis model kecil yang perlu kamu kenal
Model kecil yang beredar sekarang bisa dibagi menjadi tiga kelompok. Ketiganya sering dicampur dalam satu obrolan tentang "AI murah", padahal cara pakai dan risikonya berbeda jauh.
Model kecil lewat layanan (API): Claude Haiku 5.5
API adalah pintu yang dipakai aplikasi untuk mengirim permintaan ke model milik vendor dan menerima jawabannya. Kamu tidak perlu mengurus server dan cukup membayar per pemakaian, dan Claude Haiku 5.5 adalah contoh paling baru di kelompok ini.
Anthropic merilis Haiku 5.5 pada 7 Oktober 2026 dan menyebutnya model kecil termurah, tercepat, dan paling mampu yang pernah mereka buat. Tugas yang disebut cocok adalah ringkasan, pemadatan percakapan panjang, kueri database, klasifikasi, layanan pelanggan langsung, dan menjadi subagen. Subagen adalah model pembantu yang menerima satu potong tugas dari model utama.
Harganya bertingkat sesuai panjang prompt. Untuk prompt sampai 100.000 token, harganya $0,10 per juta token input dan $0,50 per juta token output. Di atas 100.000 token, harganya naik menjadi $0,50 dan $2,50. Token adalah potongan kata yang dipakai model untuk menghitung teks. Menurut Anthropic, sekitar 90% permintaan ke Haiku versi sebelumnya berada di bawah batas 100.000 token itu.
Haiku 5.5 juga model Haiku pertama yang punya pengaturan effort. Effort adalah tombol yang mengatur seberapa banyak model "berpikir" sebelum menjawab. Effort rendah membuat jawaban lebih murah dan cepat, sedangkan effort tinggi membuatnya lebih teliti.
Model terbuka kecil: LFM3 dan Granite 4.2 3B
Model terbuka (open-weight) adalah model yang file-nya bisa diunduh dan dijalankan di perangkat sendiri. Kamu tidak bergantung pada layanan vendor, tetapi kamu sendiri yang mengurus perangkat, keamanan, dan pembaruannya.
Liquid AI merilis keluarga LFM3 pada 27 Oktober 2026. Isinya enam model di kelas sekitar 2 miliar parameter. Rinciannya satu model teks, satu model gambar dan video, satu model suara, satu model gabungan semuanya (omni), dan dua model pengambilan keputusan. Menurut Liquid AI, model teksnya (LFM3-1.7B) muat di sekitar 1 GB dengan presisi 4-bit dan bisa membaca konteks sampai 256 ribu token. Semua modelnya diklaim bisa dilatih ulang (fine-tune) dengan satu GPU. Fine-tune berarti melatih model sedikit lagi dengan datamu sendiri supaya paham istilah dan format pekerjaanmu.
Yang menarik bagi pebisnis adalah model keputusan d1-2B. Model ini tidak dirancang untuk menulis jawaban panjang. Ia diberi satu situasi, misalnya tiket keluhan pelanggan, lalu menjawab beberapa pertanyaan sekaligus, masing-masing dengan angka probabilitas. Contoh dari Liquid AI: apakah pelanggan minta refund, tim mana yang harus menangani, dan seberapa mendesak tiketnya.
IBM merilis Granite 4.2 pada 25 Agustus 2026 dalam tiga ukuran: 3B, 8B, dan 30B. Ketiganya berlisensi Apache 2.0, yang berarti boleh dipakai untuk keperluan komersial, dan punya mode berpikir, tanpa berpikir, serta mode berpikir hemat untuk pertanyaan mudah. Satu hal yang jarang dibahas: hanya versi 8B dan 30B yang dilatih khusus untuk bertindak sebagai agen yang memakai alat. Versi 3B tidak mendapat tahap itu.
Model embedding: EmbeddingGemma 2
Kelompok ketiga paling sering terlupa. Model embedding tidak menulis jawaban, tetapi mengubah teks, gambar, atau suara menjadi deretan angka yang mewakili maknanya, sehingga komputer bisa mencari dokumen yang maknanya mirip dengan pertanyaan.
EmbeddingGemma 2 dari Google DeepMind adalah contoh terbarunya. Menurut model card resminya, total ukurannya 740 juta parameter. Bagian teksnya 270 juta, sedangkan pembaca gambar (170 juta) dan suara (300 juta) boleh dimuat hanya bila perlu. Model ini memahami lebih dari 100 bahasa, membaca sampai 8.192 token, dan berlisensi Apache 2.0.
Ini relevan karena banyak "chatbot dokumen perusahaan" sebenarnya bertumpu pada pencarian, dan bagian pencarian itu cukup dikerjakan model embedding kecil. Model bahasa yang lebih besar hanya dipanggil untuk menyusun jawaban dari dokumen yang sudah ditemukan.
| Kelompok | Contoh | Cara pakai | Cocok untuk |
|---|---|---|---|
| Model kecil lewat API | Claude Haiku 5.5 | Bayar per token, tanpa urus server | Volume besar, butuh cepat, tim tanpa infrastruktur |
| Model terbuka kecil | LFM3, Granite 4.2 3B | Unduh, jalankan di perangkat sendiri | Data sensitif, tanpa internet, tugas yang mau dilatih khusus |
| Model embedding | EmbeddingGemma 2 | Unduh, jalankan di perangkat sendiri | Pencarian dokumen, pengelompokan, rekomendasi |
Pekerjaan yang biasanya cukup dengan model kecil
Pola umumnya bisa diringkas jadi satu kalimat: model kecil kuat di tugas yang jawabannya sudah "ada" di dalam bahan yang kamu berikan, dan lemah di tugas yang menuntut rencana panjang. Berikut pekerjaan yang menurut saya layak dicoba dengan model kecil lebih dulu.
Merangkum dan memadatkan. Contohnya ringkasan rapat, utas email, atau ulasan produk. Bahannya sudah lengkap di depan model, jadi tugasnya tinggal memilih dan memadatkan. Anthropic menyebut ringkasan sebagai salah satu tugas utama Haiku 5.5.
Memberi label atau mengklasifikasi. Misalnya menandai email masuk sebagai tagihan, keluhan, atau peluang penjualan, atau menandai komentar sebagai positif dan negatif. Tugas seperti ini punya jawaban benar yang jelas, jadi mudah diuji.
Mengekstrak data. Menarik nama, tanggal, nominal, dan nomor faktur dari teks ke dalam kolom spreadsheet. Liquid AI bahkan menyediakan contoh pelatihan LFM3 untuk membaca foto struk menjadi data terstruktur.
Menjawab pertanyaan pelanggan yang polanya berulang. Pertanyaan seperti jam buka, status pesanan, dan cara retur masuk kelompok ini. Anthropic secara khusus menyebut layanan pelanggan langsung sebagai tugas yang cocok untuk Haiku 5.5 karena kecepatannya.
Menjadi pembantu model besar. Di alur kerja agen, model besar bisa bertugas sebagai perencana, lalu membagi pekerjaan kasar ke model kecil. Halaman optimasi biaya Claude menyebut pola ini orchestrator, dengan tujuan agar sebagian besar token dibayar dengan harga model yang lebih murah. Halaman yang sama juga jujur soal batasnya. Dalam pengukuran Anthropic, pembagian kerja ini hanya menghemat biaya di dua situasi: pekerjaan rutin yang sebagian kecil kasusnya sangat mahal dan pekerjaan yang terlalu besar untuk satu jendela konteks. Untuk rangkaian tugas yang saling bergantung, model utama dengan effort lebih rendah justru lebih hemat.
Ada satu angka resmi yang menurut saya paling berguna untuk meyakinkan atasan atau klien. Di halaman optimasi biaya tadi, Anthropic melaporkan hasil uji GPQA Diamond, kumpulan soal sains tingkat pascasarjana. Haiku 5.5 di effort bawaan menjawab benar 85%, sedangkan Opus 5.5 dan Sonnet 5.5 masing-masing 91%. Biaya per jawaban benar Haiku sekitar seperdua puluh Opus 5.5 dan sepersepuluh Sonnet 5.5. Ini angka uji Anthropic sendiri, belum uji independen.
Selisihnya 6 poin, dengan biaya per jawaban benar sekitar 20 kali lebih murah dibanding Opus 5.5. Untuk pekerjaan bervolume besar, menurut saya angka itu sudah cukup untuk mengakhiri perdebatan. Tetapi ingat, ini soal pilihan ganda dengan jawaban pasti. Tugas yang lebih terbuka bisa menunjukkan jarak yang lebih lebar.
Klaim pelanggan di pengumuman Haiku 5.5 juga searah. AlphaSense, misalnya, menyebut fitur tanya jawab dokumennya berjalan sekitar 8 juta kali per minggu. Dari 400 pertanyaan uji, mereka melaporkan skor Haiku 5.5 naik menjadi 0,84 dari 0,76 di Haiku 4.5. Ini klaim pelanggan yang dikutip vendor, bukan uji independen, tetapi polanya cocok: tugas sempit, volume besar, jawaban yang bisa dinilai.
Tanda kamu perlu naik ke model yang lebih besar
Model kecil tidak selalu jawaban yang tepat, dan ada beberapa tanda yang menurut saya cukup jelas untuk naik kelas.
Tugasnya panjang dan butuh banyak langkah
Di tabel resmi Anthropic, Haiku 5.5 mencetak 39,2% di Terminal-Bench 4.0, uji yang meminta model menyelesaikan tugas profesional bertahap di terminal komputer. Sonnet 5.5 mencetak 70,6% di uji yang sama, jadi jaraknya hampir dua kali lipat. Bandingkan dengan GPQA Diamond tadi yang jaraknya hanya 6 poin.
Anthropic sendiri menulis terang di pengumumannya bahwa Sonnet 5.5 dan Opus 5.5 tetap pilihan yang lebih baik untuk coding agentik yang kompleks. Haiku 5.5 disebut paling cocok untuk tugas yang cakupannya sempit. Saya menghargai vendor yang menulis batas produknya sendiri, dan menurut saya batas ini layak dipercaya.
Pola serupa terlihat di Granite 4.2. Di tabel hasil IBM, versi 3B tidak punya skor untuk uji coding agentik seperti SWE-Bench, karena memang tidak dilatih untuk itu. Untuk kepatuhan instruksi (IFBench), skor 3B adalah 74,33, tidak jauh dari 30B yang 77,17. Untuk uji pengetahuan umum MMLU-Pro, jaraknya lebih lebar: 67,84 lawan 77,60.
Pelajarannya: model kecil sering setara dalam mengikuti perintah, tetapi tertinggal dalam pengetahuan luas dan kerja bertahap.
Kesalahan mahal dan sulit dilihat
Kalau model kecil salah memberi label satu email, kerugiannya kecil dan mudah terlihat. Kalau model kecil salah membaca klausul kontrak lalu ringkasannya dikirim ke klien, kesalahannya mahal dan baru ketahuan belakangan. Untuk pekerjaan jenis kedua, selisih biaya model menjadi tidak relevan.
Saya tidak menyarankan model kecil untuk keluaran yang langsung sampai ke klien tanpa diperiksa manusia. Ini berlaku untuk proposal, analisis hukum, nasihat keuangan, atau kode yang langsung masuk produksi.
Bahasanya bukan bahasa yang didukung resmi
Ini jebakan khusus pengguna Indonesia. Blog rilis Granite 4.2 mencantumkan 12 bahasa yang didukung: Inggris, Jerman, Spanyol, Prancis, Jepang, Portugis, Arab, Ceko, Italia, Korea, Belanda, dan Mandarin. Bahasa Indonesia tidak ada di daftar itu, artinya model mungkin tetap bisa membaca bahasa Indonesia, tetapi IBM tidak menjaminnya.
EmbeddingGemma 2 menyebut lebih dari 100 bahasa, tetapi model card-nya tidak merinci daftarnya dan mengakui performanya mungkin tidak sama di semua bahasa. Untuk LFM3, blog rilisnya menyebut model suaranya mendukung terjemahan di 18 bahasa tanpa merinci daftarnya di halaman itu. Jadi, uji dengan teks berbahasa Indonesia milikmu sendiri, termasuk bahasa campur dan singkatan khas pelangganmu.
Kamu terus memperpanjang prompt supaya hasilnya benar
Tanda terakhir ini paling halus. Kalau kamu sudah menambah contoh, aturan, dan pengecualian berkali-kali, tetapi model kecil masih tidak konsisten, berhentilah. Prompt yang makin panjang juga menambah biaya, dan di Haiku 5.5 prompt di atas 100.000 token dihargai lima kali lipat. Pada titik itu, model menengah dengan prompt pendek sering lebih murah secara keseluruhan.
Cara menguji sendiri sebelum memutuskan
Bagian ini paling penting, dan anehnya paling sering dilewati. Di panduan memilih model Claude, Anthropic menyebut membuat set uji khusus untuk kasusmu sebagai langkah terpenting. Menurut saya saran ini berlaku untuk model dari vendor mana pun.
Panduan yang sama menawarkan dua pendekatan. Pendekatan pertama mendahulukan efisiensi: mulai dengan Haiku 5.5, uji menyeluruh, lalu naik kelas hanya bila ada kekurangan yang jelas. Pendekatan kedua mendahulukan kemampuan: mulai dengan model terkuat, lalu turunkan pelan-pelan. Untuk pekerjaan berulang bervolume besar, saya pilih pendekatan pertama. Untuk pekerjaan sekali jalan yang mahal kalau salah, saya pilih yang kedua.
Berikut cara menguji yang bisa dilakukan tanpa latar belakang teknis.
- Kumpulkan 20 sampai 50 contoh nyata. Ambil dari pekerjaanmu minggu lalu, bukan contoh karangan. Sertakan beberapa kasus sulit: pesan ambigu, data tidak lengkap, bahasa campur.
- Tulis jawaban yang benar untuk tiap contoh. Kalau kamu sendiri tidak bisa menulis jawabannya, tugas itu belum siap diserahkan ke model mana pun.
- Jalankan contoh yang sama di dua model. Pilih satu model kecil dan satu model menengah, lalu pakai instruksi yang sama persis.
- Hitung yang lolos, bukan yang terasa bagus. Tandai benar atau salah per contoh, dan hindari menilai dari kesan sekilas.
- Bandingkan biaya per tugas yang berhasil. Halaman optimasi biaya Anthropic menyarankan membandingkan model dari biaya per tugas yang selesai, bukan harga per token. Model yang lebih mahal per token kadang menyelesaikan tugas dengan langkah lebih sedikit.
Aturan saya sederhana. Kalau model kecil lolos di hampir semua contoh dan kegagalannya mudah terlihat, pakai model kecil. Kalau kegagalannya tersebar acak dan sulit dikenali, naik kelas.
Ada dua pengaturan lain yang sering lebih berguna daripada berganti model. Yang pertama adalah effort, dan panduan Anthropic menyebut mengatur effort sering kali lebih ampuh daripada berganti model. Bawaan Haiku 5.5 ada di level medium. Yang kedua adalah pemrosesan batch, yaitu mengirim banyak permintaan sekaligus untuk diproses belakangan. Menurut halaman optimasi biaya, batch mendapat potongan 50% untuk pekerjaan yang boleh menunggu sampai 24 jam, misalnya meringkas arsip ulasan semalaman.
Lewat API atau di perangkat sendiri
Setelah tahu model kecil cukup, pertanyaan berikutnya: pakai layanan seperti Haiku 5.5, atau jalankan model terbuka seperti LFM3 dan Granite 4.2 di perangkat sendiri?
Pilihan lokal masuk akal dalam tiga kondisi. Pertama, datanya sensitif dan tidak boleh keluar dari perangkat, misalnya rekam medis atau data internal yang diatur ketat. Kedua, aplikasinya harus jalan tanpa internet, misalnya di ponsel lapangan. Ketiga, tugasnya sangat spesifik dan kamu punya data untuk melatih ulang model. Liquid AI secara khusus menonjolkan fine-tune dengan satu GPU untuk alasan terakhir ini.
Di luar tiga kondisi itu, saya condong ke API. Menjalankan model sendiri berarti mengurus perangkat, pembaruan versi, pemantauan, dan pengujian ulang setiap ganti model. Untuk usaha kecil tanpa tim teknis, biaya tersembunyi ini sering lebih besar daripada tagihan token. Dengan harga Haiku 5.5 di $0,10 per juta token input, menurut saya penghematan biaya langsung dari model lokal juga tipis untuk volume menengah.
Ada satu pengecualian yang menurut saya layak dipertimbangkan siapa saja: model embedding. EmbeddingGemma 2 dirancang untuk jalan di ponsel dan laptop. Model card-nya juga menyebut fitur pemotongan vektor yang bisa menghemat ruang simpan sampai 6 kali dengan penurunan kualitas yang kecil. Kalau kamu membangun pencarian dokumen internal, bagian pencarian bisa jalan lokal, sedangkan penyusunan jawaban tetap memakai model lewat API.
| Kondisi | Pilihan yang saya sarankan |
|---|---|
| Tim kecil, tanpa orang teknis, data tidak sensitif | Model kecil lewat API |
| Data sensitif yang tidak boleh keluar perangkat | Model terbuka kecil di server sendiri |
| Aplikasi harus jalan tanpa internet | Model terbuka kecil di perangkat |
| Pencarian dokumen internal | Model embedding lokal, jawaban lewat API |
| Tugas sangat spesifik dengan data latih sendiri | Model terbuka kecil yang dilatih ulang |
Ringkasan dan langkah berikutnya
Checklist sebelum memilih model kecil
- Tugasnya sempit dan polanya berulang, misalnya merangkum, memberi label, atau mengekstrak data
- Ada cara mengecek hasilnya, baik oleh manusia maupun aturan otomatis
- Kesalahan model murah dan mudah terlihat
- Sudah ada 20 sampai 50 contoh nyata beserta jawaban yang benar
- Model kecil dan model menengah sudah diuji dengan instruksi yang sama
- Bahasa yang dipakai sudah diuji, terutama bahasa Indonesia dan bahasa campur
- Panjang prompt biasanya di bawah 100.000 token (penting untuk harga Haiku 5.5)
- Sudah diputuskan lewat API atau jalan di perangkat sendiri
Cheat sheet
| Pekerjaan | Model kecil cukup? | Catatan |
|---|---|---|
| Ringkasan rapat atau email | Ya | Bahan lengkap ada di prompt |
| Klasifikasi dan label pesan | Ya | Mudah diuji dengan jawaban benar |
| Ekstraksi data ke spreadsheet | Ya | Cek format keluaran secara otomatis |
| Chatbot pertanyaan berulang | Ya, dengan batas | Alihkan ke manusia untuk kasus di luar pola |
| Pencarian dokumen internal | Ya, pakai model embedding | Jawaban akhir boleh pakai model lebih besar |
| Draf artikel atau proposal panjang | Tidak saya sarankan | Alur argumen butuh model menengah atau besar |
| Coding agentik bertahap | Tidak | Selisih Terminal-Bench 4.0: 39,2% lawan 70,6% |
| Analisis yang langsung dikirim ke klien | Tidak | Biaya salah jauh lebih besar dari selisih harga |
Kalau kamu ingin mencoba sendiri tanpa mengurus API, buka AI Tools eduwebmu dan pilih model Standar yang memakai Haiku. Ambil lima contoh tugas dari checklist di atas, jalankan di Standar, lalu ulangi di Pro. Kalau hasil Standar sudah lolos, kamu baru saja menghemat Saldo AI untuk pekerjaan yang benar-benar butuh model besar.
Pertanyaan yang sering diajukan
Apa yang dimaksud model AI kecil?
Model bahasa yang lebih murah dan lebih cepat dari model andalan vendornya. Untuk model terbuka, ukurannya biasanya beberapa miliar parameter atau kurang, sehingga bisa jalan di laptop atau ponsel.
Apakah model kecil cocok untuk menulis artikel atau proposal klien?
Bisa untuk draf kasar dan ringkasan bahan. Untuk tulisan panjang yang butuh alur argumen dan langsung dikirim ke klien, saya sarankan model menengah atau besar.
Berapa harga Claude Haiku 5.5?
Menurut Anthropic, $0,10 per satu juta token input dan $0,50 per satu juta token output untuk prompt sampai 100.000 token. Di atas itu harganya $0,50 dan $2,50.
Apakah model kecil bisa dipakai tanpa internet?
Model terbuka seperti LFM3, Granite 4.2 3B, dan EmbeddingGemma 2 bisa diunduh dan dijalankan di perangkat sendiri. Claude Haiku 5.5 hanya tersedia lewat layanan daring.
Apakah Granite 4.2 bisa berbahasa Indonesia?
Bahasa Indonesia tidak ada di daftar bahasa yang didukung resmi pada blog rilis Granite 4.2. Uji dulu dengan contoh kalimatmu sendiri sebelum mengandalkannya.
Bagaimana cara tahu model kecil sudah cukup?
Siapkan 20 sampai 50 contoh tugas nyata beserta jawaban yang benar, jalankan di model kecil dan model yang lebih besar, lalu bandingkan hasil dan biaya per tugas yang selesai.
Model apa yang dipakai AI Tools eduwebmu untuk tingkat Standar?
Tingkat Standar di AI Tools eduwebmu memakai Haiku. Tingkat Pro memakai Sonnet 5.5 dan Premium memakai Opus.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.Anthropic, "Introducing Claude Haiku 5.5" (7 Oktober 2026)anthropic.com(buka di tab baru)
- 2.Claude Docs, "Choosing the right model"platform.claude.com(buka di tab baru)
- 3.Claude Docs, "Optimizing for cost and intelligence"platform.claude.com(buka di tab baru)
- 4.Liquid AI di Hugging Face Blog, "Build specialized multimodal models with LFM3" (27 Oktober 2026)huggingface.co(buka di tab baru)
- 5.IBM Granite di Hugging Face Blog, "Granite 4.2 LLMs: How They're Built" (25 Agustus 2026)huggingface.co(buka di tab baru)
- 6.Google DeepMind, "EmbeddingGemma"deepmind.google(buka di tab baru)
- 7.Google AI for Developers, "EmbeddingGemma 2 model card"ai.google.dev(buka di tab baru)
model aiclaude haikumodel lokalbiaya ai