Otomasi AI tanpa cloud: n8n di komputer AI lokal
Oleh Dedi NugrohoTerbit 10 menit baca
Daftar isi
Otomasi AI lokal artinya workflow n8n memanggil model AI yang berjalan di perangkat milikmu sendiri, tanpa mengirim data ke API cloud. Pada 19 Oktober 2026, n8n menerbitkan panduan menjalankan tujuh model sekaligus di satu NVIDIA DGX Spark. Cocok untuk data sensitif dan volume tinggi, tetapi menuntut perawatan dan punya batas kecepatan yang nyata.
Tesis saya: otomasi AI lokal sekarang realistis untuk tim kecil, tetapi alasan memilihnya harus soal data, bukan soal gaya. Kalau datamu boleh keluar kantor dan volumenya kecil, API cloud masih lebih praktis. Kalau kontrak, regulator, atau kewajiban profesi melarang data keluar, lokal layak dipertimbangkan. Angka dari panduan n8n menunjukkan satu mesin meja cukup untuk pekerjaan teks dan dokumen tim kecil, selama pembuatan gambar tidak berjalan bersamaan.
Yang perlu diluruskan dulu
Ada dua salah kaprah yang umum soal AI lokal. Pertama, "AI lokal berarti model kecil yang bodoh." Panduan n8n justru memakai model teks 35 miliar parameter untuk chat, ekstraksi data, dan membaca gambar. Model ini bertipe mixture-of-experts, artinya hanya sekitar 3 miliar parameter yang aktif untuk setiap token sehingga tetap cepat. Kedua, "kalau lokal, n8n harus diubah total." Faktanya, kredensial OpenAI di n8n menerima Base URL kustom, sehingga node yang biasa memanggil OpenAI bisa diarahkan ke server lokal. Ada penyesuaian kecil, misalnya panduan n8n meminta opsi Responses API dimatikan, tetapi susunan workflow-nya tidak perlu dibongkar.
Alasan n8n menulis panduan ini juga perlu dipahami. Menurut blog resmi n8n, banyak bisnis kecil seperti klinik, kantor hukum, dan akuntan memegang data yang wajib tetap di bawah kendali mereka. Begitu data dikirim ke API cloud, data itu tinggal di perangkat keras pihak lain, mungkin di negara lain, dengan syarat yang bisa berubah.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Apa yang ditunjukkan n8n | Seperti apa susunan otomasi AI lokal yang sudah diuji? |
| Angka kecepatan | Seberapa cepat, dan kapan melambat? |
| Laptop RTX Spark | Apakah laptop baru NVIDIA mengubah peta? |
| Lokal atau cloud | Mana yang cocok untuk kondisiku? |
| Ringkasan | Apa yang dicek sebelum membeli perangkat? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Semua angka kecepatan berasal dari satu kali uji yang dilakukan penulis blog n8n pada 13 Oktober 2026, dan tercantum di bagian Sumber. Klaim spesifikasi perangkat berasal dari halaman resmi NVIDIA. Ini bukan tutorial pemasangan, jadi langkah teknis sengaja tidak saya tulis.
Artikel ini untuk pemilik usaha, staf operasional, dan pengguna n8n yang memegang data sensitif atau ingin tahu batas AI lokal. Kalau kamu baru mulai otomasi dan datamu tidak sensitif, artikel ini cukup kamu baca sebagai wawasan. Belum perlu membeli apa-apa.
Apa yang ditunjukkan n8n di DGX Spark
NVIDIA DGX Spark adalah komputer meja seukuran kotak kecil dengan chip GB10 Grace Blackwell. Halaman resminya menyebut CPU Grace hingga 20 inti, performa AI hingga 1 petaflop di presisi FP4, dan memori terpadu hingga 128 GB. Memori terpadu berarti CPU dan GPU memakai satu kolam memori yang sama, sehingga model besar tidak perlu dipecah ke kartu grafis terpisah.
Panduan n8n menyusun satu "kantor AI" di dalam kotak itu. Isinya tujuh model, masing-masing untuk satu jenis pekerjaan:
| Pekerjaan | Model | Lisensi |
|---|---|---|
| Chat, coding, membaca gambar, ekstraksi | Qwen3.6-35B-A3B (NVFP4) | Apache 2.0 |
| Embedding (mengubah teks jadi angka untuk pencarian) | Qwen3-Embedding-4B | Apache 2.0 |
| Reranking (mengurutkan hasil pencarian) | Qwen3-Reranker-0.6B | Apache 2.0 |
| Suara ke teks | whisper-large-v3-turbo | MIT |
| OCR dokumen | GLM-OCR | MIT |
| Membuat gambar | Z-Image-Turbo | Apache 2.0 |
| Teks ke suara | Kokoro-82M | Apache 2.0 |
Di depan semua model itu dipasang LiteLLM, yaitu gerbang yang menyatukan banyak model di balik satu alamat bergaya OpenAI. Setiap tim mendapat kunci sendiri, sehingga pemakaian tetap tercatat walaupun tidak ada tagihan per token. Dari sisi n8n, gerbang ini terlihat seperti OpenAI biasa.
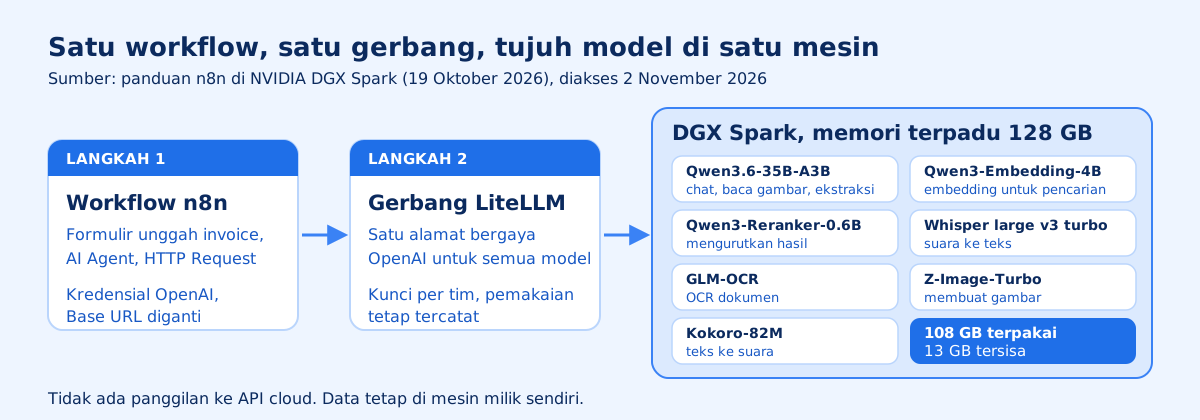
Contoh workflow yang diberikan n8n adalah pembaca invoice. Kamu mengunggah foto invoice ke formulir, lalu workflow mengembalikan nama pemasok, nomor, tanggal, total, dan mata uang. Template-nya tersedia di galeri workflow n8n. Dua pemakaian lain yang disebut adalah ringkasan rekaman telepon dan tanya jawab dari dokumen internal.
Saya suka pilihan desainnya: satu model teks yang kuat untuk semua pekerjaan berbasis teks. Penulisnya beralasan setiap model tambahan berarti satu kontainer lagi yang harus dikunci versinya, ditambal, dan dipantau. Ini pelajaran yang berlaku juga di cloud. Makin sedikit model, makin sedikit yang bisa rusak diam-diam.
Angka kecepatan dan di mana ia melambat
Semua angka di bab ini adalah hasil uji penulis blog n8n di satu DGX Spark. Ia sendiri menulis bahwa angkamu akan berbeda bila memakai image, model, atau prompt lain. Jadi baca sebagai gambaran, bukan janji.
| Pengguna serentak | Waktu ke token pertama (median) | Token per detik per pengguna |
|---|---|---|
| 1 | 0,11 detik | 120 |
| 4 | 0,21 detik | 68 |
| 8 | 0,29 detik | 47 |
Kecepatan per pengguna memang turun saat pengguna bertambah, tetapi total keluaran naik dari 87 ke 359 token per detik karena server melayani beberapa permintaan sekaligus. Pekerjaan lain juga cepat. Satu halaman OCR selesai 1,8 detik. Mengubah teks OCR menjadi data invoice terstruktur butuh 0,59 detik saat fitur "berpikir" model dimatikan. Saat fitur itu menyala, langkah yang sama butuh 12,1 detik karena model menulis lebih dari 1.500 token penalaran sebelum menjawab. Satu paragraf teks ke suara selesai 0,87 detik.
Pendapat saya: angka ekstraksi itu yang paling berguna untuk praktisi. Untuk pekerjaan berformat tetap seperti membaca invoice, model yang "berpikir" justru membuang waktu. Pelajaran ini sama berlakunya saat kamu memakai model cloud.
Batas yang ditulis terang-terangan
Bagian yang membuat saya percaya pada panduan ini justru daftar kelemahannya.
- Gambar memperlambat semuanya. Saat gambar dibuat terus-menerus, kecepatan chat satu pengguna turun dari 122 ke 38 token per detik, sekitar 69 persen lebih lambat. Penulisnya menyarankan antrean gambar di luar jam kerja, atau DGX Spark kedua khusus media.
- Memori hampir penuh. Dengan tujuh model menyala, mesin memakai 108 GB dan menyisakan 13 GB. Menyalakan enam layanan utama dari keadaan dingin butuh sekitar 12 menit.
- Hasil tetap perlu dicek. OCR membaca semua baris invoice uji dengan benar, tetapi kehilangan satu angka nol di nomor pajak. Whisper menambahkan kalimat "Thank you." yang tidak ada di rekaman.
- Lisensi lebih sulit daripada teknis. Penulisnya menyebut beberapa model gambar dan suara terbaik melarang pemakaian komersial. Ia hanya mengizinkan lisensi seperti Apache 2.0, MIT, dan CC-BY-4.0, dan mengingatkan bahwa tulisannya bukan nasihat hukum.
Laptop RTX Spark: apakah peta berubah?
Pada 28 Oktober 2026, blog NVIDIA mengumumkan laptop Windows bertenaga RTX Spark sudah tersedia dari ASUS, Dell, HP, Lenovo, Microsoft, dan MSI. Menurut NVIDIA, chipnya menggabungkan GPU Blackwell RTX dan CPU Grace dengan memori terpadu hingga 128 GB dan performa AI FP4 hingga 1 petaflop. Harga mulai 2.599 dolar AS, menurut NVIDIA.
Di atas kertas, angka itu sama dengan DGX Spark. NVIDIA juga mengumumkan pengaturan di NVIDIA App untuk membagi GPU antara aplikasi di layar dan agen yang berjalan di belakang. Ini menjawab masalah yang sama dengan temuan n8n: beberapa pekerjaan AI berebut satu GPU.
Yang belum bisa saya konfirmasi: belum ada panduan atau angka resmi n8n untuk laptop RTX Spark. Panduan n8n hanya diuji di DGX Spark yang menjalankan Linux. Laptop RTX Spark menjalankan Windows, dan perangkat lunak serta image kontainernya bisa berbeda. Jadi saya tidak akan mengasumsikan angka di bab sebelumnya berlaku di laptop.
Pendapat saya: laptop RTX Spark menarik untuk satu orang yang ingin membawa model besar ke mana-mana. Untuk melayani satu tim, saya tetap memilih mesin yang diam di kantor, menyala terus, dan tidak ikut terbawa pulang.
Lokal atau cloud: cara memilih
Empat pertanyaan ini membantu memutuskan.
- Apakah datanya boleh keluar? Kalau kontrak atau regulasi melarang, lokal hampir wajib. Kalau boleh, lanjut ke pertanyaan berikut.
- Berapa volumenya? Panduan n8n tidak memuat hitungan biaya, jadi ini pendapat saya: workflow yang dipanggil puluhan kali sehari jarang membenarkan pembelian perangkat khusus. Hitung dulu tagihan API bulananmu sebelum membandingkannya dengan harga mesin.
- Siapa yang merawat? Panduan n8n menuntut penguncian versi model, pemantauan memori, dan pengecekan lisensi. Tanpa orang yang mengurus, pilih cloud.
- Butuh model paling pintar? Panduan n8n hanya menunjukkan pekerjaan seperti ekstraksi, ringkasan, dan tanya jawab dokumen. Panduan itu tidak membandingkan mutu jawaban dengan model cloud, jadi saya tidak akan menganggap model lokal setara model cloud terbesar untuk penalaran rumit.
Ada jalan tengah yang saya sarankan: pisahkan per langkah. Langkah yang menyentuh data pribadi, misalnya OCR dan ekstraksi, berjalan lokal. Langkah yang hanya mengolah data yang sudah dianonimkan boleh tetap ke cloud. n8n memudahkan pola ini karena setiap node bisa memakai kredensial berbeda.
Kalau belum punya perangkat khusus, n8n menyediakan Self-hosted AI Starter Kit. Isinya n8n, Ollama untuk menjalankan model lokal, Qdrant sebagai basis data vektor, dan PostgreSQL. n8n sendiri menyebut kit ini untuk uji coba dan belum dioptimalkan untuk produksi. Panduan DGX Spark juga menjelaskan bedanya: Ollama cocok untuk satu orang, sedangkan vLLM melayani banyak pengguna sekaligus.
Ringkasan dan langkah berikutnya
Checklist sebelum membeli perangkat AI lokal
- Ada alasan data yang jelas: kontrak, regulasi, atau kewajiban profesi
- Volume pekerjaan AI per hari sudah dihitung, bukan ditebak
- Ada orang yang bertanggung jawab merawat model, kontainer, dan pembaruan
- Lisensi setiap model sudah dicek boleh dipakai komersial
- Workflow sudah dicoba dengan Starter Kit atau model kecil sebelum beli perangkat besar
- Ada rencana untuk pekerjaan gambar agar tidak memperlambat chat tim
- Ada langkah validasi untuk hasil OCR dan transkrip
Cheat sheet
| Kondisi | Saran saya |
|---|---|
| Data tidak sensitif, volume kecil | API cloud, langsung dari node n8n |
| Data sensitif, satu orang, sekadar mencoba | Self-hosted AI Starter Kit dengan Ollama |
| Data sensitif, satu tim, pekerjaan teks dan dokumen | Satu mesin AI di kantor, pola seperti panduan n8n di DGX Spark |
| Tim juga rutin membuat gambar | Pisahkan media ke mesin kedua atau jadwalkan di luar jam kerja |
| Butuh portabel, kerja sendiri | Laptop RTX Spark, dengan catatan performa n8n di sana belum terverifikasi |
Kalau kamu ingin menguasai dasarnya dulu, mulai dari cara menyusun workflow n8n yang memanggil model AI, termasuk mengganti penyedia model tanpa membongkar workflow. Materi itu ada di Kelas Automation, yang bisa kamu temukan di daftar Kelas eduwebmu. Setelah polanya paham, memindahkan model dari cloud ke mesin lokal sebagian besar soal mengganti kredensial dan alamat, ditambah penyesuaian kecil per node.
Pertanyaan yang sering diajukan
Apakah n8n bisa memakai model AI tanpa API cloud?
Bisa. n8n punya node dan kredensial Ollama, dan menurut blog resmi n8n, kredensial OpenAI di n8n menerima Base URL kustom, sehingga bisa diarahkan ke server model lokal yang kompatibel dengan format OpenAI.
Apa itu NVIDIA DGX Spark?
Komputer meja kecil dari NVIDIA dengan chip GB10 Grace Blackwell dan memori terpadu hingga 128 GB yang dipakai bersama CPU dan GPU. NVIDIA juga menjual varian 64 GB lewat mitra produsen.
Apakah laptop RTX Spark bisa menggantikan DGX Spark untuk n8n?
Spesifikasi chipnya mirip: hingga 128 GB memori terpadu dan hingga 1 petaflop performa AI FP4 menurut NVIDIA. Namun panduan n8n hanya diuji di DGX Spark, jadi performa n8n di laptop RTX Spark belum terverifikasi.
Apakah otomasi AI lokal pasti lebih murah daripada API cloud?
Belum tentu. Kamu membayar perangkat di depan, ditambah waktu untuk merawat model, kontainer, dan lisensi. Lokal cenderung masuk akal bila volume tinggi atau data memang dilarang keluar.
Model apa yang dipakai n8n di DGX Spark?
Panduan n8n memakai Qwen3.6-35B-A3B untuk teks dan gambar, Qwen3 Embedding dan Reranker, Whisper large v3 turbo, GLM-OCR, Z-Image-Turbo, dan Kokoro-82M. Semuanya berlisensi Apache 2.0 atau MIT.
Saya belum punya perangkat khusus AI. Bisa mulai dari mana?
n8n menyediakan Self-hosted AI Starter Kit berbasis Docker yang berisi n8n, Ollama, Qdrant, dan PostgreSQL. n8n sendiri menyebut kit ini untuk uji coba, belum siap produksi.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.n8n Blog, "Run your n8n AI workflows on NVIDIA DGX Spark, with no cloud API" (19 Oktober 2026)blog.n8n.io(buka di tab baru)
- 2.NVIDIA Blog, "Thin, Light and Built for Everything: NVIDIA RTX Spark Windows Laptops Gain New Models, Agent Tools and Games" (28 Oktober 2026)blogs.nvidia.com(buka di tab baru)
- 3.NVIDIA, halaman produk DGX Sparknvidia.com(buka di tab baru)
- 4.n8n Workflows, "Extract invoice details from images with DGX Spark OCR and Qwen3.6"n8n.io(buka di tab baru)
- 5.n8n Docs, "Deploy with the AI starter kit"docs.n8n.io(buka di tab baru)
- 6.n8n Docs, "Ollama credentials"docs.n8n.io(buka di tab baru)
n8nai-lokalself-hostednvidia