Rate limit dan backoff: kenapa otomasi gagal saat volume naik
Oleh Dedi NugrohoTerbit 17 menit baca
Daftar isi
Otomasi yang lancar dengan 20 data sering gagal dengan 2.000 data karena API tujuan membatasi jumlah permintaan per menit. Batas itu disebut rate limit, dan pelanggarannya biasanya dibalas error 429. Solusinya dua lapis: atur laju permintaan sejak awal, lalu mundur dengan jeda yang makin panjang (backoff) saat tetap kena batas.
Tesis saya: kegagalan karena rate limit hampir selalu masalah desain workflow, jarang masalah API. Batasnya tertulis di dokumentasi vendor, dan bisa dihitung sebelum workflow dijalankan. Workflow yang gagal saat ramai biasanya dirancang dengan asumsi diam-diam bahwa API akan menerima semua permintaan secepat n8n mengirimnya.
Yang perlu diluruskan dulu
Ada tiga salah kaprah yang sering muncul. Pertama, error 429 dianggap tanda API sedang rusak. Padahal API sedang bekerja persis sesuai aturan. Kedua, menyalakan Retry On Fail dianggap sudah menyelesaikan masalah. Retry hanya mengulang setelah gagal, dan kalau jedanya terlalu pendek, percobaan ulang ikut menabrak batas yang sama. Ketiga, banyak orang mengira batas berlaku per workflow. Kenyataannya, batas biasanya dihitung per akun, per project, atau per kunci API, sehingga beberapa workflow yang memakai kredensial sama saling berebut jatah.
Rate limit sendiri adalah aturan dari penyedia API tentang berapa banyak permintaan yang boleh kamu kirim dalam rentang waktu tertentu. API (application programming interface) adalah pintu yang dipakai satu aplikasi untuk berbicara dengan aplikasi lain. Setiap node n8n yang mengambil atau mengirim data ke layanan luar sedang mengetuk pintu itu.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Kenapa volume naik membuat workflow gagal | Apa yang berubah saat data bertambah dari puluhan ke ribuan? |
| Cara API menghitung batas | Apa itu 429, Retry-After, dan jenis-jenis penghitungan batas? |
| Backoff dan jitter | Bagaimana cara mundur yang tidak memperparah keadaan? |
| Peta alat di n8n | Fitur n8n mana yang menangani tiap lapis masalah? |
| Memilih pola per situasi | Pola mana yang saya pilih untuk kasus apa? |
| Ringkasan | Apa yang dicek sebelum workflow dibuka untuk volume besar? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Fakta tentang n8n diambil dari dokumentasi resmi dan artikel blog n8n tanggal 30 Oktober 2026. Fakta tentang 429 dan Retry-After diambil dari standar RFC. Angka kuota Google Sheets diambil dari halaman resmi Google. Saya tidak menjalankan uji beban khusus untuk artikel ini, jadi tidak ada angka hasil uji di sini.
Artikel ini untuk kamu yang sudah membuat workflow n8n atau alat otomasi serupa, lalu mulai melihat eksekusi gagal saat datanya membesar. Kalau kamu baru menyusun workflow pertama dengan beberapa baris data, simpan artikel ini untuk nanti. Masalahnya baru terasa ketika volumenya naik.
Kenapa volume naik membuat workflow gagal
Ambil contoh yang umum. Sebuah workflow membaca daftar pelanggan dari spreadsheet, lalu memanggil API untuk setiap baris. Saat diuji dengan 15 baris, semuanya hijau. Sebulan kemudian daftar itu berisi 1.800 baris, dan eksekusi berhenti di tengah dengan pesan error.
Penyebabnya ada di cara n8n bekerja. Menurut dokumentasi Loop Over Items, node n8n secara default dirancang untuk memproses daftar item. Satu item adalah satu baris data. Jadi node yang menerima 1.800 item akan berusaha memproses semuanya, dan kalau tiap item berarti satu panggilan API, permintaan keluar beruntun secepat yang bisa dikirim.
Batas yang dihitung per menit
Kebanyakan API menulis batasnya dalam satuan waktu pendek. Contoh yang jelas ada di halaman Usage limits Google Sheets API. Permintaan baca dibatasi 300 per menit per project dan 60 per menit per user per project. Permintaan tulis punya batas yang sama, dihitung terpisah. Google sendiri memberi contoh: kalau aplikasimu mengirim 350 permintaan dalam satu menit, 50 permintaan sisanya dibalas 429.
Angka 60 per menit itu yang paling sering mengejutkan. Itu berarti rata-rata satu permintaan per detik untuk satu user. Workflow yang menulis satu baris per panggilan akan menabrak batas ini dalam hitungan detik kalau tidak diberi jeda. Ada kabar baiknya juga. Google menyebut setiap batch request, termasuk semua subrequest di dalamnya, dihitung sebagai satu permintaan. Jadi menggabungkan banyak baris dalam satu panggilan jauh lebih hemat jatah. Ada alasan tambahan untuk tidak menabrak kuota. Halaman yang sama, diperbarui 3 September 2026, menyebut pemakaian di atas batas kuota direncanakan mulai ditagihkan ke akun Google Cloud Billing pada 2026. Detail tarif dan tanggal pastinya belum tercantum di halaman itu.
Beberapa eksekusi, satu jatah
Masalah kedua muncul ketika workflow dipicu dari luar, misalnya lewat webhook dari formulir atau toko online. Setiap kiriman memulai eksekusi baru. Saat promo berjalan dan seratus pesanan masuk berdekatan, seratus eksekusi bisa berjalan bersamaan dan semuanya memakai kredensial yang sama.
Menurut dokumentasi concurrency self-hosted, pada mode reguler n8n tidak membatasi jumlah eksekusi produksi yang berjalan bersamaan, dan pembatasan itu mati secara default. Di n8n Cloud, menurut halaman concurrency Cloud, batasnya mengikuti paket langganan. Artinya, di self-hosted mode reguler yang belum diatur, tidak ada rem bawaan yang mencegah seratus eksekusi menyerbu satu API sekaligus.
Cara API menghitung batas, dan apa arti 429
Ketika permintaan ditolak karena melewati batas, server biasanya membalas dengan kode status HTTP 429. Kode ini didefinisikan di RFC 6585 tahun 2012 dengan nama "Too Many Requests". Bunyinya sederhana: pengguna mengirim terlalu banyak permintaan dalam rentang waktu tertentu.
Di n8n, menurut halaman Handle rate limits, node yang menerima 429 akan error dengan pesan "The service is receiving too many requests from you". Kalau kamu melihat kalimat itu di panel output, jangan buru-buru mengganti kredensial atau menyalahkan server. Itu tanda workflow mengirim lebih cepat dari jatahnya.
Retry-After: server memberi tahu kapan boleh kembali
RFC 6585 menyebut respons 429 boleh menyertakan header Retry-After. Header adalah informasi tambahan yang ikut dalam respons, di luar isi utamanya. Menurut RFC 9110, nilainya bisa berupa tanggal dan jam, atau jumlah detik yang harus ditunggu. Contoh di RFC: nilai 120 berarti tunggu dua menit.
Kata kuncinya "boleh". Tidak semua API mengirim Retry-After. Kalau ada, pakai angka itu dan jangan menebak. Kalau tidak ada, workflow perlu strategi jeda sendiri, dan di situlah backoff masuk.
RFC 6585 juga menegaskan satu hal yang sering dilupakan. Standar itu tidak mengatur cara server mengenali pengguna atau cara menghitung permintaan. Contoh di RFC itu: server bisa menghitung per sumber daya, untuk seluruh server, atau bahkan gabungan beberapa server, dan bisa mengenali pengguna dari kredensial atau cookie. Jadi dua API dengan angka batas sama bisa berperilaku sangat berbeda.
Rate limiting dan throttling tidak sama
Artikel blog n8n berjudul Throttling vs. Rate Limiting, terbit 30 Oktober 2026, membedakan keduanya dengan jelas. Rate limiting menolak permintaan yang melewati batas, sering dengan 429. Throttling memperlambat atau mengantrekan permintaan saat lalu lintas tinggi. Pada throttling, workflow tidak gagal, tetapi responsnya datang lebih lambat.
Perbedaan ini berpengaruh ke desain. Pada rate limiting, workflow harus memutuskan kapan mencoba lagi. Pada throttling, blog n8n mengingatkan bahwa workflow tetap harus memperhitungkan jeda itu, terutama bila langkah berikutnya bergantung pada respons. Menurut saya, yang perlu dicek di sini adalah opsi Timeout di HTTP Request node, yang membatalkan permintaan bila server terlalu lama mulai menjawab. Di kedua kasus, penyedia API yang memegang aturan. Kamu hanya mengatur cara workflow menyesuaikan diri.
Empat cara menghitung batas
Blog n8n yang sama menjelaskan beberapa algoritma yang dipakai penyedia API. Saya ringkas dalam tabel karena datanya memang perbandingan.
| Cara menghitung | Cara kerjanya | Akibat untuk workflow |
|---|---|---|
| Fixed window | Jatah dihitung per interval tetap, lalu direset di awal interval berikutnya | Bisa terjadi lonjakan di sekitar pergantian interval |
| Sliding window | Jatah dihitung dalam rentang waktu yang terus bergeser, misalnya 60 detik terakhir | Menunggu pergantian menit belum tentu langsung memulihkan jatah penuh |
| Token bucket | Jatah terisi pelan seperti token di ember, yang tidak terpakai bisa menumpuk sampai kapasitas | Boleh mengirim beberapa permintaan sekaligus selama token cukup |
| Leaky bucket | Permintaan masuk antrean dan keluar dengan laju tetap | Lonjakan diratakan, kiriman beruntun tidak dihargai |
Pelajaran praktisnya: pola kiriman yang aman di satu API bisa bermasalah di API lain. Blog n8n menyarankan membaca dokumentasi rate limit penyedia sebelum memutuskan seberapa agresif mengelompokkan atau memberi jeda pada permintaan. Saya setuju, dan menambahkan satu kebiasaan. Catat satuan batasnya (per detik, per menit, per hari) di catatan workflow, supaya orang berikutnya tidak perlu mencari ulang.
Backoff dan jitter: cara mundur yang benar
Backoff adalah strategi memberi jeda sebelum mencoba ulang permintaan yang gagal. Versi yang paling umum adalah exponential backoff, yaitu jeda yang berlipat dua setiap kali gagal. Blog n8n memberi contoh urutan 1, 2, 4, lalu 8 detik.
Logikanya masuk akal. Kalau API bilang kamu terlalu cepat, mencoba lagi sedetik kemudian hampir pasti ditolak lagi. Jeda yang terus memanjang memberi waktu bagi jatah untuk terisi kembali.
Batasi jeda dan jumlah percobaan
Backoff tanpa batas berbahaya. Workflow bisa terus menunggu dan mencoba berjam-jam untuk masalah yang sebenarnya tidak akan selesai sendiri, misalnya kredensial yang dicabut. Blog n8n menyarankan dua batas: jeda maksimum dan jumlah percobaan maksimum.
Google merinci hal yang sama di halaman Usage limits Sheets API dengan nama truncated exponential backoff. Jedanya naik 1, 2, 4 detik dan seterusnya, ditambah angka acak sampai 1.000 milidetik. Kenaikan berhenti di batas maksimum, yang menurut Google biasanya 32 atau 64 detik. Setelah itu, percobaan boleh berlanjut dengan jeda tetap, tetapi Google juga menegaskan klien harus dicegah mencoba tanpa akhir.
Jitter: sedikit acak supaya tidak serempak
Bayangkan dua puluh eksekusi gagal pada detik yang sama karena lonjakan. Kalau semuanya memakai backoff yang identik, mereka akan mencoba ulang bersamaan juga, lalu gagal bersamaan lagi. Gelombang ini berulang di setiap tahap.
Jitter adalah tambahan jeda acak kecil pada setiap percobaan, supaya percobaan ulang tersebar. Ide ini dijelaskan panjang oleh Marc Brooker dalam tulisan Exponential Backoff And Jitter di blog arsitektur AWS tahun 2015. Dalam simulasinya dengan 100 klien yang berebut sumber daya, menambahkan jitter memangkas jumlah panggilan lebih dari separuh. Tulisan itu membandingkan tiga varian, yaitu Full Jitter, Equal Jitter, dan Decorrelated Jitter. Kesimpulan penulisnya, backoff dengan jitter layak dijadikan pendekatan standar untuk klien yang memanggil layanan jarak jauh.
Angka "lebih dari separuh" itu hasil simulasi untuk kasus tertentu di tulisan tersebut. Jangan dibaca sebagai jaminan untuk workflow kamu. Yang bisa dipegang adalah arahnya: tanpa jitter, percobaan ulang cenderung datang bergerombol.
Pastikan permintaan aman diulang
Ini bagian yang paling sering diabaikan pemula. Mencoba ulang permintaan baca data relatif aman. Mencoba ulang permintaan yang mengubah sesuatu bisa berbahaya. Contohnya membuat invoice, mengirim WhatsApp, atau memotong stok.
Masalahnya, kadang permintaan sebenarnya berhasil di server, tetapi responsnya tidak sampai ke n8n. Workflow mengira gagal, lalu mengirim ulang. Hasilnya pelanggan menerima dua pesan yang sama. Blog n8n menyarankan memeriksa apakah API mendukung idempotensi sebelum menyalakan retry otomatis. Idempotensi artinya permintaan yang sama boleh dikirim berkali-kali dengan hasil akhir yang tetap satu. Biasanya ini diwujudkan dengan kunci unik yang dikirim bersama permintaan.
Peta alat di n8n untuk tiap lapis
Blog n8n merangkum urutannya dengan baik: atur laju permintaan dulu, lalu pakai retry dan penanganan error sebagai pengaman ketika batas tetap tersentuh. Saya membaginya menjadi tiga lapis.
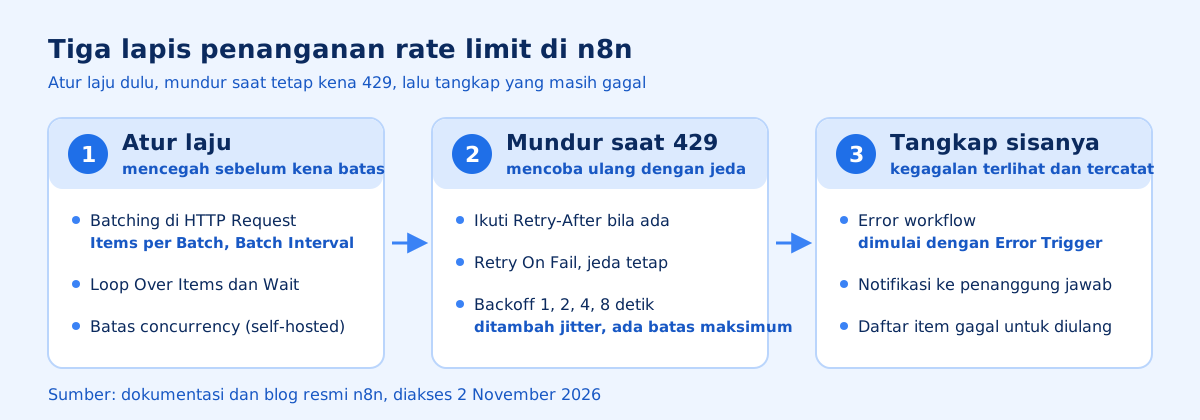
Lapis 1: atur laju sebelum menabrak batas
Untuk API dengan batas yang bisa diprediksi, mencegah lebih baik daripada memulihkan. n8n punya tiga alat di lapis ini.
Batching di HTTP Request node. Menurut dokumentasi HTTP Request node, opsi Batching punya dua isian. Items per Batch menentukan jumlah item per kelompok, dan Batch Interval menentukan jeda antar kelompok dalam milidetik. Dokumentasi Handle rate limits menyebut opsi ini setara dengan memakai Loop Over Items dan Wait. Blog n8n menautkan template Avoid rate limiting by batching HTTP requests di galeri n8n.io sebagai contoh polanya. Perlu dicatat, menurut deskripsinya template itu memakai node Split In Batches (nama lama Loop Over Items) dan Wait, bukan opsi Batching.
Loop Over Items dan Wait. Pola ini untuk node aplikasi selain HTTP Request, misalnya node Google Sheets atau OpenAI. Dokumentasi menyarankan Loop Over Items untuk memecah data menjadi kelompok kecil, lalu node Wait setelah node yang memanggil API. Node Wait menghentikan eksekusi sementara. Menurut dokumentasi Wait, saat berhenti, data eksekusi dipindahkan ke database lalu dimuat lagi ketika waktunya tiba. Pengecualiannya, jeda di bawah 65 detik tidak dipindahkan ke database, prosesnya tetap berjalan sampai jeda selesai.
Batas concurrency. Concurrency adalah jumlah eksekusi yang berjalan bersamaan. Di self-hosted, admin bisa menyalakan batas lewat variabel lingkungan N8N_CONCURRENCY_PRODUCTION_LIMIT. Eksekusi yang melebihi batas masuk antrean dan diproses berurutan (FIFO, yang masuk pertama diproses pertama). Ada tiga catatan dari dokumentasinya. Batas ini hanya berlaku untuk eksekusi produksi dari webhook atau trigger. Eksekusi yang masih antre tidak bisa di-retry. Membatalkan eksekusi yang antre juga mengeluarkannya dari antrean.
Lapis 2: mundur saat tetap kena 429
Retry On Fail adalah pengaturan di tab Settings setiap node. Menurut dokumentasi node, saat diaktifkan, node dijalankan ulang ketika gagal. Halaman Handle rate limits menyarankan mengisi Wait Between Tries (ms) lebih besar dari jendela batas API. Contohnya, kalau API mengizinkan satu permintaan per detik, isi 1000 milidetik.
Batasnya perlu dipahami. Pengaturan ini memberi jeda yang sama di setiap percobaan. Blog n8n menyebut, untuk kasus yang lebih rumit seperti jeda yang makin panjang di tiap percobaan, kamu perlu merakit logika retry sendiri di dalam workflow. Jadi Retry On Fail bawaan lebih mirip retry dengan jeda tetap daripada exponential backoff penuh.
Untuk membaca Retry-After, HTTP Request node punya opsi Include Response Headers and Status yang mengembalikan header dan kode status, tidak hanya isi respons. Ada juga opsi Never Error yang membuat node tetap dianggap berhasil walau kode statusnya bukan 2xx. Kombinasi keduanya memungkinkan workflow membaca kode 429 dan header Retry-After, lalu menentukan sendiri berapa lama menunggu. Ini sudah masuk wilayah desain lanjutan, dan tidak saya bahas langkah teknisnya di sini.
Lapis 3: tangkap yang tetap gagal
Sebagian permintaan akan tetap gagal walau sudah dicoba berulang. Jangan biarkan kegagalan itu hanya tercatat di riwayat eksekusi yang jarang dibuka. Menurut dokumentasi Error Trigger, kamu bisa membuat error workflow, yaitu workflow terpisah yang berjalan otomatis ketika workflow lain gagal. Menurut panduan error handling n8n, satu error workflow boleh dipakai untuk banyak workflow.
Error workflow menerima data seperti nama workflow, pesan error, dan node terakhir yang dijalankan. Dari situ kamu bisa mengirim notifikasi, mencatat item yang gagal, atau menjadwalkan pemrosesan ulang. Satu hal yang perlu diketahui: error workflow tidak bisa diuji lewat eksekusi manual. Error Trigger hanya berjalan ketika workflow otomatis gagal.
Pengaturan On Error di setiap node juga relevan. Pilihan Continue (using error output) meneruskan informasi error ke node berikutnya. Ini berguna kalau kamu ingin item yang gagal dikumpulkan dan diproses ulang, tanpa menghentikan seluruh eksekusi.
Memilih pola per situasi
Teori di atas baru berguna kalau bisa dipetakan ke keputusan. Berikut pilihan saya untuk situasi yang paling sering muncul di workflow bisnis kecil dan menengah.
| Situasi | Pola yang saya pilih | Alasannya |
|---|---|---|
| Ratusan sampai ribuan baris dikirim ke satu API lewat HTTP Request | Batching di HTTP Request, jeda dihitung dari batas API | Satu node, mudah dibaca, setara Loop Over Items dan Wait |
| Node aplikasi (Google Sheets, OpenAI, CRM) memproses banyak item | Loop Over Items dan Wait | Pola yang disarankan dokumentasi n8n untuk node integrasi |
| Workflow dipicu webhook dengan lonjakan sesaat | Batas concurrency (self-hosted) dan Retry On Fail dengan jeda memadai | Mengurangi eksekusi yang menyerbu bersamaan |
| API mengirim Retry-After | Baca header lewat HTTP Request, tunggu sesuai angkanya | Server sudah memberi jawaban pasti, tidak perlu menebak |
| Node yang mengirim pesan atau membuat transaksi | Atur laju di depan, retry otomatis hanya bila API mendukung idempotensi | Risiko aksi ganda lebih mahal dari kegagalan |
| Kegagalan yang tetap tersisa | Error workflow dengan notifikasi dan daftar item gagal | Kegagalan terlihat dan bisa diproses ulang |
Hitung dulu, baru atur jeda
Saya lebih suka menghitung jeda dari angka batas daripada menebak. Ambil Google Sheets dengan batas 60 permintaan tulis per menit per user. Itu berarti satu permintaan per detik. Saya sarankan memberi ruang sedikit di bawah batas, karena workflow lain di akun yang sama mungkin ikut memakai jatah. Lebih baik lagi, kurangi jumlah permintaannya dengan menggabungkan baris ke satu batch request, karena Google menghitung satu batch sebagai satu permintaan.
Prinsip yang sama berlaku untuk layanan lain. Cari angka batasnya, cari satuannya, cari apakah batas itu per user, per project, atau per kunci API. Setelah tiga angka itu jelas, jeda bisa dihitung dengan kalkulator biasa.
Yang tidak saya sarankan
Saya tidak menyarankan menyalakan Retry On Fail di semua node sebagai kebiasaan. Di node yang membaca data, risikonya kecil. Di node yang mengirim email ke pelanggan, risikonya pesan dobel. Saya juga tidak menyarankan menaikkan jeda sampai sangat besar hanya supaya aman. Workflow yang menunggu terlalu lama bisa melewati jam kerja tim yang menunggu hasilnya, dan masalah ini tidak terlihat sampai ada yang mengeluh.
Satu lagi: jangan mengandalkan paket berbayar API sebagai satu-satunya jalan keluar. Menaikkan paket kadang memang perlu. Tetapi workflow yang tidak punya pengaturan laju akan menabrak batas baru begitu volumenya naik lagi.
Kapan masalahnya bukan rate limit
Tidak semua kegagalan saat volume naik berasal dari batas API. Google menyebut satu permintaan Sheets yang diproses lebih dari 180 detik akan dibalas error timeout. Itu masalah waktu proses, bukan kuota. Untuk mempercepat permintaan, Google menyarankan muatan maksimal 2 MB per permintaan. Di sisi n8n, terlalu banyak eksekusi bersamaan bisa membuat instance lambat atau tidak responsif, seperti yang disebut dokumentasi concurrency. Gejalanya mirip, penyebabnya berbeda. Baca pesan error-nya sebelum memilih obat.
Ringkasan dan langkah berikutnya
Rate limit adalah aturan main, dan workflow yang baik dirancang mengikuti aturan itu sejak awal. Lapis pertama mengatur laju. Lapis kedua mundur dengan sopan saat tetap kena batas. Lapis ketiga memastikan kegagalan yang tersisa terlihat dan bisa diproses ulang.
Checklist sebelum workflow dibuka untuk volume besar
- Batas tiap API yang dipanggil sudah dicatat, lengkap dengan satuan waktunya
- Sudah jelas apakah batas dihitung per user, per project, atau per kunci API
- Node yang memanggil API dengan banyak item sudah diberi Batching atau Loop Over Items dengan Wait
- Jeda dihitung dari angka batas, dengan ruang untuk workflow lain yang memakai kredensial sama
- Retry On Fail hanya aktif di node yang aman diulang
- Node yang mengirim pesan atau membuat transaksi sudah dicek dukungan idempotensinya
- Error workflow sudah dipasang dan mengirim notifikasi ke orang yang tepat
- Workflow sudah dicoba dengan volume yang mendekati kondisi nyata, bukan hanya beberapa baris
Cheat sheet
| Istilah | Arti singkat |
|---|---|
| Rate limit | Batas jumlah permintaan dalam rentang waktu tertentu |
| 429 Too Many Requests | Kode status saat permintaan ditolak karena melewati batas (RFC 6585) |
| Retry-After | Header berisi detik atau waktu kapan boleh mencoba lagi (RFC 9110) |
| Throttling | Permintaan diperlambat atau diantrekan, tidak langsung ditolak |
| Exponential backoff | Jeda percobaan ulang yang berlipat, misalnya 1, 2, 4, 8 detik |
| Jitter | Tambahan jeda acak supaya percobaan ulang tidak serempak |
| Idempotensi | Permintaan yang sama boleh diulang tanpa hasil ganda |
| Batching (HTTP Request) | Items per Batch dan Batch Interval untuk mengatur laju |
| Retry On Fail | Pengaturan node untuk mengulang otomatis dengan jeda tetap |
| Error workflow | Workflow terpisah yang berjalan saat workflow lain gagal |
Langkah berikutnya yang paling praktis adalah membedah workflow yang sudah kamu punya. Buka workflow yang paling banyak memanggil API, lalu cari node mana yang menerima banyak item tanpa jeda. Kalau workflow itu buatan orang lain dan alurnya belum jelas, n8n Workflow Explainer di eduwebmu bisa membantu kamu memahami urutan node-nya. Dari situ, tandai node yang perlu diberi pengaturan laju dengan bantuan checklist di atas.
Pertanyaan yang sering diajukan
Apa arti error 429 Too Many Requests?
Server menolak permintaan karena kamu mengirim terlalu banyak dalam rentang waktu tertentu. Kode ini didefinisikan di RFC 6585, dan responsnya boleh menyertakan header Retry-After yang menyebut berapa lama harus menunggu.
Apa beda rate limiting dan throttling?
Rate limiting menolak permintaan yang melewati batas, biasanya dengan error 429. Throttling memperlambat atau mengantrekan permintaan, sehingga workflow tidak gagal tetapi responsnya lebih lama.
Apakah Retry On Fail di n8n sudah cukup untuk mengatasi rate limit?
Untuk lonjakan kecil, sering cukup. Untuk volume besar, Retry On Fail hanya mengulang setelah gagal, jadi tetap perlu pengaturan laju di depan seperti Batching di HTTP Request node atau Loop Over Items dengan Wait.
Berapa batas permintaan Google Sheets API?
Menurut halaman Usage limits resmi Google, baca dan tulis masing-masing dibatasi 300 permintaan per menit per project dan 60 per menit per user per project. Kuotanya diisi ulang tiap menit.
Kenapa backoff perlu jitter?
Tanpa jitter, banyak eksekusi yang gagal bersamaan akan mencoba ulang bersamaan juga dan memicu lonjakan baru. Jitter menambahkan jeda acak kecil supaya percobaan ulang tersebar.
Apakah semua permintaan aman dicoba ulang otomatis?
Tidak. Permintaan yang punya efek samping, misalnya membuat tagihan atau mengirim pesan, bisa terjadi dua kali. Cek dulu apakah API tujuan mendukung idempotensi sebelum menyalakan retry otomatis.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.n8n Blog, "Throttling vs. Rate Limiting: Backoff Strategies for Workflows" (30 Oktober 2026)blog.n8n.io(buka di tab baru)
- 2.n8n Docs, "Handle rate limits"docs.n8n.io(buka di tab baru)
- 3.n8n Docs, "HTTP Request" (opsi Batching dan Response)docs.n8n.io(buka di tab baru)
- 4.n8n Docs, "Loop Over Items (Split in Batches)"docs.n8n.io(buka di tab baru)
- 5.n8n Docs, "Wait"docs.n8n.io(buka di tab baru)
- 6.n8n Docs, "Work with nodes" (Retry On Fail, On Error)docs.n8n.io(buka di tab baru)
- 7.n8n Docs, "Control concurrency" (self-hosted)docs.n8n.io(buka di tab baru)
- 8.n8n Docs, "Understand concurrency" (n8n Cloud)docs.n8n.io(buka di tab baru)
- 9.n8n Docs, "Error Trigger"docs.n8n.io(buka di tab baru)
- 10.n8n Docs, "Error handling" (error workflow)docs.n8n.io(buka di tab baru)
- 11.n8n Workflow Template, "Avoid rate limiting by batching HTTP requests"n8n.io(buka di tab baru)
- 12.IETF, RFC 6585 "Additional HTTP Status Codes", bagian 4 (429 Too Many Requests)rfc-editor.org(buka di tab baru)
- 13.IETF, RFC 9110 "HTTP Semantics", bagian 10.2.3 (Retry-After)rfc-editor.org(buka di tab baru)
- 14.Google for Developers, "Usage limits" Google Sheets API (diperbarui 3 September 2026)developers.google.com(buka di tab baru)
- 15.AWS Architecture Blog, Marc Brooker, "Exponential Backoff And Jitter" (4 Maret 2015)aws.amazon.com(buka di tab baru)
n8notomasiapirate limit