Crawler AI dan website-mu: cara mengatur izin training dan asisten
Oleh Dedi NugrohoTerbit 14 menit baca
Daftar isi
Crawler AI yang mampir ke website-mu tidak satu jenis. Ada yang mengumpulkan bahan training model, ada yang mengindeks untuk fitur pencarian AI, dan ada yang membuka halaman karena seseorang bertanya ke chatbot. Ketiganya bisa diatur terpisah lewat robots.txt, dan untuk bot yang tidak patuh, lewat firewall. Keputusan terbaik biasanya bukan "blokir semua".
Tesis artikel ini: atur izin per tugas, jangan per merek. Banyak pemilik situs memblokir "bot OpenAI" atau "bot Google" secara pukul rata, lalu bingung kenapa situsnya tidak pernah dikutip ChatGPT atau Gemini. Pertanyaan yang lebih berguna: konten saya boleh dipakai untuk apa? Melatih model? Ditampilkan di hasil pencarian AI? Dibacakan ke pengguna yang menempelkan tautan saya? Jawabannya bisa berbeda untuk tiap pertanyaan.
Yang perlu diluruskan dulu
Kesalahpahaman paling umum adalah menganggap semua bot AI sama dengan "pencuri konten untuk training". Kenyataannya, vendor besar kini memisahkan bot mereka berdasarkan tugas. OpenAI, misalnya, punya GPTBot untuk training dan OAI-SearchBot untuk pencarian. Menurut dokumentasi crawler OpenAI, setiap pengaturan berdiri sendiri. Kamu bisa mengizinkan yang satu dan menolak yang lain.
Kesalahpahaman kedua: robots.txt dianggap pagar. robots.txt adalah file teks di akar domain yang berisi aturan untuk crawler, yaitu program yang menjelajahi halaman web secara otomatis. Standar resminya, RFC 9309, menyatakan terang bahwa aturan itu bukan bentuk otorisasi akses. Artinya robots.txt adalah permintaan sopan. Bot yang patuh mengikutinya, bot nakal tidak.
Kesalahpahaman ketiga: memblokir sekarang akan menghapus konten yang sudah terlanjur dipakai. Tidak ada dokumentasi vendor yang saya baca menjanjikan itu. Bahasa yang dipakai selalu merujuk ke masa depan.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Tiga jenis bot AI | Bot apa saja yang datang, dan apa tugas masing-masing? |
| Cara kerja robots.txt | Bagaimana aturan dibaca, dan di mana batasnya? |
| Sinyal bersama AIPREF | Apa kabar terbaru soal satu sinyal untuk semua vendor? |
| Lapisan firewall | Kapan perlu menghadang bot di level server? |
| Cara memilih | Aturan apa yang cocok untuk jenis website saya? |
| Ringkasan | Apa yang harus dicek minggu ini? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Fakta tentang nama bot dan perilakunya diambil dari dokumentasi resmi OpenAI, Anthropic, Google, Vercel, dan dokumen IETF. Pengumuman OpenAI tanggal 30 Oktober 2026 tentang preferensi training tidak bisa saya buka langsung saat menulis, jadi detail komitmen OpenAI di bab AIPREF saya tandai belum terverifikasi. Artikel ini juga tidak menguji perilaku bot di server mana pun.
Artikel ini untuk kamu yang punya website bisnis, blog, toko online, atau dokumentasi produk, dan ingin memutuskan sikap terhadap AI tanpa harus jadi ahli server. Kalau kamu butuh panduan teknis menulis file robots.txt baris per baris, artikel ini bukan tempatnya. Fokusnya keputusan, bukan sintaks.
Tiga jenis bot AI yang mampir ke website-mu
Supaya keputusannya jernih, kelompokkan bot AI berdasarkan tugasnya. Pengelompokan ini saya ambil dari cara vendor sendiri mendokumentasikan bot mereka.
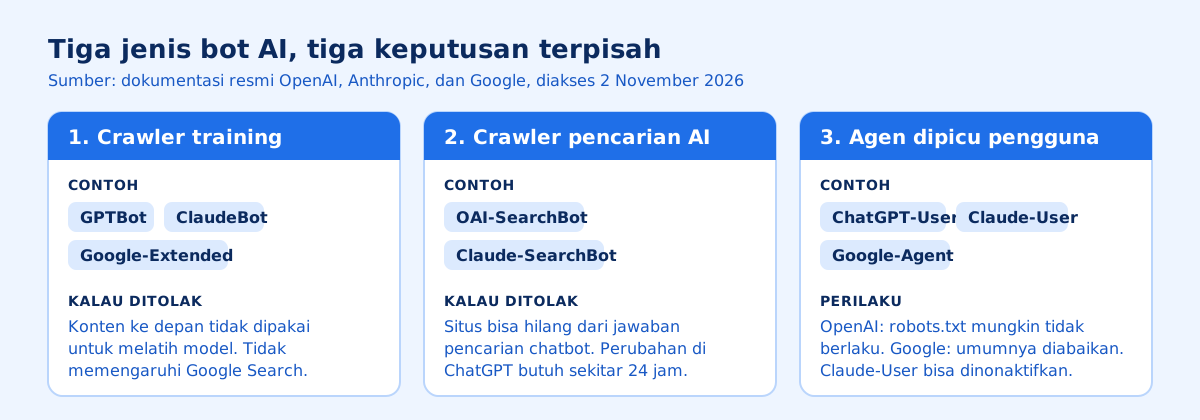
Crawler training
Tugasnya mengumpulkan konten publik yang mungkin dipakai untuk melatih model AI generatif. Contohnya GPTBot milik OpenAI dan ClaudeBot milik Anthropic. Menurut halaman bantuan Anthropic, membatasi ClaudeBot menandakan bahwa materi situs di masa depan harus dikecualikan dari dataset training mereka.
Google berbeda. Google-Extended bukan bot terpisah. Menurut dokumentasi crawler Google, ia tidak punya user agent sendiri di permintaan HTTP. Pengambilan halaman tetap dilakukan crawler Google biasa, dan Google-Extended hanya berfungsi sebagai token kontrol di robots.txt. Token ini mengatur apakah konten boleh dipakai untuk melatih generasi Gemini berikutnya dan untuk grounding di Gemini Apps serta Vertex AI. Grounding artinya menyuntikkan konten dari indeks pencarian ke model saat menjawab, supaya jawabannya lebih faktual.
Yang sering terlewat: Google menyatakan Google-Extended tidak memengaruhi apakah situsmu masuk Google Search, dan tidak dipakai sebagai sinyal peringkat. Jadi memblokirnya tidak merugikan SEO tradisional.
Crawler pencarian AI
Tugasnya mengindeks halaman supaya bisa muncul dan dikutip di fitur pencarian chatbot. OpenAI memakai OAI-SearchBot. Situs yang menolak OAI-SearchBot tidak akan ditampilkan di jawaban pencarian ChatGPT, walau masih bisa muncul sebagai tautan navigasi. OpenAI juga menyebut perubahan robots.txt butuh sekitar 24 jam sebelum sistem pencariannya menyesuaikan.
Anthropic punya Claude-SearchBot dengan peran serupa. Menurut Anthropic, menonaktifkannya bisa mengurangi visibilitas dan akurasi situsmu di hasil pencarian pengguna.
Agen yang dipicu pengguna
Ini jenis yang paling sering disalahpahami. Bot ini datang karena seseorang meminta, misalnya menempelkan tautan artikelmu ke ChatGPT lalu bertanya "ringkas ini". OpenAI memakai ChatGPT-User dan Anthropic memakai Claude-User. Google punya beberapa fetcher, salah satunya Google-Agent, yang dipakai agen di infrastruktur Google untuk menjelajah web dan bertindak atas permintaan pengguna.
Perilakunya terhadap robots.txt tidak seragam:
- OpenAI menulis bahwa karena aksi ChatGPT-User dipicu pengguna, aturan robots.txt mungkin tidak berlaku.
- Google menulis di halaman fetcher yang dipicu pengguna bahwa fetcher jenis ini umumnya mengabaikan robots.txt.
- Anthropic justru menyebut Claude-User bisa dinonaktifkan pemilik situs, dengan konsekuensi sistemnya tidak bisa mengambil kontenmu untuk menjawab pertanyaan pengguna.
Ada satu bot lagi yang tidak masuk tiga kelompok ini: OAI-AdsBot. Menurut OpenAI, bot ini hanya mengunjungi halaman yang didaftarkan sebagai iklan di ChatGPT, dan datanya tidak dipakai untuk melatih model. Kalau kamu tidak beriklan di ChatGPT, kamu tidak perlu memikirkannya.
Cara kerja robots.txt dan batasnya
robots.txt bekerja dengan kelompok aturan. Setiap kelompok diawali nama bot yang dituju, lalu diikuti daftar jalur yang boleh atau tidak boleh diakses. Ada juga kelompok bertanda bintang yang berlaku untuk semua bot yang tidak disebut namanya. Bot yang patuh mencari kelompok dengan namanya sendiri dulu. Kalau tidak ada, ia memakai kelompok bintang.
Konsekuensi praktisnya sederhana. Kalau kamu ingin menolak GPTBot tapi mengizinkan OAI-SearchBot, kamu menulis dua kelompok terpisah dengan nama masing-masing. Kalau kamu hanya menulis satu aturan bintang yang melarang semua, kamu ikut menolak Googlebot dan seluruh mesin pencari. Ini kesalahan yang bisa menghapus situsmu dari Google.
Tiga batas yang perlu kamu pahami sebelum terlalu berharap:
Pertama, robots.txt hanya permintaan. RFC 9309 menyebutnya bukan bentuk otorisasi akses. Vendor besar menyatakan patuh. Anthropic, misalnya, menulis bahwa bot mereka menghormati arahan standar robots.txt dan tidak akan mencoba menembus CAPTCHA. Bot dari pihak yang tidak menyatakan apa pun tidak terikat janji serupa.
Kedua, setiap subdomain butuh robots.txt sendiri. Anthropic secara khusus mengingatkan hal ini. Kalau blog kamu ada di blog.namadomain.com dan toko di toko.namadomain.com, keduanya perlu diatur.
Ketiga, user agent bisa dipalsukan. Google menulis peringatan ini di dokumentasinya. Siapa pun bisa mengaku sebagai GPTBot. Karena itu OpenAI, Anthropic, dan Google menerbitkan daftar alamat IP resmi bot mereka, supaya pemilik server bisa memeriksa apakah sebuah permintaan memang datang dari vendor itu.
Anthropic juga mendukung arahan Crawl-delay, yaitu permintaan agar bot memberi jeda antarkunjungan. Anthropic menyebutnya ekstensi non-standar. Ini berguna kalau masalahmu adalah server yang berat karena terlalu sering dikunjungi, bukan soal izin konten.
Sinyal bersama AIPREF: satu baris untuk semua vendor
Masalah terbesar pendekatan per bot adalah daftarnya terus bertambah. Setiap vendor baru membawa nama token baru, dan pemilik situs harus terus memperbarui robots.txt. Kelompok kerja AI Preferences (AIPREF) di IETF, badan yang menyusun standar internet, sedang menggarap jalan keluarnya.
Apa yang sudah terkonfirmasi
Dokumen yang relevan adalah draf Machine-Readable Training Preference Signal bertanggal 30 Oktober 2026. Penulisnya Kevin Kelley, dengan afiliasi Anthropic tercantum di bagian alamat penulis. Datatracker IETF mencatatnya sebagai draf individu yang belum didukung IETF dan belum punya kedudukan formal di proses standar. Isinya mendefinisikan satu token kebijakan bernama __usage_ai-training. Token ini ditulis di baris nama bot, seolah-olah nama crawler, padahal tidak ada bot dengan nama itu.
Cara kerjanya menurut draf tersebut:
- Kalau sebuah jalur dilarang untuk token itu, artinya pemilik situs menolak kontennya dipakai untuk training AI. Kalau diizinkan, artinya setuju.
- Aturan bintang tidak dihitung. Kalau tidak ada kelompok bernama
__usage_ai-training, berarti tidak ada preferensi yang dinyatakan. - Preferensi bisa diatur per jalur. Contoh di draf: menolak training untuk seluruh situs kecuali folder press kit.
- Token ini bukan perintah crawling. Ia menyatakan pemakaian konten, sedangkan aturan untuk crawler tertentu tetap berlaku terpisah.
- Token khusus vendor boleh dianggap lebih spesifik, dan perjanjian privat boleh mengesampingkan preferensi ini.
Definisi "AI training" yang dipakai mengikuti draf kosakata AIPREF, draft-ietf-aipref-vocab-08: memakai sebuah aset untuk mengubah parameter yang dipelajari model AI generatif. Draf kosakata itu juga mendefinisikan kategori lain, yaitu "AI Use" dan "Search". Draf itu sendiri menulis bahwa isinya belum mencerminkan konsensus kelompok kerja. Draf ketiga, draft-ietf-aipref-attach-05, membahas cara menempelkan preferensi ke konten lewat robots.txt dan lewat header HTTP bernama Content-Usage.
Google sudah memberi komitmen tertulis. Di dokumentasi crawler-nya yang diperbarui 30 Oktober 2026, Google menyatakan berniat mendukung sinyal preferensi training AIPREF dengan token __usage_ai-training pada awal 2027.
Yang belum terverifikasi
Ada pengumuman OpenAI bertanggal 30 Oktober 2026 tentang membantu website menyatakan preferensi training AI. Halaman itu tidak bisa saya buka saat menulis, jadi isinya tidak saya kutip. Sikap OpenAI terhadap token ini belum terverifikasi dari sumber primer, dan dokumentasi crawler OpenAI yang saya buka belum menyebut token tersebut. Hal yang sama berlaku untuk Anthropic: halaman bantuan crawler-nya belum menyebut token ini, walaupun penulis drafnya berafiliasi dengan Anthropic. Untuk vendor lain, saya belum menemukan pernyataan resmi.
Pendapat saya: ide satu baris untuk semua vendor ini masuk akal, tetapi jangan buru-buru mengandalkannya. Statusnya masih draf individu, dan dukungan Google baru akan datang awal 2027. Untuk sekarang, token per vendor tetap jadi pegangan utama. Menambahkan token AIPREF di samping token per vendor tidak ada ruginya, karena menurut draf, parser lama akan mengabaikannya seperti nama bot yang tidak dikenal.
Lapisan kedua: firewall untuk bot yang tidak patuh
Kalau robots.txt adalah papan "mohon tidak masuk", firewall adalah satpam di pintu. Firewall menolak permintaan sebelum sampai ke aplikasi, tanpa peduli bot itu mau patuh atau tidak.
Contoh terbaru datang dari Vercel. Pada 29 Oktober 2026, Vercel mengumumkan bahwa ruleset terkelola AI Bots di Vercel Firewall kini bisa memisahkan dua kategori:
- AI crawlers: bot yang mengumpulkan konten untuk pengindeksan dan training model.
- AI assistants: bot yang mengambil halaman sebagai respons atas aksi pengguna atau pertanyaan pencarian.
Untuk tiap kategori kamu bisa memilih mencatat saja (Log) atau menolak (Deny). Menurut dokumentasi WAF Vercel, ruleset ini tersedia di semua paket dan tidak aktif secara default. Changelog-nya menambahkan bahwa Vercel memperbarui aturan saat ada bot baru.
Perhatikan bahwa pembagian Vercel hanya dua, sedangkan pembagian vendor tiga. Changelog menyebut AI crawlers mengumpulkan konten "untuk pengindeksan dan training", tetapi dokumentasi WAF menyebut AI assistants mencakup bot yang mengambil halaman untuk pertanyaan pencarian. Penentunya adalah katalog bots.fyi yang dirujuk dokumentasi Vercel. Di katalog itu, GPTBot dan ClaudeBot masuk AI Crawler, sedangkan OAI-SearchBot, Claude-SearchBot, ChatGPT-User, dan Claude-User masuk AI Assistant. Artinya Deny untuk AI assistants ikut menolak bot pencarian AI, bukan hanya agen yang dipicu pengguna.
Saran saya untuk lapisan firewall:
- Mulai dengan mode Log selama satu sampai dua minggu. Lihat bot mana yang benar-benar datang dan seberapa sering.
- Tolak hanya kategori yang sejalan dengan robots.txt-mu. Kalau di robots.txt kamu mengizinkan crawler pencarian, jangan pilih Deny untuk AI assistants. Firewall sebaiknya menegakkan keputusan, tidak membuat keputusan baru.
- Tetap biarkan robots.txt bisa dibaca. Ini sejalan dengan peringatan Anthropic soal blokir IP.
Penyedia hosting dan CDN lain mungkin punya fitur serupa. Saya tidak membahasnya karena tidak membuka dokumentasinya untuk artikel ini.
Cara memilih aturan untuk website-mu
Tidak ada satu jawaban benar. Yang ada hanya pertukaran: kontenmu dipakai lebih luas, atau situsmu lebih jarang muncul di jawaban AI. Berikut cara saya menimbangnya per jenis website.
| Jenis website | Training | Pencarian AI | Agen dipicu pengguna |
|---|---|---|---|
| Website jasa atau bisnis lokal | Bebas, cenderung izinkan | Izinkan | Izinkan |
| Blog yang hidup dari kunjungan dan iklan | Pertimbangkan tolak | Izinkan | Izinkan |
| Konten berbayar atau kursus | Tolak | Izinkan halaman publik saja | Tolak di area berbayar |
| Dokumentasi produk atau API | Izinkan | Izinkan | Izinkan |
| Toko online | Bebas | Izinkan | Izinkan |
Website jasa, bisnis lokal, dan dokumentasi produk
Untuk jenis ini, saya pilih mengizinkan hampir semuanya. Tujuan halamanmu adalah ditemukan dan dipahami. Kalau calon pelanggan bertanya ke ChatGPT atau Claude soal jasa di kotamu, kamu ingin namamu muncul. Dokumentasi produk lebih jelas lagi: semakin model AI paham produkmu, semakin sedikit jawaban keliru tentang cara memakainya.
Blog yang hidup dari kunjungan
Ini posisi paling sulit. Penerbit konten khawatir orang cukup membaca ringkasan AI tanpa pernah mengklik. Pilihan yang menurut saya paling seimbang: tolak crawler training, izinkan crawler pencarian, izinkan agen yang dipicu pengguna. Alasannya, crawler pencarian AI setidaknya membawa tautan balik ke situsmu, sedangkan training tidak membawa apa pun.
Saya tidak menyarankan menolak bot pencarian AI hanya karena takut. Kalau kompetitormu terlihat di jawaban AI dan kamu tidak, kerugiannya nyata dan sulit diukur.
Konten berbayar dan kursus
Untuk materi di balik login, robots.txt bukan alat utamanya. Halaman yang butuh login memang tidak bisa diakses crawler. Yang perlu kamu jaga adalah halaman publik yang isinya terlalu mirip materi berbayar. Untuk halaman seperti itu, tolak training dan pertimbangkan apakah memang perlu publik.
Tiga pertanyaan sebelum memutuskan
- Dari mana pengunjungmu datang sekarang? Kalau hampir semua dari Google Search, ingat bahwa Google-Extended tidak memengaruhi Search, jadi kamu bebas memutuskan soal Gemini tanpa risiko SEO.
- Apakah kontenmu adalah produkmu? Kalau ya, tolak training. Kalau konten hanya alat pemasaran, izinkan.
- Siapa yang akan mengecek robots.txt enam bulan lagi? Daftar bot berubah terus. Kalau tidak ada yang merawat, aturan sederhana yang dirawat lebih baik daripada aturan rinci yang ditinggalkan.
Ringkasan dan langkah berikutnya
Checklist minggu ini
- Buka robots.txt situsmu sendiri dan baca isinya, termasuk di setiap subdomain
- Pastikan tidak ada aturan bintang yang tanpa sengaja menolak semua bot
- Putuskan sikap untuk tiga tugas terpisah: training, pencarian AI, agen dipicu pengguna
- Tulis keputusan itu per token vendor: GPTBot, OAI-SearchBot, ClaudeBot, Claude-SearchBot, Claude-User, Google-Extended
- Pertimbangkan menambahkan token
__usage_ai-trainingsebagai pelengkap, bukan pengganti - Kalau memakai firewall dengan fitur bot AI, jalankan mode Log dulu sebelum Deny
- Jadwalkan pengecekan ulang tiap tiga bulan, karena daftar bot terus berubah
Cheat sheet
| Bot atau token | Vendor | Tugas | Kalau ditolak |
|---|---|---|---|
| GPTBot | OpenAI | Training | Konten tidak dipakai untuk training model dasar OpenAI |
| OAI-SearchBot | OpenAI | Pencarian | Tidak muncul di jawaban pencarian ChatGPT, masih mungkin jadi tautan navigasi |
| ChatGPT-User | OpenAI | Dipicu pengguna | Menurut OpenAI, robots.txt mungkin tidak berlaku |
| ClaudeBot | Anthropic | Training | Materi ke depan dikecualikan dari dataset training |
| Claude-SearchBot | Anthropic | Pencarian | Visibilitas di hasil pencarian Claude bisa turun |
| Claude-User | Anthropic | Dipicu pengguna | Claude tidak mengambil halamanmu atas permintaan pengguna |
| Google-Extended | Training dan grounding Gemini | Tidak berpengaruh ke Google Search | |
| Google-Agent | Dipicu pengguna | Fetcher jenis ini umumnya mengabaikan robots.txt | |
__usage_ai-training |
Draf IETF | Preferensi training lintas vendor | Google berniat mendukung awal 2027, vendor lain belum terverifikasi |
Daftar bot di dokumentasi vendor bisa berubah kapan saja. Bagian ini akan saya perbarui saat token AIPREF mulai didukung resmi.
Mungkin kamu perlu menyusun draf kebijakan untuk tim, misalnya tabel keputusan per halaman situsmu. AI Tools di eduwebmu bisa membantu merapikan tulisan itu atau menyusun daftar halaman yang perlu diputuskan. Model Standar sudah cukup untuk pekerjaan ini. Tetap cocokkan hasilnya dengan dokumentasi resmi tiap vendor sebelum mengubah robots.txt.
Pertanyaan yang sering diajukan
Kalau saya memblokir GPTBot, apakah website saya hilang dari ChatGPT?
Tidak otomatis. Menurut dokumentasi OpenAI, GPTBot hanya terkait training model, sedangkan kemunculan di hasil pencarian ChatGPT diatur lewat OAI-SearchBot. Keduanya diatur terpisah.
Apakah memblokir Google-Extended membuat peringkat di Google Search turun?
Menurut dokumentasi Google, Google-Extended tidak memengaruhi apakah situs masuk Google Search dan tidak dipakai sebagai sinyal peringkat. Token ini hanya mengatur pemakaian konten untuk training dan grounding Gemini.
Apakah robots.txt benar-benar bisa menghentikan bot AI?
Tidak secara teknis. Standar robots.txt (RFC 9309) menyebut aturannya bukan bentuk otorisasi akses. Bot yang patuh akan mengikutinya, bot yang tidak patuh perlu dihadang di level server atau firewall.
Apa itu __usage_ai-training?
Token kebijakan dari draf IETF yang memungkinkan pemilik situs menyatakan satu preferensi training AI untuk semua penyedia sekaligus di robots.txt. Google menyatakan berniat mendukungnya awal 2027. Statusnya masih draf, belum standar.
Apakah memblokir crawler AI sekarang akan menghapus konten yang sudah dipakai untuk training?
Tidak. Anthropic, misalnya, menyebut pembatasan ClaudeBot menandakan materi situs di masa depan dikecualikan dari data training. Tidak ada dokumentasi resmi yang menjanjikan penghapusan data lama lewat robots.txt.
Saya pakai Vercel. Apakah perlu mengedit robots.txt juga?
Sebaiknya keduanya. Firewall Vercel menghadang permintaan bot yang dikenali, sedangkan robots.txt adalah cara resmi menyatakan preferensi yang dibaca crawler. Anthropic juga memperingatkan bahwa blokir IP saja bisa membuat robots.txt tidak terbaca.
Bot mana yang tetap datang walaupun saya memblokir semua crawler AI di robots.txt?
Bot yang dipicu pengguna. OpenAI menyebut aturan robots.txt mungkin tidak berlaku untuk ChatGPT-User, dan Google menyebut fetcher yang dipicu pengguna umumnya mengabaikan robots.txt.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.OpenAI Platform Docs, "Overview of OpenAI Crawlers"platform.openai.com(buka di tab baru)
- 2.Claude Help Center, "Does Anthropic crawl data from the web, and how can site owners block the crawler?" (7 April 2026)support.claude.com(buka di tab baru)
- 3.Google Search Central, "Google's common crawlers" (bagian Google-Extended, diperbarui 30 Oktober 2026)developers.google.com(buka di tab baru)
- 4.Google Search Central, "Google user-triggered fetchers" (diperbarui 19 Agustus 2026)developers.google.com(buka di tab baru)
- 5.Vercel Changelog, "Control AI crawlers and assistants separately in Vercel Firewall" (29 Oktober 2026)vercel.com(buka di tab baru)
- 6.Vercel Docs, "WAF Managed Rulesets" (bagian AI Bots Managed Ruleset)vercel.com(buka di tab baru)
- 7.IETF Datatracker, "Machine-Readable Training Preference Signal" (draft-kelley-aipref-training-preference-signal-00, 30 Oktober 2026)datatracker.ietf.org(buka di tab baru)
- 8.IETF Datatracker, "A Vocabulary For Expressing AI Usage Preferences" (draft-ietf-aipref-vocab-08, 13 September 2026)datatracker.ietf.org(buka di tab baru)
- 9.IETF Datatracker, "Associating AI Usage Preferences with Content in HTTP" (draft-ietf-aipref-attach-05, 18 Agustus 2026)datatracker.ietf.org(buka di tab baru)
- 10.RFC Editor, "RFC 9309: Robots Exclusion Protocol" (September 2022)rfc-editor.org(buka di tab baru)
- 11.Vercel, "bots.fyi" (katalog bot yang dirujuk dokumentasi WAF Vercel)bots.fyi(buka di tab baru)
crawler airobots.txtseoai training