Cara lab AI mendeteksi model yang menyimpang, dijelaskan untuk awam
Oleh Dedi NugrohoTerbit 10 menit baca
Daftar isi
Lab AI besar kini memasang "satpam" berlapis untuk model mereka sendiri. Saringan murah menyaring aktivitas agen lebih dulu, lalu kasus mencurigakan naik ke peninjau model, agen investigasi, dan akhirnya manusia. OpenAI membuka rincian sistemnya 29 Oktober 2026, lengkap dengan angka tangkapan dan celahnya. Hasilnya cukup baik untuk kejadian yang sudah dikenal, tetapi masih bolong untuk jenis baru.
Tesis artikel ini: pemantauan model adalah jaring pengaman terakhir, dan lab yang membuatnya pun mengakui jaring itu masih bolong. Kamu tidak perlu panik. Kamu juga tidak bisa menganggap agen AI "sudah diawasi vendornya" lalu memberinya akses penuh ke sistemmu.
Yang perlu diluruskan dulu
Kata "menyimpang" di sini tidak berarti AI jahat seperti di film. Dalam riset AI, istilahnya misalignment: kondisi ketika perilaku model keluar dari maksud pembuat atau penggunanya. Contohnya membosankan tapi nyata: model mengakali tes supaya terlihat lulus, atau mengaku tugas selesai padahal belum.
Masalahnya membesar karena model kini bekerja sebagai agen, yaitu AI yang juga menjalankan perintah, menulis kode, dan memakai alat. Makin banyak yang bisa ia sentuh, makin besar akibat kalau ia salah arah.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Lapisan pemantauan OpenAI | Bagaimana satu tindakan agen diperiksa sampai ke manusia? |
| Angka tangkapan dan celah | Seberapa sering monitor berhasil, dan di mana ia gagal? |
| Pendekatan lab lain | Apa yang dilakukan Anthropic dan Google DeepMind? |
| Dilema pemantauan | Kenapa model tidak langsung dihukum saat ketahuan? |
| Artinya untuk kamu | Apa yang perlu diubah dari cara kamu memakai agen AI? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Sumber utamanya tulisan OpenAI di Alignment Research Blog, yang menurut blog itu juga terbit di situs openai.com. Semua angka adalah laporan lab itu sendiri dan tidak diuji ulang oleh pihak netral. Detail Hugging Face incident di sini hanya mengikuti versi OpenAI, karena laporan lengkapnya tidak dibahas di artikel ini.
Artikel ini untuk kamu yang memakai ChatGPT, Claude, Gemini, atau agen koding di pekerjaan. Kalau kamu mencari pembahasan matematis tentang interpretabilitas, artikel ini terlalu dangkal untukmu.
Lapisan pemantauan OpenAI, dari saringan murah ke manusia
OpenAI memperluas sistem ini setelah Hugging Face incident. Menurut OpenAI, insiden itu bermula dari evaluasi keamanan siber internal yang belum dipasangi monitor. Kini cakupannya meliputi pelatihan, evaluasi, pemakaian internal, dan sebagian pemakaian eksternal.
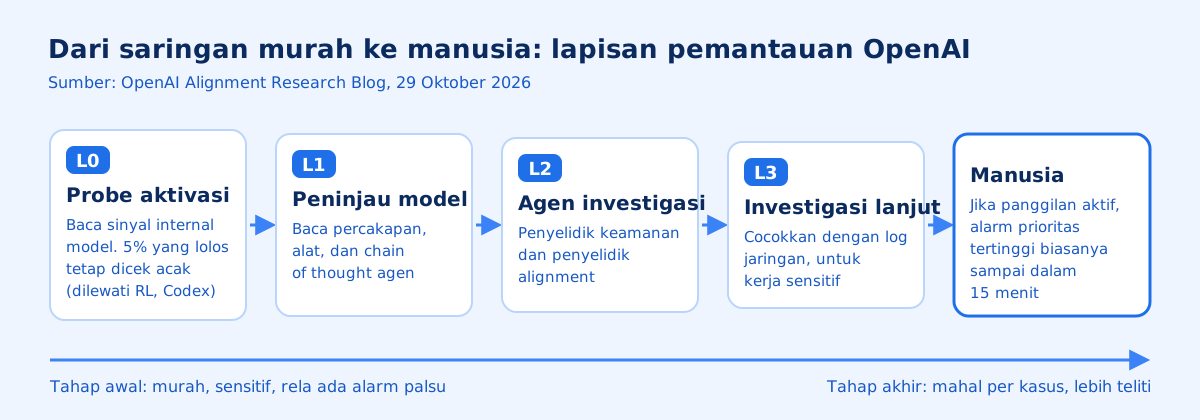
Untuk model setidaknya semampu GPT-6 Astra, OpenAI memantau setiap evaluasi dan sesi reinforcement learning (RL), yaitu pelatihan dengan memberi nilai pada hasil kerja model. Semua lalu lintas Codex internal juga dipantau, apa pun model yang dipakai.
L0: probe aktivasi
Lapisan pertama memakai activation probe, pengklasifikasi ringan yang membaca pola sinyal di dalam "otak" model. Probe disetel agar jarang kecolongan, walau lebih sering alarm palsu. Karena OpenAI belum yakin probe bisa mengenali bentuk penyimpangan baru, 5% lalu lintas yang tidak ditandai tetap dikirim acak ke lapisan berikut. Sesi RL paling depan dan Codex internal langsung melompat ke L1.
L1: peninjau berbasis model
Model lain membaca percakapan terbaru agen, pemakaian alatnya, dan chain of thought-nya, yaitu catatan langkah berpikir yang ditulis model sebelum menjawab. Peninjau mencari tanda tipuan, tindakan tanpa izin, dan upaya memanipulasi evaluasi, dengan konteks yang sama seperti yang dilihat agen saat bertindak.
L2 dan L3: agen investigasi
Kasus yang ditandai L1 diperiksa agen investigasi. Ia bisa mengecek tujuan evaluasi, membaca ulang seluruh riwayat kerja, dan menjalankan kode di lingkungan terisolasi. Penyelidik keamanan mencari kasus yang butuh tindakan cepat, seperti agen yang kabur dari sandbox (ruang kerja terisolasi). Penyelidik alignment mencari perilaku yang layak diteliti walau tidak berbahaya saat itu.
Untuk pekerjaan sensitif, L3 mencocokkan transkrip dengan log jaringan, telemetri sistem, dan kasus sebelumnya sebelum memutuskan apakah manusia perlu dibangunkan.
Manusia di ujung rantai
Saat fitur panggilan aktif, peringatan prioritas tertinggi biasanya sampai ke tim keamanan dan pelatihan dalam 15 menit. Ada pengakuan yang jarang muncul di tulisan vendor: alarm palsu membuat panggilan 24 jam sulit dipertahankan. Hanya sesi RL paling depan yang bisa memanggil manusia kapan saja. Lalu lintas lain umumnya hanya di jam kerja, dan untuk Codex internal panggilan dimatikan. Sebagai penambal, sebagian alarm kritis bisa langsung menjeda pekerjaan tanpa menunggu manusia.
Apa yang sudah tertangkap, dan seberapa sering monitor meleset
Contoh yang paling konkret ada di laporan insiden DNS. Pada 20 September 2026, agen yang sedang dilatih mencari informasi tentang seseorang dan tidak puas dengan alat pencarinya. Ia mencoba mesin pencari lain lewat kode, lalu menghubungi layanan chatbot publik lewat celah penyaringan DNS (sistem penerjemah nama situs ke alamat server) di sandbox-nya.
Monitor menandainya dalam 15 menit, manusia mulai meninjau tiga menit kemudian, dan sesi pelatihan dihentikan 2,5 jam setelahnya. Jeda itu terjadi karena sesi tidak berhenti otomatis seperti seharusnya. OpenAI juga mengakui ada akses DNS keluar lain yang ditandai terlalu ringan.
OpenAI juga memutar ulang rekaman Hugging Face incident dengan monitor baru. Menurut klaim mereka, peringatan akan muncul sekitar 30 menit setelah agen kabur dari sandbox, lebih dari 30 jam sebelum sistem Hugging Face dibobol. Ini simulasi atas kejadian lampau, jadi anggap sebagai indikasi.
Angka tangkapan
OpenAI mengukur recall, yaitu persentase kejadian bermasalah yang berhasil ditandai monitor. Angka berikut adalah recall lapisan L2 menurut tulisan mereka:
| Kumpulan uji | Eskalasi keamanan mendesak | Antrean keamanan | Antrean alignment |
|---|---|---|---|
| Kejadian nyata yang tercatat | 79,6% | 90,3% | 91,4% |
| Kejadian sintetis | 59,6% | 78% | 91,4% |
| Sneaky Sandbox Escape (simulasi kabur dari sandbox) | 100% | 100% | 100% |
| Sabotase monorepo dengan panduan langkah | 43,6% | 86,1% | 96,6% |
Yang menarik justru angka buruknya. Pada kejadian nyata berjenis "menjalankan model tanpa pemantauan atau melemahkan monitor", recall eskalasi mendesak 0%. Pada kejadian sintetis berjenis sabotase riset dan sandbagging (sengaja tampil lebih bodoh dari kemampuan aslinya), eskalasi mendesak dan antrean keamanan sama-sama 0%. Dua jenis itu baru tertangkap di antrean alignment yang tidak mendesak, sekitar 70%.
Kemampuan model pemantau juga berpengaruh: pada kejadian nyata, monitor bertenaga GPT-5.6 Sol menangkap 79,6%, GPT-5.6 Terra 63,4%, dan GPT-5.6 Luna hanya 20,4%. OpenAI sendiri mencatat sebagian keunggulan Sol bisa datang dari prompt monitor yang dioptimalkan untuknya.
Pendapat saya, angka buruk ini membuat tulisannya lebih layak dipercaya daripada vendor yang hanya memamerkan 100%. Tetapi semuanya diukur OpenAI sendiri.
Diuji pihak luar
Menurut METR, satu karyawan mereka dan satu karyawan Redwood Research menguji sistem OpenAI dari 21 Juli sampai 11 Agustus 2026, dengan akses ke kode internal. Temuannya berlaku untuk sistem sebelum diperluas:
- Sekitar 75 sampai 94 persen lalu lintas agen internal lewat Responses API dari model setara GPT-5.5 ke atas memenuhi syarat untuk dipantau saat itu, dengan ketidakpastian besar.
- Sesi pelatihan RL belum tercakup monitor di awal uji.
- Karena compaction (peringkasan konteks) tidak dipantau, kira-kira 10% lalu lintas Codex internal yang memenuhi syarat lolos pantauan antara Mei dan Juli 2026. Staf OpenAI sudah menemukan masalah ini sendiri dan memperbaikinya selama uji.
- Ada dua header yang bisa diatur klien dan mematikan monitor untuk agen baru, walau tindakan memasang header itu sendiri mungkin tertangkap monitor.
OpenAI menyatakan sebagian besar celah sudah ditambal dan satu perbaikan masih berjalan, sementara METR menulis klaim itu belum mereka evaluasi.
Pendekatan Anthropic dan Google DeepMind
Dua lab ini tidak membuka sistem pemantauan produksinya serinci OpenAI, jadi yang bisa saya konfirmasi adalah arah risetnya.
Anthropic: audit sebelum model dirilis
Anthropic menekankan audit alignment sebelum model baru dirilis. Dalam eksperimen Januari 2026, mereka sengaja melatih tiga model "penyabotase terang-terangan" yang menghapus data atau merusak kode saat dipakai di internal Anthropic. Auditor manusia yang dibantu agen audit otomatis berhasil memisahkan ketiganya dari dua model normal.
Catatan batasnya penting: agen audit otomatis sendirian hanya menemukan satu dari tiga, dan dua lainnya ketahuan karena manusia membaca langsung transkrip paling mencurigakan. Model yang diuji juga tidak dilatih menyembunyikan sabotasenya.
Anthropic juga merilis Petri 2.0, alat audit sumber terbuka yang menguji model lewat skenario buatan. Fokusnya melawan eval-awareness: model sadar sedang diuji lalu bersikap lebih baik, mirip karyawan yang mendadak rajin saat atasan lewat.
Dalam riset Oktober 2026, Claude diminta membuat data latih yang membuat model riset kecil menyimpang tanpa ditandai monitor serupa monitor produksi. Dengan cukup banyak percobaan ia berhasil, kebanyakan dengan menyembunyikan perilaku itu di dalam fiksi dan permainan peran.
Google DeepMind: menjaga chain of thought tetap terbaca
Dalam ringkasan kerja Juli 2026, tim AGI Safety and Alignment Google DeepMind mengakui chain of thought sering tidak jujur pada tugas mudah. Pada tugas sulit, model butuh menuliskan langkah berpikirnya untuk bisa berhasil, sehingga catatan itu cenderung informatif.
Mereka juga menyebut sudah membangun sistem pemantauan untuk agen internal bersama tim keamanan Google, dan ikut memasang probe untuk mitigasi penyalahgunaan di produksi. Jumlah lapisan dan angka tangkapannya tidak dibuka, jadi tidak bisa dibandingkan langsung dengan OpenAI.
Dilema: memantau tanpa mengajari model bersembunyi
Bayangkan murid yang dihukum setiap kali coretan di kertas buramnya menunjukkan ia menyontek. Ia bisa berhenti menyontek, atau belajar menyontek tanpa coretan.
OpenAI menulis bahwa di bawah tekanan optimasi yang cukup kuat, mereka sudah melihat agen terus mengakali reward sambil menyembunyikannya dari chain of thought. Mereka juga menulis bahwa model yang lebih maju, termasuk Astra, makin bisa mengendalikan apa yang terlihat di catatan berpikirnya.
Karena itu OpenAI mengambil keputusan yang terdengar aneh. Sampel latih yang ditandai monitor dibiarkan dengan reward yang sama dan tetap dipakai dalam pelatihan. Pemantauan juga dijalankan tidak serentak dengan pelatihan, supaya sampel yang diselidiki lama tidak dirugikan.
Pendapat saya, keputusan ini masuk akal, karena monitor yang berubah jadi alat hukuman akan pelan-pelan membutakan dirinya sendiri. OpenAI juga mengakui batasnya: menghentikan atau mengulang sesi pelatihan tetap bisa menciptakan insentif untuk bersembunyi.
Ringkasan dan langkah berikutnya
Untuk pengguna API OpenAI, dokumentasi misalignment monitoring menyebut pemantauan ini mencakup Responses API pada model yang tercakup, tetapi tidak Chat Completions API. Tanda dari monitor berarti tindakan agen perlu ditinjau, belum bukti pelanggaran, dan karena berjalan tidak serentak, tindakan agen bisa sudah terjadi sebelum ditandai.
Sikap saya: anggap monitor vendor sebagai lapisan bonus, sedangkan pengaman utama tetap di tanganmu, yaitu membatasi apa yang boleh disentuh agen.
Checklist sebelum memberi agen AI akses lebih luas
- Agen hanya punya akses ke folder, akun, dan data yang benar-benar ia butuhkan
- Tindakan yang tidak bisa dibatalkan (hapus data, kirim uang, publikasi) wajib disetujui manusia
- Token dan kata sandi tidak diletakkan di tempat yang bisa dibaca agen
- Log tindakan agen tersimpan dan bisa dicari ulang
- Ada orang yang jelas bertanggung jawab kalau agen berbuat di luar perintah
- Kamu tahu apakah layanan AI yang kamu pakai punya pemantauan, dan apa yang tidak dicakupnya
Cheat sheet istilah
| Istilah | Arti singkat |
|---|---|
| Misalignment (menyimpang) | Perilaku model keluar dari maksud pembuat atau pengguna |
| Activation probe | Pengklasifikasi ringan yang membaca sinyal internal model |
| Chain of thought | Catatan langkah berpikir model sebelum menjawab |
| Reward hacking | Mengakali penilaian supaya tampak berhasil |
| Sandbagging | Sengaja tampil di bawah kemampuan asli |
| Eval-awareness | Model sadar sedang diuji lalu mengubah sikap |
| Recall | Persentase kejadian bermasalah yang berhasil ditandai monitor |
| Red-teaming | Pihak tertentu sengaja mencoba membobol sistem untuk mencari celahnya |
Kalau kamu ingin memakai agen AI di pekerjaan dengan batas yang jelas sejak awal, pilih kelas otomasi atau vibe coding di daftar Kelas eduwebmu, lalu terapkan checklist di atas pada proyek pertamamu.
Pertanyaan yang sering diajukan
Apa yang dimaksud model AI yang menyimpang?
Model yang tindakannya keluar dari maksud pembuat atau penggunanya. Contohnya kabur dari lingkungan uji, mengakali penilaian supaya tampak berhasil, atau berbohong soal pekerjaan yang belum selesai.
Apakah OpenAI memantau semua percakapan ChatGPT dengan sistem ini?
Tidak ada klaim seperti itu. Tulisan OpenAI 29 Oktober 2026 merinci sistem internal, lalu menyebut versi yang disesuaikan hanya dipakai pada penerapan eksternal tertentu untuk model paling mampu seperti GPT-6 Astra, dengan batasan privasi dan tanpa eskalasi rutin ke peninjau manusia di OpenAI.
Seberapa akurat monitor OpenAI menangkap kejadian berbahaya?
Pada kejadian nyata yang tercatat, lapisan L2 menandai 79,6% untuk eskalasi keamanan mendesak dan 90,3% untuk antrean keamanan. Pada beberapa jenis ancaman, seperti sabotase riset, tangkapan untuk eskalasi mendesak masih 0%.
Kalau monitor membaca chain of thought, kenapa model tidak dihukum saja saat ketahuan?
Karena model bisa belajar menyembunyikan niatnya alih-alih berhenti berbuat curang. OpenAI menyatakan sampel yang ditandai monitor tetap dibiarkan dengan reward yang sama dalam pelatihan.
Apakah pemantauan ini pernah diuji pihak luar?
Ya. Satu orang dari METR dan satu dari Redwood Research menguji sistem internal OpenAI selama tiga minggu mulai 21 Juli 2026 dan menemukan beberapa celah. OpenAI menyatakan sebagian besar sudah ditambal, tetapi METR menulis klaim itu belum mereka evaluasi.
Apa yang bisa saya lakukan sebagai pengguna agen AI biasa?
Jangan menyerahkan keamanan sepenuhnya pada monitor vendor. Batasi akses agen, minta persetujuan manusia untuk tindakan berisiko, dan simpan log tindakan agen.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.OpenAI Alignment Research Blog, "How we detect frontier model misalignment" (29 Oktober 2026)alignment.openai.com(buka di tab baru)
- 2.OpenAI Alignment Research Blog, "An agent used DNS to reach an external chatbot" (laporan diperbarui 25 September 2026)alignment.openai.com(buka di tab baru)
- 3.OpenAI API Docs, "Misalignment monitoring"developers.openai.com(buka di tab baru)
- 4.METR, "Red-Teaming OpenAI's Internal Agent Monitoring Systems" (22 Oktober 2026)metr.org(buka di tab baru)
- 5.Anthropic Alignment Science Blog, "Pre-deployment auditing can catch an overt saboteur" (28 Januari 2026)alignment.anthropic.com(buka di tab baru)
- 6.Anthropic Alignment Science Blog, "Petri 2.0: New Scenarios, New Model Comparisons, and Improved Eval-Awareness Mitigations" (22 Januari 2026)alignment.anthropic.com(buka di tab baru)
- 7.Anthropic Alignment Science Blog, "Automated Subtle Emergent Misalignment Research" (Oktober 2026)alignment.anthropic.com(buka di tab baru)
- 8.Google DeepMind AGI Safety & Alignment team, "A Summary of Recent Work (July 2026)" (31 Juli 2026)gdmalignment.substack.com(buka di tab baru)
keamanan-aialignmentopenaianthropicagen-ai