Embedding untuk pemula: kunci chatbot yang bisa membaca dokumen
Oleh Dedi NugrohoTerbit 17 menit baca
Daftar isi
Embedding adalah cara mengubah teks menjadi deretan angka sehingga komputer bisa membandingkan makna, bukan sekadar mencocokkan kata. Chatbot dokumen memakainya untuk mencari paragraf yang paling relevan dengan pertanyaanmu, lalu menyodorkan paragraf itu ke model bahasa. Tanpa embedding, chatbot hanya menjawab dari ingatan umumnya sendiri.
Tesis artikel ini: kualitas chatbot dokumen lebih banyak ditentukan oleh cara kamu menyiapkan dan mencari dokumen daripada oleh model bahasa yang menjawab. Orang biasanya sibuk membandingkan model chat. Padahal kalau tahap pencarian mengambil paragraf yang salah, model sebagus apa pun akan menjawab dengan yakin dari bahan yang salah. Embedding adalah mesin di tahap pencarian itu.
Yang perlu diluruskan dulu
Ada tiga salah kaprah yang perlu dibereskan sebelum kita membahas angka dan model.
Pertama, "chatbotnya dilatih pakai PDF kami." Dalam chatbot dokumen yang umum, tidak ada pelatihan sama sekali. Model bahasanya tetap sama persis. Dokumen hanya diubah jadi angka, disimpan di database terpisah, lalu diambil sepotong demi sepotong saat ada pertanyaan. Cara kerja ini disebut RAG (Retrieval-Augmented Generation), yaitu teknik memberi model bahasa bahan bacaan dari luar sebelum ia menjawab. Dokumentasi n8n mendefinisikannya sebagai pengambilan dokumen relevan untuk mendasari jawaban, bukan mengandalkan data latih model saja.
Kedua, "chatbot membaca seluruh dokumen setiap kali ditanya." Tidak juga. Ia hanya menerima beberapa potongan yang dianggap paling mirip dengan pertanyaan. Kalau jawabannya ada di halaman 40 dan potongan itu tidak terambil, chatbot tidak akan tahu.
Ketiga, "makin mahal modelnya, makin pintar chatbotnya." Model chat yang lebih kuat memang membantu merangkai jawaban. Tetapi ia tidak bisa memperbaiki bahan yang salah ambil.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Embedding dengan bahasa sehari-hari | Apa sebenarnya deretan angka itu, dan kenapa bisa mewakili makna? |
| Dari dokumen ke jawaban | Di titik mana embedding bekerja dalam chatbot dokumen? |
| Memilih model embedding | Lewat API atau dijalankan sendiri, dan model mana yang masuk akal? |
| EmbeddingGemma 2 | Apa yang baru dari rilis Google Oktober 2026, dan apa batasnya? |
| Jebakan yang paling sering | Kenapa chatbot tetap salah jawab padahal sudah pakai embedding? |
| Ringkasan | Apa yang harus dicek sebelum chatbot dokumen dipakai orang lain? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Semua angka model, dimensi, dan batas input diambil dari dokumentasi resmi Google, OpenAI, Hugging Face, dan n8n pada tanggal itu. Skor benchmark yang dikutip adalah angka yang dilaporkan pembuat model sendiri, bukan hasil uji independen. Artikel ini juga bukan panduan langkah demi langkah, jadi tidak ada kode atau konfigurasi di dalamnya.
Artikel ini untuk kamu yang ingin membuat atau memesan chatbot yang menjawab dari dokumen sendiri, misalnya SOP, katalog produk, atau FAQ layanan pelanggan. Juga untuk pemilik bisnis yang ingin bisa menilai proposal vendor chatbot tanpa tertipu istilah. Kalau kamu peneliti yang mencari detail matematika di balik model embedding, artikel ini terlalu dasar untukmu.
Embedding dengan bahasa sehari-hari
Bayangkan setiap kalimat diberi alamat di sebuah peta. Kalimat yang maknanya mirip mendapat alamat yang berdekatan, kalimat yang maknanya jauh mendapat alamat yang berjauhan. "Bagaimana cara mengembalikan barang?" dan "Prosedur retur produk" akan bertetangga, walau hampir tidak berbagi kata yang sama. "Jam buka toko hari Minggu" tinggal di wilayah lain.
Alamat itu berupa deretan angka yang disebut vektor. Dokumentasi OpenAI mendefinisikannya dengan lugas: embedding adalah vektor berisi angka desimal, dan jarak antara dua vektor mengukur seberapa berkaitan keduanya. Jarak kecil berarti sangat berkaitan, jarak besar berarti sedikit berkaitan.
Setiap angka dalam deretan itu disebut dimensi. Peta di kertas punya dua dimensi, yaitu kiri-kanan dan atas-bawah. Peta makna punya ratusan sampai ribuan dimensi. Model text-embedding-3-small dari OpenAI menghasilkan 1.536 angka per teks, sedangkan text-embedding-3-large menghasilkan 3.072 angka.
Kenapa angka bisa mewakili makna
Dokumentasi n8n memberi contoh sederhana yang menurut saya paling mudah dicerna. Andaikan satu angka mewakili "alat otomasi", angka lain mewakili "kode sumbernya bisa dilihat publik" (source-available), dan angka ketiga mewakili "bisa di-hosting sendiri". Kalimat tentang n8n mendapat ketiganya, kalimat tentang Zapier hanya mendapat yang pertama. Dari situ komputer bisa menghitung bahwa n8n dan Zapier mirip dalam satu hal, tetapi berbeda dalam dua hal lain.
n8n sendiri mengingatkan bahwa contoh ini sangat disederhanakan. Dalam praktik, satu dimensi tidak mewakili satu konsep tertentu, sehingga kamu tidak bisa membaca angka ke-17 lalu berkata "ini angka untuk harga". Maknanya tersebar di seluruh deretan angka. Yang bisa dipercaya hanyalah posisi relatif: siapa dekat dengan siapa.
Cara komputer mengukur "dekat"
Ukuran yang lazim dipakai disebut cosine similarity, yaitu ukuran seberapa searah dua vektor. Dua teks yang searah dianggap bermakna mirip. OpenAI merekomendasikan ukuran ini dan menyebut pilihan rumus jarak biasanya tidak banyak berpengaruh. Kamu tidak perlu menghitungnya sendiri, karena database vektor dan alat seperti n8n melakukannya di belakang layar.
Satu hal yang menurut saya perlu kamu pegang: embedding mengukur kemiripan, bukan kebenaran. Kalimat "garansi berlaku 12 bulan" dan "garansi berlaku 6 bulan" akan sangat berdekatan di peta makna. Kalau dokumenmu menyimpan dua versi kebijakan, pencarian bisa saja mengambil yang lama.
Di luar chatbot
Embedding tidak hanya dipakai untuk chatbot. Dokumentasi OpenAI menyebut pencarian, pengelompokan (clustering), rekomendasi, deteksi anomali, dan klasifikasi. Contoh yang dekat dengan bisnis kecil: mengelompokkan ratusan ulasan pelanggan berdasarkan tema keluhan, atau mencari tiket bantuan lama yang mirip dengan tiket baru. Semua itu memakai prinsip yang sama, yaitu membandingkan jarak antara deretan angka.
Dari dokumen ke jawaban: di mana embedding bekerja
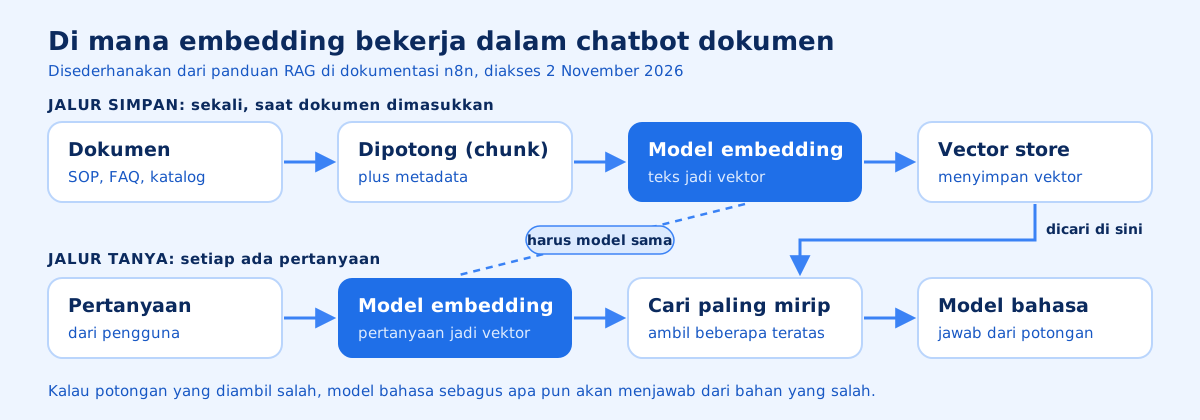
Chatbot dokumen punya dua jalur kerja yang berjalan di waktu berbeda. Jalur pertama dijalankan sekali saat dokumen dimasukkan. Jalur kedua dijalankan setiap kali ada pertanyaan.
Jalur simpan
Dokumen tidak di-embed utuh. Ia dipotong dulu menjadi bagian kecil yang disebut chunk. Di n8n, pemotongan ini dikerjakan node Default Data Loader dengan tiga pilihan pemotong teks. Menurut panduan RAG di dokumentasi n8n, pilihan yang direkomendasikan untuk kebanyakan kasus adalah Recursive Character Text Splitter, yang memotong mengikuti struktur Markdown, HTML, atau blok kode.
Setiap potongan lalu diubah oleh model embedding menjadi vektor dan disimpan di vector store, yaitu database yang dirancang khusus untuk menyimpan dan mencari vektor. Kamu juga bisa menempelkan metadata ke setiap potongan, misalnya nama dokumen, tanggal berlaku, atau divisi pemilik. Menurut n8n, metadata ini memperkaya konteks dan memudahkan penyaringan hasil nanti.
Jalur tanya
Saat pengguna bertanya, pertanyaannya diubah menjadi vektor oleh model embedding yang sama. Vector store lalu mencari potongan dengan vektor paling dekat dan mengembalikan beberapa yang teratas. Jumlahnya kamu atur lewat parameter limit. Potongan itu, bersama pertanyaan, dikirim ke model bahasa yang menyusun jawaban.
Perhatikan kata "yang sama". n8n menulisnya eksplisit di langkah query: tambahkan model embedding yang sama dengan yang dipakai saat memasukkan data. Ini aturan yang tidak bisa ditawar, dan saya bahas lagi di bab jebakan.
Pilihan vector store di n8n
Daftar node di dokumentasi n8n saat ini memuat vector store untuk Pinecone, Qdrant, Supabase, PGVector, Weaviate, MongoDB Atlas, Redis, Chroma, Milvus, Zep, Azure AI Search, dan beberapa lainnya. Ada juga Simple Vector Store yang menyimpan data di memori n8n sendiri. Yang terakhir ini paling gampang untuk mencoba, dan menurut saya paling berisiko kalau dipakai melewati tahap coba-coba.
Dokumentasi Simple Vector Store menyebut tiga batas yang jelas. n8n merekomendasikannya untuk pengembangan saja. Datanya hilang setiap kali n8n restart dan bisa terhapus saat memori menipis. Kunci memorinya berlaku global, sehingga semua pengguna instance bisa membaca isinya tanpa peduli hak akses workflow asal. Di n8n Cloud, batas memorinya diatur 100 MB (kira-kira 8.000 dokumen, tergantung ukuran dan metadata), dan penyimpanan yang tidak diakses selama 7 hari dihapus.
Saran saya: pakai Simple Vector Store untuk membuktikan ide dalam satu sore, lalu pindahkan ke vector store sungguhan sebelum ada orang lain yang memakai chatbotnya. Kalau kamu sudah punya Supabase atau PostgreSQL, pilihan saya PGVector atau Supabase Vector Store, karena keduanya tidak menambah layanan baru yang harus diurus.
Memilih model embedding: lewat API atau dijalankan sendiri
Ada dua jalan besar. Jalan pertama adalah memanggil model milik penyedia lewat API dan membayar per pemakaian. Jalan kedua adalah menjalankan model terbuka di laptop, ponsel, atau server sendiri. Tabel berikut merangkum lima model yang dibahas di artikel ini, diambil dari dokumentasi resmi masing-masing.
| Model | Cara pakai | Masukan | Batas masukan | Dimensi bawaan |
|---|---|---|---|---|
OpenAI text-embedding-3-small |
API berbayar | Teks | 8.192 token | 1.536 |
OpenAI text-embedding-3-large |
API berbayar | Teks | 8.192 token | 3.072 |
Google gemini-embedding-001 |
API Gemini | Teks | 2.048 token | 3.072 |
Google gemini-embedding-2 |
API Gemini | Teks, gambar, video, audio, PDF | 8.192 token | 3.072 |
| Google EmbeddingGemma 2 | Unduh, jalankan sendiri | Teks, gambar, video, audio | 8.192 token | 768 |
Token adalah satuan potongan kata yang dipakai model untuk menghitung panjang teks. Satu kata Bahasa Indonesia bisa menjadi satu atau beberapa token.
Kapan memilih API
API cocok kalau kamu ingin cepat jalan dan dokumenmu tidak terlalu sensitif untuk dikirim ke penyedia. OpenAI menyebut embedding ditagih per token masukan. Dokumentasinya memberi gambaran sekitar 62.500 halaman per dolar untuk text-embedding-3-small dan sekitar 9.615 halaman per dolar untuk text-embedding-3-large, dengan asumsi 800 token per halaman. Artinya, versi small kira-kira enam kali lebih hemat untuk volume dokumen yang sama.
Dokumentasi OpenAI juga mencatat satu hal yang mudah terlewat: text-embedding-3-small dan -large tidak mengenal kejadian setelah September 2021. Untuk embedding, ini biasanya bukan masalah besar karena model hanya perlu memahami makna kalimat. Tetapi istilah atau nama produk yang sangat baru bisa saja terwakili kurang baik.
Dokumentasi embedding Gemini API menyebut gemini-embedding-2 sebagai model embedding multimodal pertama di Gemini API, dengan dukungan lebih dari 100 bahasa. Untuk kebutuhan teks saja, gemini-embedding-001 masih tersedia.
Kapan menjalankan sendiri
Model terbuka masuk akal bila dokumenmu tidak boleh keluar dari perangkat atau jaringan sendiri, misalnya rekam medis, data keuangan klien, atau dokumen hukum. Ia juga masuk akal kalau volume dokumenmu sangat besar dan biaya per token mulai terasa. Imbalannya, kamu mengurus sendiri server, pembaruan, dan pemantauan.
Pilihan saya
Untuk pemula yang membangun chatbot FAQ atau SOP berbahasa Indonesia di n8n, saya pilih text-embedding-3-small atau gemini-embedding-001. Alasannya sederhana: biayanya rendah menurut tabel harga di atas, n8n sudah punya node Embeddings OpenAI dan Embeddings Google Gemini, dan tidak ada server tambahan yang perlu diurus. Saya tidak menyarankan langsung memakai model besar hanya karena skor benchmark-nya lebih tinggi. Contohnya, dokumentasi OpenAI mencatat skor MTEB 62,3% untuk small dan 64,6% untuk large. Menurut saya selisih sekecil itu lebih murah dikejar lewat perbaikan cara memotong dokumen.
Saya baru akan menimbang model yang dijalankan sendiri, seperti EmbeddingGemma 2, bila ada alasan privasi yang jelas atau tim sudah terbiasa mengelola server.
EmbeddingGemma 2: apa yang baru dan apa batasnya
Pada 6 Oktober 2026, Google merilis EmbeddingGemma 2 lewat blog resmi Google, yang ditulis dua insinyur riset Google DeepMind. Ini model embedding terbuka yang memetakan teks (termasuk kode), gambar, video, dan audio ke satu ruang yang sama. Artinya, pertanyaan berbentuk teks bisa dicocokkan dengan potongan video atau rekaman suara.
Angka pokoknya, menurut blog peluncuran dan kartu model di Hugging Face:
- Total 740 juta parameter. Parameter adalah angka-angka yang dipelajari model selama pelatihan, dan jumlahnya sering dipakai sebagai ukuran besar model.
- Bagian teksnya hanya 270 juta parameter. Pengolah gambar (170 juta) dan audio (300 juta) bisa tidak dimuat bila tidak dipakai.
- Keluaran 768 dimensi, bisa dipotong menjadi 512, 256, atau 128.
- Jendela konteks 8.192 token, empat kali EmbeddingGemma generasi pertama. Menurut Google, cukup untuk sekitar 5,5 menit audio, 29 gambar, atau 58 bingkai video bila dipakai satu jenis masukan saja.
- Dibangun di atas arsitektur Gemma 4 dan dirilis dengan lisensi Apache 2.0, yang membolehkan pemakaian komersial. Lisensi ini juga tercantum di halaman EmbeddingGemma di Google AI for Developers.
- Dengan kuantisasi di Pixel 11 Pro, Google menyebut model ini butuh sekitar 191 MB RAM untuk teks saja dan sekitar 567 MB untuk versi multimodal penuh. Kuantisasi adalah teknik mengecilkan model dengan menyimpan angkanya dalam presisi lebih rendah.
Soal skor benchmark
Google menyebut EmbeddingGemma 2 meraih skor teratas di antara model embedding multimodal di bawah 1 miliar parameter, pada benchmark seperti MTEB Code dan MAEB. Ini klaim vendor. Tabel di kartu model hanya membandingkannya dengan EmbeddingGemma 1, bukan dengan model pesaing.
Perbandingan itu sendiri cukup jujur. Skor teks multilingual (MTEB multilingual v2) nyaris sama: 61,36 dibanding 61,15. Lonjakan besar ada di pencarian kode (MTEB code v1), dari 68,76 menjadi 78,68. Jadi kalau kebutuhanmu chatbot teks berbahasa Indonesia, kamu tidak sedang mendapat model teks yang jauh lebih baik. Yang kamu dapat adalah kemampuan baru untuk gambar, video, audio, dan kode.
Teknik Matryoshka
Fitur yang menurut saya paling berguna untuk pemula adalah Matryoshka Representation Learning (MRL), yaitu teknik pelatihan yang membuat bagian depan vektor tetap bermakna walau sisanya dibuang. Namanya diambil dari boneka Rusia yang bertumpuk. Google menyebut ini bisa menghemat penyimpanan sampai 6 kali.
Kartu model memberi rinciannya. Memotong dari 768 ke 256 dimensi hanya menurunkan skor multilingual dari 61,36 ke 60,41. Memotong ke 128 menurunkannya ke 57,89, dan untuk tugas multimodal penurunannya jauh lebih tajam. Google sendiri menyarankan 128 dimensi divalidasi dulu dengan data sendiri sebelum dipakai.
Model API juga punya fitur ini. Dokumentasi Gemini menyebut gemini-embedding-001 dan gemini-embedding-2 sama-sama dilatih dengan MRL, dengan dimensi yang disarankan 768, 1.536, atau 3.072.
Batas yang perlu kamu tahu
Ada tiga batas yang tidak disebut di blog peluncuran, tetapi tercantum di kartu model dan dokumentasi n8n.
Pertama, kartu model menyebut EmbeddingGemma 2 tidak menjalani penyelarasan atau penyetelan keamanan setelah pelatihan awal. Pengamanannya difokuskan pada penyaringan data latih. Tanggung jawab menyaring hasil pencarian ada di pembuat aplikasi.
Kedua, data latihnya punya batas waktu Januari 2025. Kartu model juga mengakui bahwa dukungan 100+ bahasa tidak berarti kualitasnya setara di semua bahasa. Kartu model tidak mencantumkan skor khusus Bahasa Indonesia, jadi kualitasnya untuk dokumen berbahasa Indonesia belum terverifikasi.
Ketiga, dan ini yang paling relevan untuk pengguna n8n: halaman vektor di dokumentasi n8n menyatakan n8n hanya mendukung embedding teks. Jadi lewat node bawaan, kemampuan gambar, video, dan audio EmbeddingGemma 2 tidak terpakai. Google menyebut model ini bisa dijalankan lewat Ollama, dan n8n punya node Embeddings Ollama. Tetapi dokumentasi n8n tidak menyebut EmbeddingGemma 2 secara khusus, jadi kecocokan kombinasi ini belum terverifikasi.
Jebakan yang paling sering bikin chatbot salah jawab
Keluhan "chatbotnya ngawur" belum tentu masalah model bahasa. Jebakan berikut semuanya terjadi di tahap pencarian, dan sebagian besar bersumber dari peringatan di dokumentasi resmi.
Mencampur model embedding
Dokumen di-embed dengan model A, lalu beberapa bulan kemudian seseorang mengganti node embedding di workflow pencarian menjadi model B. Vektor pertanyaan dan vektor dokumen kini berasal dari dua ruang yang tidak bisa dibandingkan, sehingga potongan yang terambil tidak lagi bermakna. Workflow tetap bisa berjalan seolah normal.
Dokumentasi Gemini API menyatakannya terang: ruang embedding gemini-embedding-001 dan gemini-embedding-2 tidak kompatibel, dan bila pindah model kamu wajib meng-embed ulang semua data. Perhatikan bahwa dua model ini berasal dari vendor yang sama. Pendapat saya, perlakukan setiap penggantian model sebagai kewajiban embed ulang. Vektor dari model berbeda ibarat alamat dari dua peta yang skalanya lain.
Kartu model EmbeddingGemma 2 menambahkan versi lain dari jebakan ini. Kalau kamu memotong dimensi, vektor pertanyaan dan vektor dokumen harus berdimensi sama. Vektor 768 dimensi tidak bisa dibandingkan dengan koleksi 128 dimensi.
Memotong dokumen asal-asalan
Potongan terlalu kecil membuat konteks hilang. Potongan "berlaku 30 hari" tidak berguna kalau kalimat sebelumnya, yang menyebut ini kebijakan retur, berada di potongan lain. Potongan terlalu besar membuat maknanya kabur karena satu vektor harus mewakili terlalu banyak topik.
Panduan n8n menyebut potongan kecil sekitar 200 sampai 500 token cocok untuk pencarian yang presisi, dan menekankan pentingnya overlap, yaitu bagian teks yang sengaja diulang di dua potongan berdekatan. n8n juga menautkan artikel contextual retrieval dari Anthropic untuk ide menambahkan konteks dokumen asal ke setiap potongan.
Pendapat saya: sebelum memikirkan angka, rapikan dulu dokumennya. Beri judul yang jelas di setiap bagian, satu topik per bagian, dan hapus versi lama. Dokumen yang rapi untuk manusia hampir selalu lebih mudah dicari oleh mesin.
Lupa instruksi tugas
Model generasi baru dari Google dilatih dengan awalan instruksi singkat. Untuk pencarian, pertanyaan diberi awalan seperti task: search result | query: dan dokumen diberi format title: ... | text: .... Kartu model EmbeddingGemma 2 menyebut tanpa awalan ini model tetap jalan, tetapi presisinya turun. Dokumentasi Gemini menyebut hal serupa untuk gemini-embedding-2, yang tidak lagi menerima parameter jenis tugas dan memindahkannya ke dalam teks.
Kalau kamu memakai node bawaan n8n, cek apakah node itu menambahkan awalan ini otomatis atau tidak. Dokumentasi n8n yang menjadi sumber artikel ini tidak menjelaskannya, jadi perilaku node soal awalan ini belum terverifikasi.
Pengaturan teknis yang gagal diam-diam
Dua catatan dari kartu model EmbeddingGemma 2 layak diketahui walau kamu bukan programmer, karena keduanya gagal tanpa pesan error. Model ini tidak boleh dijalankan dengan presisi float16 (format angka 16-bit), karena hasilnya bisa rusak tanpa peringatan. Kartu model menyarankan bfloat16 atau float32. Vektor yang dipotong dimensinya juga harus dinormalisasi ulang, atau peringkat hasil pencarian menurun diam-diam. Untuk gemini-embedding-2, Google menyebut normalisasi ini sudah otomatis, sedangkan untuk gemini-embedding-001 harus dilakukan manual.
Kalau yang memasang sistemnya orang lain, dua hal ini pantas kamu tanyakan langsung.
Menyalahkan model terlalu cepat
Urutan pemeriksaan yang saya sarankan saat jawaban salah: lihat dulu potongan apa yang diambil vector store untuk pertanyaan itu. Kalau potongannya tidak mengandung jawaban, masalahnya di pencarian atau dokumen. Kalau potongannya benar tetapi jawabannya tetap salah, baru periksa prompt dan model chat. n8n memudahkan ini karena keluaran setiap node bisa dilihat di riwayat eksekusi.
Pilihan lain yang tersedia di n8n adalah reranking, yaitu tahap kedua yang mengurutkan ulang hasil pencarian dengan model khusus. Opsi Rerank Results di node vector store bisa disambungkan ke node seperti Reranker Cohere. Saya menganggap ini langkah lanjutan, bukan hal pertama yang perlu dipasang.
Ringkasan dan langkah berikutnya
Embedding adalah alat pencari makna. Ia menentukan paragraf mana yang dibaca chatbot sebelum menjawab. Pendapat saya tetap sama dengan tesis di awal: model embedding yang sederhana dengan dokumen yang rapi lebih layak dikejar daripada model mahal dengan dokumen berantakan.
Checklist sebelum chatbot dokumen dipakai orang lain
- Dokumen sumber sudah dirapikan: judul jelas, satu topik per bagian, versi lama dihapus
- Model embedding di jalur simpan dan jalur tanya persis sama
- Dimensi vektor pertanyaan dan dokumen sama
- Vector store bukan Simple Vector Store bila chatbot dipakai lebih dari satu orang
- Tidak ada dokumen sensitif di vector store yang bisa dibaca semua pengguna instance
- Sudah diuji dengan 20 sampai 30 pertanyaan nyata, dan potongan yang terambil sudah dicek satu per satu
- Ada catatan model dan versi embedding yang dipakai, supaya penggantian berikutnya disertai embed ulang
Cheat sheet
| Kalau kebutuhanmu... | Pilihan yang masuk akal |
|---|---|
| Chatbot FAQ atau SOP teks, mulai cepat di n8n | text-embedding-3-small atau gemini-embedding-001 |
| Dokumen panjang atau topik rumit, akurasi diutamakan | text-embedding-3-large atau gemini-embedding-2 |
| Mencari di gambar, video, audio, atau PDF lewat API | gemini-embedding-2 |
| Data tidak boleh keluar dari perangkat sendiri | Model terbuka seperti EmbeddingGemma 2, uji dulu untuk Bahasa Indonesia |
| Mencoba ide dalam satu sore | Simple Vector Store di n8n |
| Chatbot dipakai tim atau pelanggan | Vector store sungguhan seperti PGVector, Supabase, Qdrant, atau Pinecone |
| Hemat penyimpanan | Potong dimensi dengan MRL, uji kualitasnya dulu |
Kalau kamu ingin membangun chatbot dokumen sendiri di n8n dan memahami setiap node yang terlibat, mulailah dari Kelas Automation di daftar Kelas eduwebmu. Pakai checklist di atas sebagai daftar periksa saat merakit workflow pertamamu, terutama bagian model embedding yang harus sama di kedua jalur.
Pertanyaan yang sering diajukan
Apa bedanya embedding dengan melatih ulang model AI?
Embedding tidak mengubah model bahasa sama sekali. Dokumenmu hanya diubah menjadi angka dan disimpan di database terpisah, lalu potongan yang relevan diambil dan disodorkan ke model saat ada pertanyaan.
Apakah saya boleh mengganti model embedding setelah dokumen tersimpan?
Boleh, tetapi semua dokumen harus di-embed ulang dengan model baru. Dokumentasi Gemini API menegaskan ruang embedding gemini-embedding-001 dan gemini-embedding-2 tidak kompatibel, dan kartu model EmbeddingGemma 2 juga hanya menjamin perbandingan antarsesama embedding EmbeddingGemma 2.
Berapa dimensi embedding yang sebaiknya saya pakai?
Untuk pemula, pakai nilai default model. Model yang mendukung Matryoshka Representation Learning bisa dipotong ke dimensi lebih kecil untuk menghemat penyimpanan, dengan penurunan kualitas yang menurut kartu model EmbeddingGemma 2 kecil sampai 256 dimensi dan tajam di 128 dimensi.
Apakah EmbeddingGemma 2 bisa dipakai gratis?
Bobot modelnya dirilis dengan lisensi Apache 2.0 dan bisa diunduh dari Hugging Face atau Kaggle. Kamu tetap menanggung biaya perangkat atau server untuk menjalankannya.
Apakah n8n bisa membuat embedding dari gambar atau audio?
Menurut dokumentasi n8n, node embedding di n8n hanya mendukung embedding teks. Model multimodal tetap bisa dipakai untuk teks di n8n, tetapi kemampuan gambar dan audionya tidak terpakai lewat node bawaan.
Apakah Simple Vector Store di n8n cukup untuk chatbot produksi?
Tidak. n8n menyarankan Simple Vector Store hanya untuk pengembangan, karena datanya hilang saat n8n restart dan bisa diakses semua pengguna instance.
Kenapa chatbot dokumen saya tetap menjawab salah padahal sudah pakai embedding?
Cek dulu potongan yang diambil vector store untuk pertanyaan itu. Kalau potongannya tidak berisi jawaban, masalahnya ada di pencarian atau dokumen, dan mengganti model chat tidak akan menolong.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.Google Blog, "EmbeddingGemma 2: an open, lightweight multimodal embedding model" (6 Oktober 2026, ditulis Sahil Dua dan Henrique Schechter Vera, Google DeepMind)blog.google(buka di tab baru)
- 2.Hugging Face, kartu model google/embeddinggemma-2 (diperbarui 28 Oktober 2026)huggingface.co(buka di tab baru)
- 3.Google AI for Developers, "EmbeddingGemma"ai.google.dev(buka di tab baru)
- 4.Google AI for Developers, "Embeddings" (Gemini API)ai.google.dev(buka di tab baru)
- 5.OpenAI API Docs, "Vector embeddings"developers.openai.com(buka di tab baru)
- 6.n8n Docs, "Retrieve relevant context"docs.n8n.io(buka di tab baru)
- 7.n8n Docs, "Store and search data with vectors"docs.n8n.io(buka di tab baru)
- 8.n8n Docs, "Simple Vector Store"docs.n8n.io(buka di tab baru)
- 9.Anthropic, "Contextual retrieval in AI systems" (19 September 2024)anthropic.com(buka di tab baru)
embeddingragchatbotvector storen8n