Memori AI agent: kenapa agent lupa dan cara mengatasinya
Oleh Dedi NugrohoTerbit 17 menit baca
Daftar isi
AI agent lupa karena model bahasa di dalamnya tidak menyimpan apa pun di antara panggilan. Setiap permintaan dimulai dari nol. Yang membuat agent terlihat ingat adalah lapisan memori di luar model: riwayat percakapan, catatan, atau database yang dibaca ulang sebelum model menjawab. Kalau lapisan itu tidak dirancang, agent pasti lupa.
Tesis artikel ini: memori agent adalah urusan desain sistem, dan hampir tidak ada hubungannya dengan kepintaran model. Mengganti model ke versi yang lebih mahal jarang menyembuhkan agent yang pelupa. Yang menyembuhkan adalah keputusan sederhana tentang apa yang disimpan, di mana, berapa lama, dan kapan dibuang.
Yang perlu diluruskan dulu
Salah kaprah paling umum: "model ini punya context window satu juta token, jadi agent saya pasti ingat". Context window adalah jumlah teks maksimal yang bisa dibaca model dalam satu permintaan. Ia mirip meja kerja. Seluas apa pun mejanya, meja itu dibersihkan setiap kali sesi selesai.
Salah kaprah kedua: memori dianggap fitur yang tinggal dinyalakan. Di n8n memang ada node memori yang bisa dipasang dalam hitungan detik. Tapi node itu hanya menyimpan riwayat chat untuk satu sesi. Ingatan tentang pelanggan minggu lalu, keputusan yang sudah diambil, atau kesalahan yang tidak boleh diulang butuh rancangan lain.
Salah kaprah ketiga: makin banyak yang diingat, makin bagus. Kenyataannya, memori yang hanya ditimbun justru membuat jawaban agent memburuk. Bagian ini saya bahas di bab kelima.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Kenapa agent lupa | Apa saja penyebab teknis agent kehilangan konteks? |
| Peta memori | Apa beda memori jangka pendek, jangka panjang, konteks, dan RAG? |
| Pilihan memori di n8n | Node mana yang cocok untuk kebutuhan saya? |
| Memori yang dirawat | Bagaimana agar memori tidak berubah jadi tumpukan sampah? |
| Ringkasan | Apa yang dicek sebelum agent dipakai pelanggan? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Sumber utamanya dokumentasi resmi n8n, dua artikel blog n8n dari Oktober 2026, dokumentasi memory tool Anthropic, dan dua riset tentang konteks panjang. Salah satu artikel blog n8n ditulis tamu dari Cognee, platform memori agent open-source yang ikut dipromosikan di tulisan itu, jadi klaim angkanya saya tandai sebagai klaim vendor. Artikel ini merangkum sumber, tidak memuat hasil uji perbandingan memori.
Artikel ini untuk kamu yang sudah membuat chatbot atau AI agent, entah di n8n atau alat lain, lalu bingung kenapa agent "pikun" di tengah percakapan. Kalau kamu baru mau mulai, artikel ini tetap berguna sebagai peta sebelum memilih alat. Kalau kamu mencari panduan instalasi Redis atau Postgres langkah demi langkah, artikel ini tidak membahasnya.
Kenapa agent lupa: lima penyebab yang paling sering
Gejalanya biasanya sama. Pelanggan menyebut nomor pesanan di pesan pertama, lalu di pesan keempat agent bertanya lagi. Atau agent sudah sepakat soal jadwal pengiriman, lalu besok paginya menawarkan jadwal lain. Penyebabnya bisa berbeda-beda, dan memperbaikinya tergantung penyebab mana yang terjadi.
1. Model memang tidak punya ingatan
Ini penyebab dasar yang berlaku untuk semua agent. Artikel n8n tentang memori agent yang terbit 23 Oktober 2026 merangkumnya dengan lugas: model membaca prompt, mengembalikan jawaban, lalu tidak menyimpan apa pun. Permintaan kedua diproses seolah permintaan pertama tidak pernah ada.
Artinya, setiap kali agent terlihat "ingat", ada kode atau node yang mengambil riwayat dan menyelipkannya kembali ke prompt. Kalau bagian itu tidak ada, agent tidak akan pernah ingat apa pun.
2. Workflow-nya sendiri juga tidak menyimpan apa-apa
Di n8n, masalah ini berlapis. Menurut artikel n8n tentang stateful dan stateless, setiap eksekusi workflow berdiri sendiri. Satu eksekusi tidak otomatis tahu data dari eksekusi sebelumnya. Istilahnya stateless: sistem memperlakukan setiap permintaan secara terpisah, tanpa membawa catatan dari permintaan sebelumnya.
Desain ini sengaja dipilih karena lebih mudah diskalakan dan dipulihkan saat ada gangguan. Konsekuensinya, kalau workflow perlu kesinambungan, kamu harus menambahkannya sendiri. Workflow balasan email yang jalan Senin tidak akan tahu apa yang ia kirim, kecuali hasilnya disimpan di suatu tempat.
3. Jendela riwayatnya terlalu pendek
Node memori chat di n8n punya parameter Context Window Length, yaitu jumlah interaksi sebelumnya yang ikut dibaca model. Lihat dokumentasi Simple Memory. Pola ini disebut sliding window: hanya sejumlah pesan terakhir yang dibawa, pesan yang lebih tua tergeser keluar.
Kalau nomor pesanan disebut di pesan pertama dan jendelanya hanya beberapa interaksi, informasi itu memang sudah keluar dari jangkauan model. Agent tidak rusak. Ia hanya tidak lagi melihat pesan itu.
Ada efek samping yang jarang dibahas. Artikel stateful vs stateless n8n mengingatkan bahwa sebagian besar model punya mekanisme caching, yaitu penyimpanan sementara bagian prompt yang sama agar panggilan berikutnya lebih murah. Sliding window yang terus bergeser membatalkan cache itu dalam percakapan panjang. n8n menyarankan memperbesar jendela atau meringkas pesan lama ketimbang memotongnya mentah-mentah.
4. Session key salah atau tertukar
Session key adalah kunci yang menandai riwayat mana milik percakapan mana. Kalau kuncinya salah, dua hal bisa terjadi: agent tidak menemukan riwayat (terasa lupa), atau agent membaca riwayat orang lain (jauh lebih berbahaya).
Halaman common issues Simple Memory menyebut dua jebakan. Pertama, beberapa node memori di satu workflow secara default mengakses instance memori yang sama, kecuali diberi session ID berbeda. Kedua, kunci statis seperti my_test_session boleh dipakai untuk uji coba, tetapi harus diganti manajemen sesi yang benar sebelum workflow dipublikasikan. Kalau tidak, semua pengguna berbagi satu riwayat.
5. Konteks terlalu panjang sampai detail tenggelam
Penyebab terakhir ini kebalikan dari jendela yang terlalu pendek. Semua riwayat dimasukkan, prompt menjadi sangat panjang, dan model justru melewatkan detail penting.
Ini bukan sekadar perasaan. Riset Lost in the Middle dari Liu dan kawan-kawan menguji hal ini. Performa model biasanya paling tinggi ketika informasi relevan ada di awal atau akhir input. Performanya turun signifikan ketika informasi itu terselip di tengah konteks panjang. Laporan teknis Context Rot dari Chroma (Juli 2025) menguji 18 model dan menyimpulkan performa makin tidak bisa diandalkan seiring bertambahnya panjang input, bahkan untuk tugas sederhana.
Anthropic memakai istilah context rot yang sama dalam panduan context engineering mereka (29 September 2025): model punya "anggaran perhatian" yang terbatas, dan setiap token tambahan ikut menguranginya. Context engineering sendiri adalah pekerjaan memilih informasi apa yang masuk ke prompt pada setiap panggilan. Kesimpulan praktisnya jelas. Memasukkan semua riwayat ke prompt bukan strategi memori.
Peta memori: jangka pendek, jangka panjang, dan RAG
Setelah tahu penyebabnya, kita perlu kosakata yang sama. Banyak diskusi soal memori agent kacau karena empat istilah dipakai bergantian: memori model, konteks, RAG, dan memori agent. Tulisan n8n tentang memori agent memisahkannya dengan rapi, dan saya pakai pembagian itu.
| Istilah | Pengetahuan tinggal di mana | Siapa yang memperbarui | Cocok untuk |
|---|---|---|---|
| Memori model | Di dalam model, hasil pelatihan | Pelatihan atau fine-tuning | Pengetahuan dan kemampuan umum |
| Konteks | Prompt pada panggilan saat ini | Kode aplikasi atau agent, setiap panggilan | Memasukkan data yang tepat untuk satu permintaan |
| RAG | Kumpulan dokumen eksternal yang relatif tetap | Orang atau sistem yang menulis dokumen | Menjawab berdasarkan pengetahuan yang sudah ada |
| Memori agent | Lapisan memori eksternal yang terus berubah | Orang, pipeline data, dan agent itu sendiri | Kesinambungan antar tugas, sesi, dan sumber |
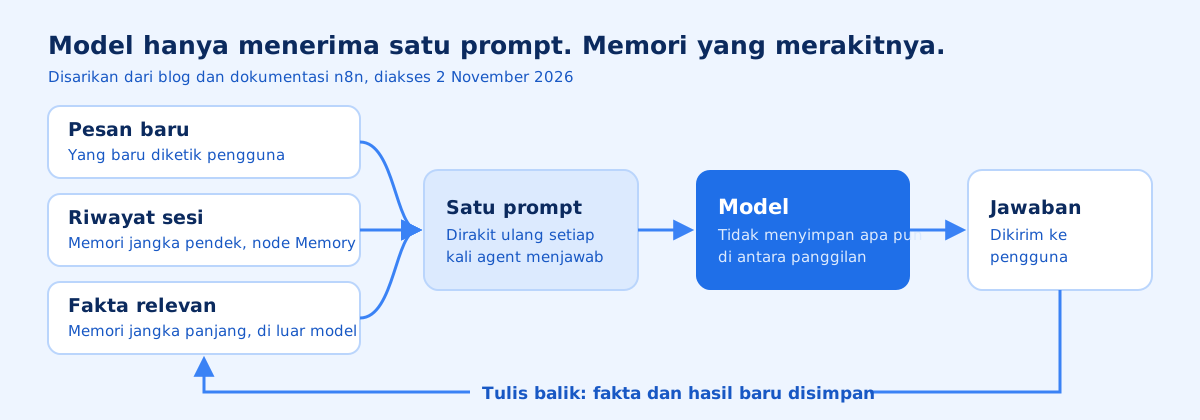
RAG (retrieval-augmented generation) adalah teknik mengambil potongan dokumen yang relevan lalu menempelkannya ke prompt sebelum model menjawab. Batasnya ada di arah aliran data. RAG hanya membaca. Ia tidak mencatat apa yang ditanyakan pelanggan minggu lalu atau solusi mana yang sudah gagal dicoba. Memori agent dimulai ketika agent menulis balik.
Jangka pendek dan jangka panjang
Di dalam memori agent sendiri ada dua skala waktu, dan biasanya dibangun sebagai dua komponen terpisah.
Memori jangka pendek menyimpan apa yang sedang terjadi sekarang: pesan terakhir, hasil alat yang baru dipanggil, status tugas. Di n8n, ini wilayah node memori chat yang dipasang ke port Memory pada AI Agent.
Memori jangka panjang bertahan melewati sesi. Isinya preferensi pengguna, hasil tugas sebelumnya, pelajaran tentang apa yang berhasil, dan pengetahuan perusahaan. Menurut tulisan n8n tadi, lapisan ini hampir selalu butuh penyimpanan eksternal khusus sejak hari pertama. Harus ada yang memutuskan apa yang disimpan, bagaimana disusun, dan apa yang dikembalikan untuk setiap permintaan.
Yang sering terlewat: dua jenis memori ini tetap dikirim ke model lewat jalur yang sama, yaitu satu prompt. Memori hanya mengubah cara prompt itu dirakit.
Contoh sederhana dari blog n8n: asisten penjualan mengambil angka penjualan kuartal ini lewat RAG. Tapi ia juga ingat dari percakapan sebelumnya bahwa pengguna ini selalu ingin angka Eropa dalam euro, dipecah per negara. Bagian kedua itulah memori agent.
Tempat menyimpan memori jangka panjang
Tulisan yang sama membandingkan empat cara menyimpan memori jangka panjang. Ringkasannya:
| Penyimpanan | Cara mencari | Kelebihan | Yang perlu diwaspadai |
|---|---|---|---|
| Vector database | Kemiripan makna | Mudah dipasang, alatnya matang | Lemah untuk ID persis, tidak tahu fakta mana yang terbaru |
| File teks (misalnya MEMORY.md) | Muat semua atau cari teks | Transparan, bisa diberi versi | Sulit diskalakan dan dibagi ke banyak agent |
| Knowledge graph | Cari titik awal, lalu ikuti relasi | Fakta yang saling terkait, jejaknya bisa dijelaskan | Lebih rumit dibangun dan dirawat |
| Hybrid | Beberapa penyimpanan dengan logika pengatur | Menangani ID, relasi, kemiripan, dan waktu | Komponennya paling banyak |
Vector database adalah database yang menyimpan teks sebagai deretan angka (embedding) sehingga bisa dicari berdasarkan kemiripan makna. Contoh kelemahannya di tulisan itu tepat sekali: "penjualan Q3" dan "penjualan Q4" hampir berimpit di ruang vektor, padahal untuk laporan keuangan keduanya jelas berbeda.
Pendapat saya: untuk bisnis kecil sampai menengah, mulai dari tabel terstruktur biasa. Preferensi pelanggan, status pesanan, dan janji yang sudah dibuat agent hampir selalu berupa data dengan kolom jelas. Vector database baru masuk akal ketika pertanyaannya memang kabur, misalnya mencari tiket lama yang mirip keluhan baru.
Pilihan memori di n8n dan cara memilihnya
n8n memisahkan dua lapis state. Menurut artikel stateful vs stateless mereka, node Memory mengurus konteks percakapan agent, sedangkan state store menyimpan data yang harus bertahan melewati satu sesi agent. State di sini artinya informasi yang dibawa dari satu interaksi ke interaksi berikutnya.
Lapis percakapan: node memori chat
Dokumentasi n8n tentang Agents vs chains mencatat satu batas yang sering bikin bingung: node Basic LLM Chain bisa diajak chat dengan model, tetapi tidak mendukung memori maupun tools. Kalau kamu memakai chain itu dan heran kenapa tidak ada port memori, itulah sebabnya.
Pilihan yang tersedia, menurut halaman How memory works dan daftar node di dokumentasi n8n per 2 November 2026:
- Simple Memory. Menyimpan riwayat chat dengan panjang yang bisa diatur, untuk sesi saat ini. Paling mudah untuk mulai. Dokumentasinya memberi peringatan tegas: jangan dipakai bila n8n berjalan di queue mode, karena di workflow produksi n8n tidak bisa menjamin setiap panggilan sampai ke worker yang sama. Queue mode adalah cara menjalankan n8n dengan beberapa worker yang berbagi antrean pekerjaan.
- Postgres Chat Memory. Menyimpan riwayat di tabel Postgres, dan tabelnya dibuat otomatis bila belum ada. Riwayat bertahan walau n8n di-restart.
- Redis Chat Memory. Menyimpan riwayat di Redis, punya parameter Session Time To Live untuk membuat sesi kedaluwarsa setelah sekian detik. Blog n8n menyebutnya pilihan saat butuh cache terdistribusi yang cepat dan bisa dibagi antar worker.
- Xata, MongoDB Chat Memory, dan Databricks Lakebase Chat Memory. Ketiganya tercantum di daftar node memori dokumentasi n8n. Artikel ini tidak membahasnya lebih jauh.
- Motorhead dan Zep. Keduanya ditandai usang di dokumentasi. Zep sejak n8n 1.108.0, Motorhead sejak 2.8.0 karena proyeknya tidak lagi dirawat. Tidak saya sarankan untuk workflow baru.
Di samping itu ada Chat Memory Manager, node untuk mengelola riwayat secara eksplisit: mengambil pesan, menyisipkan pesan, atau menghapus N pesan terakhir maupun semuanya. Node ini berguna ketika kamu ingin memangkas riwayat yang terlalu panjang atau menyuntikkan konteks tambahan. Hati-hati dengan mode Override All Messages, karena mode itu mengganti seluruh isi memori.
Lapis data: state store
Untuk ingatan yang harus bertahan antar eksekusi dan antar workflow, n8n menyarankan state store. Pilihan bawaannya data tables, penyimpanan tabel di dalam instance n8n yang bisa dibaca dan ditulis workflow. Alternatifnya workflow static data, atau Postgres dan Redis eksternal.
Data tables punya batas yang perlu diketahui sejak awal. Secara default total ukurannya 200 MiB per instance. Di self-hosted batas ini bisa diubah lewat variabel lingkungan. Begitu batas terlampaui, penambahan manual dimatikan dan eksekusi yang mencoba menulis akan error. Data tables juga tidak bisa diakses langsung dari Code node. Artinya, data tables cocok untuk catatan ringan seperti preferensi pelanggan atau penanda status. Untuk riwayat ribuan pelanggan selama bertahun-tahun, saya pilih database eksternal.
Lapis pengetahuan bersama
Tulisan memori agent n8n juga menggambarkan pola ketiga yang lebih ambisius: "otak bersama". Ada workflow pengumpul yang menangkap tiket yang selesai, ringkasan panggilan, atau isian formulir, lalu mengirimkannya ke lapisan memori. Workflow lain menanyakan lapisan itu tepat sebelum bertindak. Untuk agent tunggal, lapisan memori ini dipasang ke port Tool, sehingga agent sendiri yang memutuskan kapan mencatat dan kapan mencari.
Pola ini menarik, tetapi perlu dibaca dengan kacamata yang tepat. Tulisan itu dibuat tamu dari Cognee, platform memori agent yang menjual solusi persis seperti ini. Tulisan itu menyebut Cognee memegang skor terbaik yang dilaporkan di benchmark BEAM: 79% pada 100 ribu token dan 67% pada 10 juta token. Itu klaim vendor yang dimuat di blog mitra dan belum terverifikasi ke sumber independen. Penulisnya sendiri mengakui benchmark seperti ini kebanyakan hanya memeriksa jawaban akhir, bukan isi memori setelah berminggu-minggu diperbarui. Untuk kebanyakan bisnis kecil, lapisan percakapan plus satu tabel terstruktur sudah menyelesaikan sebagian besar masalah "agent lupa".
Cara memilih
| Kebutuhan kamu | Pilihan yang saya sarankan | Alasan |
|---|---|---|
| Mencoba agent di laptop atau instance uji | Simple Memory | Paling cepat, tanpa layanan tambahan |
| Chatbot produksi di instance tunggal | Postgres Chat Memory | Riwayat bertahan setelah restart, mudah diperiksa |
| Produksi di queue mode dengan banyak worker | Postgres atau Redis Chat Memory | Simple Memory tidak berfungsi di sini |
| Percakapan yang harus kedaluwarsa otomatis | Redis Chat Memory dengan Session Time To Live | Sesi lama terhapus tanpa kerja tambahan |
| Mengingat preferensi pelanggan antar sesi | Data tables atau database eksternal | Datanya terstruktur, bisa dicek manusia |
| Mencari kasus lama yang mirip | Vector store sebagai tool agent | Pertanyaannya memang berbasis kemiripan makna |
Memori yang dirawat, bukan ditimbun
Bagian ini yang paling sering dilupakan. Memori yang hanya bertambah akan memburuk seiring waktu. Fakta berubah, preferensi bergeser, dan catatan usang mulai bersaing dengan catatan yang benar. Pelanggan yang pindah alamat bulan lalu akan menerima kiriman ke alamat lama kalau agent menemukan catatan lama lebih dulu.
Tiga pekerjaan perawatan
Panduan memori agent di blog n8n menyebut tiga proses yang harus berjalan di atas penyimpanan:
- Konsolidasi. Catatan mentah menumpuk lebih cepat daripada kegunaannya. Secara berkala, ubah menjadi catatan yang lebih ringkas, misalnya ringkasan atau fakta turunan, sambil tetap menyimpan jejak ke catatan asli.
- Pembaruan. Menimpa fakta lama begitu saja menghilangkan sejarahnya. Dengan menyimpan informasi waktu pada setiap fakta, agent bisa menjawab "apa yang benar sekarang?" sekaligus "apa yang kita yakini bulan Maret?".
- Melupakan. Sebagian data memang harus dihapus: dataset usang, koreksi, atau permintaan hapus dari pengguna. Penghapusan sebaiknya menjadi operasi yang disengaja.
Pendapat saya, poin kedua yang paling murah dan paling sering diabaikan. Satu kolom tanggal "terakhir diperbarui" di tabel preferensi pelanggan sudah mencegah banyak jawaban salah. Agent bisa diberi instruksi sederhana: kalau ada dua catatan bertentangan, pakai yang terbaru.
Meringkas ketika riwayat terlalu panjang
Untuk memori jangka pendek, teknik utamanya adalah meringkas. Anthropic menyebutnya compaction: percakapan yang mendekati batas context window diringkas, lalu agent melanjutkan dengan jendela baru yang berisi ringkasan itu. Dalam panduan context engineering mereka, compaction disebut sebagai tuas pertama untuk menjaga agent tetap koheren dalam tugas panjang.
Ringkasan juga punya harga. Blog n8n mengingatkan bahwa ringkasan kehilangan detail, dan sebagian hasil sebaiknya tidak dikompres sama sekali, misalnya draf antara atau hasil perhitungan yang mahal. Karena itu, panduan Anthropic juga menyebut pencatatan terstruktur, yaitu agent menulis catatan di luar context window lalu membacanya lagi saat dibutuhkan.
Anthropic menyediakan memory tool untuk pola ini di Claude API. Claude bisa membuat, membaca, mengubah, dan menghapus file di direktori memori yang bertahan antar sesi. Penyimpanannya dikelola aplikasimu sendiri, sehingga data tidak tinggal di sisi Anthropic. Dokumentasinya menyarankan memory tool dipadukan dengan compaction: compaction menjaga konteks aktif tetap kecil, memori menyimpan hal yang harus selamat dari peringkasan.
Keamanan memori
Memori adalah data, dan data pelanggan punya risiko. Dokumentasi memory tool Anthropic memuat daftar pengaman yang menurut saya berlaku untuk sistem memori apa pun, termasuk di n8n:
- Data sensitif. Claude biasanya menolak menulis informasi sensitif ke memori. Untuk jaminan yang lebih kuat, tambahkan validasi yang membuang data sensitif sebelum disimpan.
- Ukuran. Pantau dan batasi ukuran file memori, agar satu catatan tidak membengkak tanpa kendali.
- Kedaluwarsa. Hapus berkala memori yang lama tidak diakses.
- Batas akses. Pastikan agent hanya bisa membaca dan menulis di wilayah memorinya sendiri. Anthropic mencontohkan serangan path traversal, yaitu jalur file yang dimanipulasi agar keluar dari folder memori.
Di n8n, padanannya sederhana. Pisahkan session key per pelanggan dan beri TTL bila memakai Redis. Jangan simpan nomor kartu atau kata sandi di riwayat chat, dan jadwalkan workflow pembersih untuk tabel memori.
Ringkasan dan langkah berikutnya
Agent lupa karena satu dari lima hal. Model memang tidak menyimpan apa pun, workflow berjalan tanpa state, jendela riwayat terlalu pendek, session key salah, atau konteks terlalu panjang sampai detail tenggelam. Empat yang terakhir bisa diperbaiki dengan desain, tanpa mengganti model.
Checklist sebelum agent dipakai pelanggan
- Saya tahu informasi apa yang harus diingat dalam satu percakapan, dan apa yang harus diingat antar sesi
- Session key unik per pelanggan, tidak ada kunci statis sisa uji coba
- Simple Memory tidak dipakai bila instance berjalan di queue mode
- Panjang jendela riwayat sudah diuji dengan percakapan yang benar-benar panjang
- Ingatan jangka panjang disimpan di tabel atau database dengan kolom tanggal pembaruan
- Ada aturan kapan memori lama dihapus atau kedaluwarsa
- Data sensitif disaring sebelum masuk memori
- Agent sudah diuji dengan memori aktif dan nonaktif untuk melihat bedanya
Cheat sheet
| Gejala | Penyebab yang paling mungkin | Perbaikan |
|---|---|---|
| Agent menanyakan ulang info dari awal percakapan | Jendela riwayat terlalu pendek | Perbesar jendela atau ringkas pesan lama |
| Agent lupa semua setelah n8n di-restart | Memori di dalam proses (Simple Memory) | Pindah ke Postgres atau Redis Chat Memory |
| Memori kadang jalan, kadang tidak, di produksi | Simple Memory di queue mode | Pakai memori persisten yang bisa diakses semua worker |
| Agent menyebut detail percakapan orang lain | Session key statis atau tertukar | Buat session key dari ID pengguna atau chat |
| Error "No sessionId" | Trigger tidak mengirim session ID | Cek keluaran Chat trigger atau kelola sesi manual |
| Agent tidak ingat pelanggan dari minggu lalu | Hanya ada memori jangka pendek | Tambah tabel preferensi atau memori jangka panjang |
| Jawaban makin ngawur di percakapan panjang | Konteks terlalu panjang | Ringkas, pangkas riwayat, ambil hanya fakta relevan |
| Agent memakai fakta yang sudah usang | Memori ditimbun tanpa pembaruan | Simpan tanggal di setiap fakta, pakai yang terbaru |
Langkah berikutnya yang saya sarankan sederhana. Ambil satu agent yang sudah kamu punya, tulis apa saja yang harus ia ingat, lalu cocokkan dengan tabel pilihan memori di atas. Kalau kamu sedang menyusun workflow agent baru di n8n, n8n Workflow Generator di eduwebmu bisa membantu menyusun kerangka workflow dari deskripsi kebutuhanmu. Sebutkan jenis memori yang kamu inginkan di deskripsi, lalu periksa hasilnya dengan checklist di atas, terutama soal session key dan queue mode.
Pertanyaan yang sering diajukan
Apakah model AI seperti Claude atau GPT mengingat percakapan saya sebelumnya?
Modelnya sendiri tidak. Setiap permintaan ke model berdiri sendiri, jadi aplikasi atau agent yang harus menyimpan riwayat dan mengirimkannya lagi bersama pesan baru.
Apa bedanya memori agent dengan RAG?
RAG membaca dari sumber pengetahuan yang sudah ada, misalnya dokumen atau database, lalu menambahkannya ke prompt. Memori agent juga menulis balik: ia mencatat fakta, preferensi, dan hasil kerja baru agar bisa dipakai lagi nanti.
Kenapa Simple Memory di n8n tiba-tiba tidak bekerja di produksi?
Penyebab yang paling sering adalah instance berjalan di queue mode. Dokumentasi n8n menyebut Simple Memory tidak berfungsi di workflow produksi pada queue mode karena panggilannya tidak dijamin sampai ke worker yang sama.
Apakah context window yang besar menghapus kebutuhan memori?
Tidak. Konteks tetap hilang saat sesi berakhir, prompt panjang lebih mahal, dan riset menunjukkan kemampuan model mengambil informasi menurun ketika input makin panjang.
Node memori n8n mana yang sebaiknya dipakai untuk chatbot pelanggan?
Untuk produksi, pilih memori yang tersimpan di luar proses, seperti Postgres Chat Memory atau Redis Chat Memory, dan pastikan setiap pelanggan punya session key sendiri. Simple Memory cocok untuk mencoba dan menguji.
Apakah Motorhead dan Zep masih bisa dipakai sebagai memori di n8n?
Dokumentasi n8n menandai keduanya usang. Node Zep usang sejak n8n 1.108.0, sedangkan node Motorhead usang sejak 2.8.0 karena proyek Motorhead tidak lagi dirawat.
Bolehkah agent menyimpan data sensitif pelanggan di memori?
Sebaiknya tidak tanpa saringan. Dokumentasi memory tool Anthropic menyarankan validasi yang membuang data sensitif sebelum disimpan, batas ukuran file, dan penghapusan berkala untuk memori yang lama tidak diakses.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.n8n Blog, "AI Agent Memory: How LLM Agents Manage State in Production" (23 Oktober 2026, tulisan tamu dari Cognee)blog.n8n.io(buka di tab baru)
- 2.n8n Blog, "Stateful vs. Stateless: Managing Context in AI Agent Builds" (22 Oktober 2026)blog.n8n.io(buka di tab baru)
- 3.n8n Docs, "How memory works"docs.n8n.io(buka di tab baru)
- 4.n8n Docs, "Agents vs chains"docs.n8n.io(buka di tab baru)
- 5.n8n Docs, "Simple Memory"docs.n8n.io(buka di tab baru)
- 6.n8n Docs, "Simple Memory: Common issues"docs.n8n.io(buka di tab baru)
- 7.n8n Docs, "Postgres Chat Memory"docs.n8n.io(buka di tab baru)
- 8.n8n Docs, "Redis Chat Memory"docs.n8n.io(buka di tab baru)
- 9.n8n Docs, "Chat Memory Manager"docs.n8n.io(buka di tab baru)
- 10.n8n Docs, "Motorhead"docs.n8n.io(buka di tab baru)
- 11.n8n Docs, "Zep"docs.n8n.io(buka di tab baru)
- 12.n8n Docs, "Data tables"docs.n8n.io(buka di tab baru)
- 13.Anthropic, "Effective context engineering for AI agents" (29 September 2025)anthropic.com(buka di tab baru)
- 14.Claude Docs, "Memory tool"platform.claude.com(buka di tab baru)
- 15.Liu dkk., "Lost in the Middle: How Language Models Use Long Contexts" (arXiv 2307.03172)arxiv.org(buka di tab baru)
- 16.Chroma, "Context Rot: How Increasing Input Tokens Impacts LLM Performance" (14 Juli 2025)trychroma.com(buka di tab baru)
ai-agentmemorin8ncontext-engineering