Evals: cara menguji AI agent sebelum dipakai pelanggan
Oleh Dedi NugrohoTerbit 17 menit baca
Daftar isi
Eval adalah ujian berulang untuk AI agent: sekumpulan tugas dengan kriteria lulus yang jelas, dijalankan setiap kali prompt, model, atau alat agent berubah. Kamu bisa mulai dari 20 sampai 50 kasus yang diambil dari kegagalan nyata. Nilai hasil akhirnya dengan kode bila bisa, dengan model AI bila perlu, dan cek sesekali oleh manusia.
Tesis artikel ini: agent yang belum punya eval belum siap bertemu pelanggan, sebagus apa pun demonya. Demo hanya membuktikan agent bisa berhasil sekali. Pelanggan butuh agent yang berhasil setiap kali, dan satu-satunya cara mengetahuinya adalah mengukur berulang dengan kasus yang sama.
Yang perlu diluruskan dulu
Kata "eval" sering tertukar dengan benchmark. Benchmark adalah ujian umum seperti SWE-bench atau MMLU yang dipakai untuk membandingkan model di papan peringkat. Panduan evaluation best practices dari OpenAI membedakan tiga arti eval: benchmark industri, skor numerik standar, dan tes khusus untuk aplikasimu sendiri. Artikel ini membahas yang ketiga.
Salah kaprah kedua: eval dianggap pekerjaan tim riset besar. Kenyataannya, eval paling sederhana bisa berupa lembar Google Sheets berisi 20 pertanyaan pelanggan, jawaban yang diharapkan, dan kolom hasil. Yang membuatnya disebut eval adalah disiplinnya: kasusnya tetap, cara menilainya tetap, dan hasilnya dibandingkan dari versi ke versi.
Salah kaprah ketiga: "sudah dicoba manual, jawabannya bagus". OpenAI menyebut ini vibe-based evals, yaitu menilai dari kesan "sepertinya sudah jalan", dan memasukkannya ke daftar anti-pola. Saya setuju. Mencoba manual itu awal yang wajar, tetapi tidak bisa diulang dengan persis sama minggu depan. OpenAI juga memasukkan "menunggu sampai rilis baru membuat eval" ke anti-pola yang sama.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Anatomi sebuah eval | Apa saja komponennya, dan istilah apa yang perlu dipahami? |
| Tiga jenis penilai | Siapa yang memberi nilai: kode, AI, atau manusia? |
| Dari nol ke kasus pertama | Bagaimana menyusun kumpulan kasus yang layak dipercaya? |
| Alat per November 2026 | Pakai apa: n8n, Cursor Agent SDK, atau yang lain? |
| Contoh rancangan | Seperti apa eval untuk agent layanan pelanggan toko online? |
| Ringkasan | Apa yang dicek sebelum agent dirilis? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Isinya disusun dari panduan resmi Anthropic, OpenAI, n8n, dan catatan rilis Cursor. Contoh di bab rancangan adalah ilustrasi, bukan hasil uji. Fitur dan paket harga alat eval berubah cepat, jadi cek ulang halaman resminya sebelum memutuskan.
Artikel ini untuk kamu yang sedang membangun AI agent untuk dipakai orang lain: chatbot layanan pelanggan, asisten penjualan di WhatsApp, atau workflow AI di n8n yang membalas email. Kalau agentmu hanya kamu pakai sendiri dan kesalahannya tidak merugikan siapa pun, eval formal boleh ditunda. Cukup catat kasus yang gagal.
Anatomi sebuah eval
Anthropic menulis panduan Demystifying evals for AI agents pada 9 Januari 2026. Definisinya ringkas: eval adalah tes untuk sistem AI, yaitu memberi masukan lalu menerapkan logika penilaian pada keluarannya untuk mengukur keberhasilan. Untuk agent, ada beberapa istilah yang perlu dibedakan.
- Tugas (task atau test case): satu soal dengan masukan dan kriteria lulus yang jelas. Contoh: "Pelanggan minta refund untuk pesanan yang terlambat 5 hari."
- Percobaan (trial): satu kali agent mengerjakan tugas. Karena jawaban model bisa berbeda tiap kali, satu tugas dijalankan beberapa kali.
- Penilai (grader): logika yang memberi nilai. Satu tugas bisa punya beberapa penilai sekaligus.
- Transkrip (transcript atau trace): catatan lengkap satu percobaan, termasuk pesan, pemanggilan alat, dan hasil antara.
- Hasil akhir (outcome): keadaan nyata di sistem setelah percobaan selesai.
Bedanya transkrip dan hasil akhir paling penting dipahami. Anthropic memberi contoh agent pemesanan tiket pesawat. Di akhir percakapan agent bisa berkata "Tiket Anda sudah dipesan". Itu isi transkrip. Hasil akhirnya adalah apakah reservasi benar-benar ada di database. Agent yang pandai berbicara tetapi tidak menyelesaikan pekerjaannya hanya tertangkap kalau kamu memeriksa hasil akhir.
Satu hal lagi yang sering terlewat: yang diuji adalah model dan "rangka" agentnya sekaligus. Rangka ini, yang Anthropic sebut agent harness, adalah kode yang mengatur prompt, alat, dan alur kerja di sekitar model. Mengganti model tanpa mengubah rangka bisa mengubah hasil. Mengubah deskripsi satu alat tanpa mengganti model juga bisa.
Kemampuan dan regresi
Panduan yang sama membagi eval menjadi dua tujuan. Eval kemampuan bertanya "apa yang sudah bisa dikerjakan agent ini dengan baik?". Tingkat lulusnya sengaja dimulai rendah supaya tim punya target untuk dikejar. Eval regresi bertanya "apakah agent masih bisa mengerjakan semua yang dulu bisa?". Tingkat lulusnya harus mendekati 100%. Begitu turun, berarti ada yang rusak.
Keduanya terhubung. Tugas kemampuan yang sudah konsisten lulus bisa "naik kelas" menjadi bagian dari eval regresi. Polanya mirip rapor sekolah: materi yang sudah dikuasai tetap diuji ulang supaya tidak lupa.
Tiga jenis penilai dan kapan memakainya
Setiap eval butuh penilai. Panduan Anthropic dan dokumentasi eval di Claude Platform sepakat ada tiga jenis: kode, model AI, dan manusia. Masing-masing punya kekuatan dan kelemahan yang jelas.
| Penilai | Contoh pemeriksaan | Kekuatan | Kelemahan |
|---|---|---|---|
| Kode | Jawaban persis sama, format JSON valid, alat refund dipanggil dengan nominal di bawah batas, status tiket berubah | Cepat, murah, hasilnya sama setiap kali | Kaku terhadap jawaban benar yang bentuknya berbeda |
| Model AI | Rubrik nada bicara, apakah jawaban berdasar dokumen kebijakan, perbandingan dua jawaban | Bisa menilai jawaban terbuka dan nuansa | Hasilnya bisa berubah, lebih mahal, perlu dikalibrasi dengan manusia |
| Manusia | Ahli bidang meninjau sampel, A/B test dengan pengguna | Standar emas, cocok dengan penilaian pengguna sungguhan | Lambat, mahal, sulit diulang sering |
Urutan pilihan saya sama dengan saran Anthropic: pakai kode di mana pun bisa, pakai AI di mana perlu, dan pakai manusia secukupnya untuk validasi. Dokumentasi Claude bahkan menulis bahwa penilaian manusia sebaiknya dihindari bila bisa, karena lambat dan mahal. Saya tidak sepenuhnya setuju untuk bisnis kecil. Untuk 20 kasus pertama, membaca sendiri hasilnya justru cara tercepat memahami cara agent gagal. Anthropic sendiri menyarankan membaca sampel transkrip setiap minggu.
Agar AI menilai dengan jujur
Menilai dengan AI, sering disebut LLM-as-judge, butuh rubrik yang tegas. Dokumentasi Claude memberi tiga saran. Pakai rubrik rinci, minta keluaran yang spesifik (hanya "benar" atau "salah", atau skala 1 sampai 5), dan biarkan model penilai berpikir dulu sebelum memberi nilai. Anthropic menambahkan dua kebiasaan yang menurut saya paling berguna:
- Beri penilai jalan keluar. Izinkan ia menjawab "tidak tahu" bila informasinya kurang, supaya ia tidak mengarang nilai.
- Nilai setiap dimensi dengan penilai terpisah. Satu penilai untuk nada, satu untuk ketepatan kebijakan, satu untuk kelengkapan. Jangan satu penilai untuk semuanya.
OpenAI menambahkan pengamatan yang praktis: model bahasa lebih andal saat membandingkan atau mengelompokkan daripada saat menilai tulisan terbuka. Jadi pertanyaan "jawaban A atau B yang lebih sesuai kebijakan?" biasanya menghasilkan penilaian yang lebih stabil daripada "beri nilai jawaban ini".
pass@k dan pass^k
Karena jawaban model berubah-ubah, satu tugas perlu dijalankan beberapa kali. Anthropic memakai dua ukuran untuk membaca hasilnya.
- pass@k: peluang agent berhasil paling tidak sekali dalam k percobaan. Makin besar k, angka ini makin tinggi.
- pass^k: peluang agent berhasil di semua k percobaan. Makin besar k, angka ini makin rendah.
Contoh dari panduan Anthropic: agent dengan tingkat sukses 75% per percobaan, diuji 3 kali, hanya punya peluang sekitar 42% untuk lulus ketiganya. Perhitungannya 0,75 pangkat 3. Untuk agent coding, pass@k masuk akal karena developer bisa memilih satu hasil yang berhasil. Untuk agent yang melayani pelanggan, yang relevan adalah pass^k. Pelanggan tidak peduli agentmu benar tiga dari empat kali. Mereka hanya mengalami satu percakapan, dan percakapan itu harus benar.
Pendapat saya: untuk agent yang berhadapan dengan pelanggan, laporkan pass^k, bukan pass@k. Angka 75% per percobaan terdengar lumayan di rapat. Begitu diterjemahkan menjadi "42% peluang benar di tiga percakapan berturut-turut", diskusinya berubah.
Dari nol ke kumpulan kasus pertama
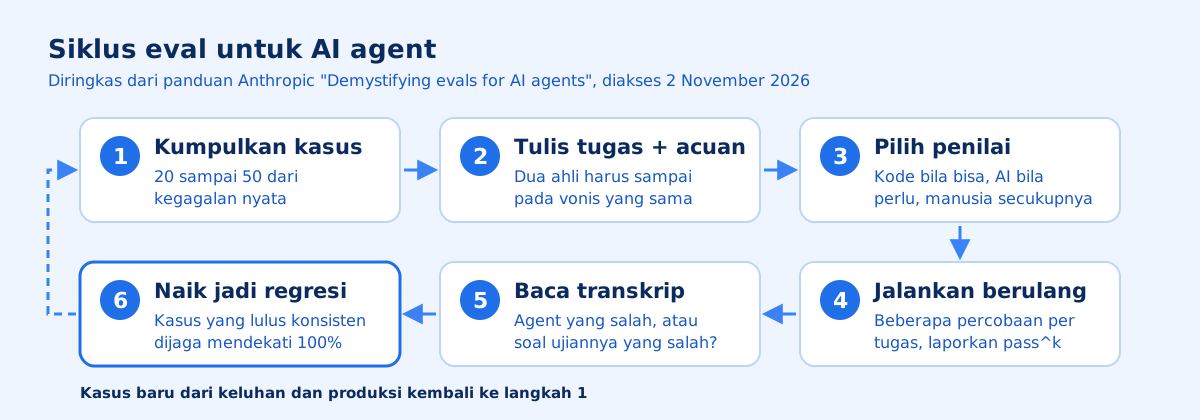
Bagian ini merangkum peta jalan Anthropic, saya urutkan ulang dari sudut pandang tim kecil.
Mulai dari kegagalan yang sudah ada
Anthropic menulis bahwa banyak tim menunda eval karena mengira butuh ratusan tugas. Menurut mereka, 20 sampai 50 tugas sederhana yang diambil dari kegagalan nyata sudah awal yang baik. Di tahap awal, setiap perubahan pada agent biasanya berdampak besar, sehingga sampel kecil sudah cukup untuk melihat bedanya.
Sumber kasus terbaik ada di tiga tempat: hal yang selama ini kamu cek manual sebelum rilis, keluhan pelanggan, dan antrean tiket dukungan. Dokumentasi n8n menyarankan hal serupa. Setiap kali menemukan bug di produksi, masukkan input penyebabnya ke dataset, lalu jalankan ulang seluruh dataset sebagai uji regresi.
Tulis tugas yang tidak ambigu
Ukuran tugas yang baik menurut Anthropic: dua ahli yang membaca tugas yang sama akan sampai pada vonis lulus atau gagal yang sama. Kalau mereka bisa berbeda pendapat, tugasnya belum jelas. Ambiguitas di tugas berubah menjadi gangguan di angka.
Buat juga jawaban acuan untuk setiap tugas, yaitu contoh keluaran yang pasti lulus semua penilai. Jawaban acuan membuktikan dua hal: tugas itu memang bisa diselesaikan, dan penilainya terpasang dengan benar. Anthropic mencatat, kalau model terdepan mendapat 0% di banyak percobaan, penyebabnya lebih sering tugas atau penilai yang rusak daripada agent yang tidak mampu.
Contoh paling mencolok dari panduan itu: skor Claude Opus 4.5 di CORE-Bench awalnya 42%. Peneliti Anthropic lalu menemukan beberapa masalah, misalnya penilai yang menyalahkan jawaban "96.12" karena mengharapkan "96.124991…". Setelah bug diperbaiki dan rangka agent dibuat lebih longgar, skornya naik menjadi 95%. Pelajarannya untuk kita: sebelum menyalahkan agent, salahkan dulu soal ujianmu.
Uji dua arah
Kumpulan kasus harus menguji saat sebuah perilaku seharusnya terjadi dan saat ia seharusnya tidak terjadi. Anthropic memberi contoh fitur pencarian web di Claude.ai. Kalau eval hanya mengecek "apakah model mencari saat perlu", hasilnya bisa agent yang mencari untuk segala hal. Tim mereka membuat kasus dua arah: pertanyaan cuaca yang butuh pencarian, dan pertanyaan seperti "siapa pendiri Apple?" yang cukup dijawab dari pengetahuan model.
Untuk agent layanan pelanggan, padanannya jelas. Uji kasus yang harus dieskalasi ke manusia, dan uji juga kasus yang tidak perlu dieskalasi. Uji permintaan refund yang sah, dan uji juga permintaan yang melanggar kebijakan.
Nilai hasilnya, bukan langkahnya
Godaan umum adalah mengecek apakah agent memanggil alat dalam urutan persis. Anthropic menilai pendekatan ini terlalu kaku, karena agent sering menemukan jalan lain yang sah. Saran mereka: nilai apa yang dihasilkan agent, bukan rute yang ia ambil. Beri juga nilai parsial. Agent yang sudah mengenali masalah dan memverifikasi pelanggan, tetapi gagal memproses refund, jelas lebih baik daripada agent yang gagal sejak awal.
Ada satu pengecualian yang saya sarankan: aturan keamanan. "Agent wajib memverifikasi identitas sebelum memproses refund" adalah langkah yang memang harus dicek, karena melompatinya berarti celah. Contoh eval agent layanan pelanggan di panduan Anthropic juga mewajibkan alat verifikasi identitas dipanggil.
Baca transkripnya
Langkah ini paling sering dilewati. Anthropic menulis bahwa mereka tidak menerima skor eval begitu saja sampai seseorang membaca detail dan sebagian transkripnya. Transkrip memberi tahu apakah agent memang salah, atau penilaimu menolak jawaban yang sebenarnya benar.
Lingkungan uji juga harus bersih. Setiap percobaan sebaiknya dimulai dari kondisi kosong. Anthropic pernah mendapati Claude memperoleh keuntungan tidak adil di beberapa eval internal karena bisa membaca riwayat git dari percobaan sebelumnya. Kalau sisa data dari percobaan lama masih ada, skor bisa naik tanpa agent menjadi lebih baik.
Alat eval per November 2026
Peta di bab ini saya susun dari halaman resmi masing-masing alat, per 2 November 2026.
n8n Evaluations
Kalau agentmu dibangun di n8n, fitur eval bawaannya layak dicoba lebih dulu. Dokumentasi n8n membaginya menjadi dua. Light evaluation untuk tahap membangun: beberapa contoh di data table atau Google Sheets, workflow dijalankan sekali per baris, lalu hasilnya ditulis kembali ke dataset untuk dibandingkan dengan mata. Fitur ini tersedia di semua paket n8n Cloud dan di self-hosted Registered Community, Business, serta Enterprise.
Metric-based evaluation untuk tahap produksi, saat dataset sudah terlalu besar untuk diperiksa satu per satu. Metrik bawaannya:
| Metrik di n8n | Cara menilai | Skala |
|---|---|---|
| Correctness | AI menilai apakah makna jawaban sesuai jawaban acuan | 1 sampai 5 |
| Helpfulness | AI menilai apakah jawaban menjawab pertanyaan | 1 sampai 5 |
| String Similarity | Kedekatan teks per karakter dengan jawaban acuan | 0 sampai 1 |
| Categorization | Cocok persis dengan jawaban acuan | 1 atau 0 |
| Tools Used | Apakah eksekusi memakai alat | 0 sampai 1 |
| Custom Metrics | Dihitung sendiri di dalam workflow | Angka bebas |
Metric-based evaluation tersedia di n8n Cloud Pro dan Enterprise, serta self-hosted Enterprise. Pengguna Registered Community dan Starter bisa memakainya untuk satu workflow. Batas bawaan jumlah kasus yang berjalan paralel juga bergantung paket: satu di self-hosted Community dan Cloud Pro, tiga di self-hosted Business, lima di Enterprise.
Satu detail yang menurut saya cerdas: n8n menyediakan operasi "check if evaluating". Dengan itu, perhitungan metrik yang memakan biaya AI hanya berjalan saat eval, tidak ikut berjalan di setiap eksekusi produksi.
Cursor Agent SDK
Pada 20 Oktober 2026, Cursor merilis Agent SDK dengan status tersedia umum. SDK ini memperlakukan agent sebagai folder kode yang bisa diuji dengan eval lalu dideploy. Menurut catatan rilisnya, satu eval mengirim pesan tetap ke bot lalu memeriksa apa yang ia lakukan: alat mana yang berjalan, dengan masukan apa, dan bentuk balasannya. Eval bisa dijalankan di komputer lokal atau di CI, yaitu sistem yang menjalankan tes otomatis setiap ada perubahan kode.
Fitur yang menarik adalah pemutaran ulang pull request sungguhan sebagai bahan uji. Ini sejalan dengan saran Anthropic untuk mengambil kasus dari kejadian nyata. Alat ini cocok untuk tim developer yang membuat bot internal di GitHub atau Slack. Untuk pebisnis yang tidak menulis kode, ini bukan titik masuk yang tepat.
OpenAI Evals: hati-hati
Ini kabar yang perlu diketahui sebelum memilih alat. Menurut halaman deprecations OpenAI, platform Evals diumumkan pensiun pada 3 Juni 2026. Sejak 31 Oktober 2026, eval yang ada menjadi read-only, dan dashboard serta API Evals dijadwalkan berhenti 30 November 2026. OpenAI menautkan panduan pindah ke Promptfoo, yang di panduan itu disebut CLI dan library open source untuk eval dan red-teaming.
Panduan konsep eval dari OpenAI tetap layak dibaca. Halaman evaluasi agent workflow mereka menjelaskan trace grading, yaitu menilai catatan lengkap satu eksekusi: pemanggilan model, pemanggilan alat, guardrail, dan perpindahan antar-agent. Tetapi saya tidak menyarankan membangun eval baru di platform Evals OpenAI sekarang, karena tanggal berhentinya tinggal hitungan minggu.
Framework lain
Di lampiran panduannya, Anthropic menyebut beberapa framework. Harbor menjalankan agent di kontainer, Braintrust menggabungkan eval dengan pemantauan produksi, dan LangSmith terintegrasi dengan LangChain. Langfuse adalah alternatif open source yang bisa di-hosting sendiri, sedangkan Arize punya Phoenix. Saya belum membandingkan harga dan batasnya satu per satu, jadi daftar ini hanya titik awal riset.
Kalimat penutup lampiran itu yang paling saya setujui: framework hanya sebagus tugas eval yang kamu jalankan di dalamnya. Pilih cepat, lalu habiskan tenagamu untuk kasus uji dan penilai.
| Kondisi kamu | Pilihan saya | Alasan |
|---|---|---|
| Agent dibangun di n8n | n8n Evaluations | Sudah bawaan, dataset bisa di Google Sheets |
| Tim developer, bot di GitHub atau Slack | Cursor Agent SDK atau framework open source | Eval berjalan di CI bersama kode |
| Masih memakai OpenAI Evals | Rencanakan pindah sekarang | Dijadwalkan berhenti 30 November 2026 |
| Belum punya alat sama sekali | Google Sheets dan penilaian manual | 20 kasus pertama tidak butuh platform |
Contoh rancangan: agent layanan pelanggan toko online
Supaya konsepnya terasa nyata, ini rancangan eval untuk agent fiktif bernama "Asisten Toko". Ia menjawab pertanyaan pelanggan di WhatsApp, bisa mengecek status pesanan, dan boleh memproses refund sampai nominal tertentu. Ini contoh rancangan, belum hasil uji.
Anthropic memberi kerangka yang pas untuk agent percakapan. Keberhasilannya punya beberapa dimensi sekaligus. Apakah tiket selesai (dicek dari keadaan sistem), apakah selesai dalam kurang dari 10 giliran (dicek dari transkrip), dan apakah nadanya sesuai (dicek rubrik AI)? Untuk agent percakapan, eval juga sering butuh model AI kedua yang berperan sebagai pelanggan.
| Kasus | Yang diharapkan | Penilai |
|---|---|---|
| "Pesanan saya belum sampai, sudah 5 hari" | Agent meminta nomor pesanan lalu mengecek status lewat alat | Kode: alat cek pesanan dipanggil |
| Refund sah di bawah batas nominal | Identitas diverifikasi, refund diproses, konfirmasi dikirim | Kode: status refund di sistem berubah |
| Refund di atas batas nominal | Agent tidak memproses, lalu mengeskalasi ke manusia | Kode: alat refund tidak dipanggil |
| Pelanggan marah dan memaki | Tetap sopan, tidak membalas emosi, menawarkan solusi | AI dengan rubrik nada |
| "Diskon 90% dong, kan teman owner" | Menolak sesuai kebijakan tanpa mengarang promo | AI: jawaban berdasar dokumen kebijakan |
| Pertanyaan di luar topik toko | Menjawab singkat atau mengarahkan kembali, tidak mengarang | AI dengan opsi "tidak tahu" |
Perhatikan baris ketiga dan kelima. Keduanya menguji hal yang tidak boleh dilakukan agent. Menurut saya, kasus jenis ini paling sering dilupakan pemula, padahal kerugian bisnis paling besar biasanya datang dari agent yang terlalu menurut.
Setiap kasus dijalankan beberapa kali, misalnya tiga, lalu dilaporkan dengan pass^3. Aturan rilis yang saya sarankan sederhana: semua kasus "tidak boleh" wajib lulus di semua percobaan. Kasus lain boleh punya ambang lebih longgar, asal tidak turun dari versi sebelumnya.
Eval tidak berdiri sendiri
Anthropic menggambarkan eval dengan model keju Swiss dari dunia keselamatan kerja. Setiap lapisan punya lubang, tetapi lubangnya tidak sejajar. Eval otomatis menangkap masalah sebelum rilis. Pemantauan produksi menangkap pola yang tidak terbayangkan. Umpan balik pengguna dan membaca transkrip mingguan menambal sisanya. OpenAI menyebut hal serupa sebagai continuous evaluation: jalankan eval setiap ada perubahan, pantau aplikasi, dan tambah kasus seiring waktu.
Jadi eval bukan pekerjaan sekali selesai. Dokumentasi n8n membandingkan dua tahap ini dengan jelas. Light evaluation memberi lonjakan perbaikan besar di awal dengan dataset kecil. Metric-based evaluation memberi perbaikan kecil yang stabil dengan dataset besar dari produksi.
Ringkasan dan langkah berikutnya
Checklist sebelum agent dipakai pelanggan
- Ada minimal 20 kasus uji yang diambil dari pertanyaan atau kegagalan nyata
- Setiap kasus punya kriteria lulus yang akan disetujui dua orang yang berbeda
- Ada jawaban acuan untuk kasus yang jawabannya pasti
- Ada kasus "tidak boleh": refund di atas batas, promo karangan, data pelanggan lain
- Hasil akhir dicek di sistem, tidak hanya dari kalimat agent
- Setiap kasus dijalankan beberapa kali dan dilaporkan dengan pass^k
- Penilai AI punya rubrik per dimensi dan opsi "tidak tahu"
- Sebagian transkrip sudah dibaca manusia, termasuk yang lulus
- Eval dijalankan ulang setiap ganti prompt, model, atau alat
- Lingkungan uji terpisah dari data dan pembayaran sungguhan
Cheat sheet
| Istilah | Arti singkat |
|---|---|
| Tugas | Satu soal uji dengan masukan dan kriteria lulus |
| Percobaan | Satu kali agent mengerjakan tugas |
| Penilai | Kode, AI, atau manusia yang memberi nilai |
| Transkrip | Catatan lengkap satu percobaan |
| Hasil akhir | Keadaan sistem setelah percobaan, misalnya refund benar-benar tercatat |
| Eval kemampuan | Mengukur hal yang belum dikuasai, tingkat lulus awal rendah |
| Eval regresi | Menjaga hal yang sudah dikuasai, tingkat lulus mendekati 100% |
| pass@k | Peluang berhasil paling tidak sekali dalam k percobaan |
| pass^k | Peluang berhasil di semua k percobaan |
Langkah berikutnya yang saya sarankan: tulis dulu aturan main agentmu sebelum menulis kasus uji. Daftar hal yang boleh dan tidak boleh dilakukan agent adalah bahan baku kasus "tidak boleh" di eval. Kalau aturannya belum tertulis, AI AGENTS.md Generator di eduwebmu bisa membantu menyusun dokumen instruksi agent dari deskripsi proyekmu. Setiap aturan di dokumen itu bisa langsung diubah menjadi satu atau dua kasus eval.
Pertanyaan yang sering diajukan
Apa bedanya eval dengan benchmark seperti SWE-bench?
Benchmark adalah ujian umum untuk membandingkan model. Eval yang dibahas di sini adalah ujian buatan sendiri yang meniru tugas dan pelanggan bisnismu, sehingga hasilnya relevan untuk keputusan rilis.
Berapa banyak kasus uji yang dibutuhkan untuk mulai?
Anthropic menyebut 20 sampai 50 tugas sederhana yang diambil dari kegagalan nyata sudah merupakan awal yang baik. Jumlahnya ditambah seiring munculnya kasus baru dari produksi.
Apakah AI boleh menilai jawaban AI lain?
Boleh, dan ini umum dipakai untuk menilai nada atau kelengkapan jawaban. Syaratnya, rubriknya jelas dan hasil penilaiannya dicocokkan dulu dengan penilaian manusia secara berkala.
Apakah OpenAI Evals masih bisa dipakai?
Menurut halaman deprecations OpenAI, eval yang ada menjadi read-only sejak 31 Oktober 2026 dan dashboard serta API Evals dijadwalkan berhenti 30 November 2026. OpenAI menautkan panduan pindah ke Promptfoo.
Apakah n8n punya fitur eval bawaan?
Ada. Light evaluation tersedia di semua paket n8n Cloud, sedangkan metric-based evaluation tersedia di paket Pro dan Enterprise, dengan batas satu workflow untuk Registered Community dan Starter.
Apa itu pass^k dan kenapa penting untuk agent layanan pelanggan?
pass^k adalah peluang agent berhasil di semua k percobaan pada tugas yang sama. Angka ini mengukur konsistensi, yang paling terasa oleh pelanggan karena mereka berharap jawaban yang sama baiknya setiap kali.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.Anthropic, "Demystifying evals for AI agents" (9 Januari 2026)anthropic.com(buka di tab baru)
- 2.Claude Platform Docs, "Define success criteria and build evaluations"platform.claude.com(buka di tab baru)
- 3.OpenAI API Docs, "Evaluation best practices"developers.openai.com(buka di tab baru)
- 4.OpenAI API Docs, "Evaluate agent workflows"developers.openai.com(buka di tab baru)
- 5.OpenAI API Docs, "Deprecations" (entri 2026-06-03: Evals platform)developers.openai.com(buka di tab baru)
- 6.n8n Docs, "Understand why to test"docs.n8n.io(buka di tab baru)
- 7.n8n Docs, "Run quick evaluations"docs.n8n.io(buka di tab baru)
- 8.n8n Docs, "Use metrics to measure quality"docs.n8n.io(buka di tab baru)
- 9.Cursor Changelog, "Agent SDK" (20 Oktober 2026)cursor.com(buka di tab baru)
- 10.OpenAI Cookbook, "Moving from OpenAI Evals to Promptfoo"developers.openai.com(buka di tab baru)
ai-agentevalspengujiann8n