Halusinasi pada AI agent: cara mendeteksinya sebelum merugikan
Oleh Dedi NugrohoTerbit 16 menit baca
Daftar isi
Halusinasi AI agent adalah keluaran yang terdengar meyakinkan tetapi tidak didukung fakta atau konteks. Cara mendeteksinya: cocokkan jawaban dengan konteks yang diberikan, cek klaim penting ke sumber resmi, ukur kestabilan jawaban, lalu tahan keluaran berisiko untuk ditinjau manusia sebelum agent bertindak. Tidak ada satu skor yang cukup.
Tesis artikel ini: halusinasi tidak bisa dihapus, jadi yang perlu kamu rancang adalah jalur ketika ia terdeteksi. Banyak tim sibuk mencari prompt ajaib supaya model "tidak mengarang". Menurut saya energi itu lebih berguna dipakai untuk menjawab dua pertanyaan. Pemeriksaan apa yang cocok untuk jenis kesalahan ini? Lalu ke mana keluaran yang mencurigakan dikirim?
Yang perlu diluruskan dulu
Ada tiga anggapan keliru soal halusinasi yang perlu dibereskan sebelum bicara alat.
Pertama, "halusinasi itu kelihatan aneh". Kenyataannya sebaliknya. Blog resmi n8n tentang deteksi halusinasi (terbit 22 Oktober 2026) membuka dengan pengamatan bahwa halusinasi agent sulit ditangkap justru karena bentuknya mirip jawaban normal. Agent tidak memberi tanda saat mengarang angka atau salah membaca dokumen.
Kedua, "pakai RAG, masalah selesai". RAG (retrieval-augmented generation) adalah teknik mengambil dokumen yang relevan lalu menyertakannya ke model sebelum menjawab. RAG membantu, tetapi model masih bisa melenceng dari dokumen itu. Dokumennya sendiri juga bisa usang atau salah.
Ketiga, "cukup pasang satu detektor". Artikel n8n yang sama menyatakan tidak ada detektor halusinasi universal. Setiap metode menangkap jenis kesalahan tertentu dan melewatkan yang lain.
Masalahnya makin mahal pada AI agent. AI agent adalah sistem yang memakai model bahasa untuk memutuskan langkah dan memanggil tool, misalnya mengirim email atau menulis ke database. Chatbot yang mengarang hanya menghasilkan jawaban salah di layar. Agent yang mengarang bisa langsung mengirim jawaban itu ke pelanggan atau mengubah satu baris data.
| Bab | Pertanyaan yang dijawab |
|---|---|
| Empat wujud halusinasi | Kesalahan seperti apa yang sebenarnya perlu ditangkap? |
| Lima cara mendeteksi | Bagaimana tiap metode bekerja, dan di mana ia gagal? |
| Menyusun pemeriksaan berlapis | Bagaimana metode itu dirangkai di dalam workflow? |
| Memilih sesuai risiko | Seberapa ketat pemeriksaan untuk kasus saya? |
| Ringkasan | Apa yang dicek sebelum agent dilepas ke produksi? |
Catatan jujur. Artikel ini ditulis 2 November 2026. Isinya berdasarkan blog dan dokumentasi resmi n8n, dokumentasi DeepEval, dan satu makalah penelitian di Nature. Artikel ini tidak memuat hasil uji sendiri. Saya tidak menyertakan angka akurasi detektor mana pun, karena hasilnya sangat bergantung pada data dan model yang dipakai. Fitur dan ketersediaan paket bisa berubah, jadi cek ulang halaman resminya sebelum memutuskan.
Artikel ini untuk kamu yang sedang membangun atau mengelola AI agent untuk bisnis, entah di n8n, platform lain, atau kode sendiri. Pemilik usaha yang ingin tahu risiko sebelum menyerahkan pekerjaan ke agent juga akan terbantu. Kalau kamu hanya memakai chatbot untuk menulis draf yang selalu kamu baca ulang, sebagian besar isi artikel ini terlalu berat untuk kebutuhanmu.
Empat wujud halusinasi yang perlu kamu kenali
Kata "halusinasi" sering dipakai untuk semua jenis jawaban salah. Itu terlalu kasar untuk keperluan deteksi. Blog n8n membaginya menjadi empat jenis, dan pembagian ini berguna karena tiap jenis butuh alat cek berbeda.
Halusinasi faktual
Model membuat klaim yang bertentangan dengan fakta yang bisa diverifikasi. Contohnya statistik, nama orang, atau kejadian yang tidak pernah ada. Pada agent layanan pelanggan, bentuknya bisa berupa nomor resi atau tanggal pengiriman yang dikarang.
Halusinasi kontekstual
Jawaban tidak didukung konteks yang diberikan ke model. Jenis ini paling sering muncul di sistem RAG. Jawabannya terdengar masuk akal, tetapi menyimpang dari dokumen yang diambil atau menambahkan hal yang tidak tertulis di sana. Misalnya dokumen kebijakan menyebut garansi 30 hari, lalu agent menulis "garansi 30 hari, bisa diperpanjang".
Konfabulasi
Model mengisi celah informasi dengan detail yang tidak pernah diberikan. Hasilnya koheren dan rapi, tetapi tidak punya dasar. Ini sering terjadi ketika prompt meminta jawaban lengkap sementara datanya memang kurang.
Kontradiksi diri
Model menyatakan sesuatu yang bertentangan dengan bagian lain dari jawabannya sendiri, atau dengan informasi yang ia berikan sebelumnya. Di agent yang berjalan beberapa langkah, ini bisa muncul sebagai ringkasan akhir yang tidak cocok dengan hasil tool di langkah awal.
Pembagian ini punya akibat praktis. LLM juri adalah model kedua yang diminta menilai jawaban model pertama. Kalau juri itu hanya diberi prompt umum seperti "periksa apakah jawaban ini benar", ia tidak punya acuan yang jelas. Ia menilai dengan pengetahuannya sendiri, yang juga bisa berhalusinasi. Lebih tajam bila kamu tahu jenis mana yang paling mungkin muncul di kasusmu, lalu memilih alat cek yang memang dirancang untuk jenis itu.
Lima cara mendeteksi, dan di mana masing-masing gagal
Blog n8n menyebut deteksi halusinasi bekerja paling baik sebagai sistem berlapis. Berikut lima metode yang dibahasnya, saya tambah catatan dari sumber primer masing-masing dan pendapat saya soal kapan memakainya.
1. Cek faithfulness atau groundedness
Faithfulness bertanya: apakah klaim di jawaban memang didukung konteks yang diterima model? Caranya, jawaban dipecah menjadi klaim-klaim kecil. Setiap klaim lalu dibandingkan dengan dokumen yang diambil, dan hasilnya menjadi skor.
Contoh alat yang menghitungnya adalah DeepEval, framework evaluasi LLM berbasis Python. Menurut dokumentasi FaithfulnessMetric DeepEval, skornya adalah jumlah klaim yang dianggap benar dibagi jumlah seluruh klaim. Dalam mode LLM-as-a-judge, klaim diekstrak oleh LLM, lalu LLM yang sama menilai setiap klaim terhadap konteks. Dokumentasinya juga mencantumkan mode lain yang memakai model penilai berbeda.
Ada detail di dokumentasi itu yang layak dibaca pelan. Definisinya menyebut klaim dianggap benar bila tidak bertentangan dengan fakta di konteks. DeepEval sendiri menulis metrik ini lebih fokus pada kontradiksi antara jawaban dan konteks. Di bagian tanya jawab halaman yang sama, DeepEval juga menyebut fakta dunia nyata yang tidak ada di teks hasil pengambilan tetap dihitung tidak setia. Ada pula opsi untuk tidak menghitung klaim ambigu sebagai benar. Jadi pahami definisi skor dan pengaturannya sebelum memakai angka itu sebagai gerbang.
Kapan saya sarankan: hampir selalu, untuk agent yang menjawab dari dokumen internal. Batasnya: tidak tahu apakah dokumennya sendiri benar, dan juri LLM-nya bisa keliru.
2. Cek konsistensi diri
Ajukan pertanyaan yang sama beberapa kali, lalu bandingkan jawabannya. Kalau jawaban yang dibuat terpisah sampai ke klaim yang sama, itu sinyal kestabilan. Kalau jawabannya saling berbeda jauh, keluaran itu pantas dicurigai. Metode ini tidak butuh basis pengetahuan dari luar, karena model dibandingkan dengan dirinya sendiri.
Blog n8n tegas soal batasnya: beberapa jawaban bisa sepakat pada informasi yang sama-sama salah. Konsistensi adalah sinyal, bukan bukti. Saya tambahkan satu batas praktis lagi. Metode ini melipatgandakan panggilan ke model, jadi biaya dan waktu tunggu ikut naik.
Kapan saya sarankan: untuk pertanyaan faktual tanpa sumber acuan yang jelas, dan hanya pada jalur yang volumenya kecil. Tidak saya sarankan untuk tiap pesan chat pelanggan, karena biayanya cepat menumpuk.
3. Semantic entropy dan estimasi ketidakpastian
Semantic entropy adalah ukuran seberapa "terpencar" makna jawaban-jawaban model untuk pertanyaan yang sama. Metode ini memperkenalkan cara pandang berbeda dari cek konsistensi biasa. Ia tidak membandingkan kata, tetapi makna. Dua jawaban dengan kalimat berbeda yang artinya sama dihitung satu kelompok.
Metode ini dijelaskan dalam makalah Farquhar dan rekan, "Detecting hallucinations in large language models using semantic entropy", yang terbit di Nature edisi Juni 2024. Abstraknya menyebut metode ini menargetkan sebagian jenis halusinasi, yaitu konfabulasi, dan tidak butuh data khusus per tugas. Entropi tinggi berarti model tidak yakin, sehingga jawabannya layak masuk pemeriksaan tambahan.
Seperti cek konsistensi, ukuran ini memberi tahu seberapa stabil sebuah jawaban, bukan apakah jawabannya benar. Implementasinya juga lebih rumit, karena butuh beberapa jawaban sekaligus dan langkah pengelompokan makna. Daftar metrik bawaan di dokumentasi Evaluations n8n tidak memuat semantic entropy, jadi anggap ini metode untuk tim yang sanggup menulis logika sendiri.
4. Verifikasi ke sumber
Faithfulness bertanya apakah jawaban mencerminkan konteks. Verifikasi sumber bertanya apakah klaimnya benar menurut sumber resmi di luar konteks. Perbedaan ini penting saat pengambilan dokumennya yang bermasalah. Jawaban yang setia pada dokumen tetap salah kalau dokumennya usang atau tidak relevan.
Contoh paling praktis: agent menyebut status pesanan, lalu workflow mencocokkan status itu dengan sistem pesanan lewat API. Atau agent menyebut harga, lalu harga itu dicocokkan dengan tabel harga resmi. Metode ini paling kuat ketika ada satu sumber kebenaran yang jelas.
Pendapat saya: ini lapisan yang paling sering dilupakan, padahal paling murah untuk data terstruktur. Mencocokkan angka dengan database tidak butuh LLM juri sama sekali. Hasilnya juga bisa dijelaskan ke atasan atau pelanggan tanpa debat.
5. Ambang keyakinan dan manusia dalam alur
Human in the loop berarti ada manusia yang meninjau atau menyetujui sebelum sistem bertindak. Blog n8n menyarankan ambang bertingkat. Hasil dengan keyakinan tinggi diteruskan otomatis, hasil yang meragukan masuk pemeriksaan tambahan, dan kasus berisiko tinggi ditahan untuk manusia sebelum agent mengambil aksi ke luar.
Ambangnya harus mengikuti akibat kesalahan. Ringkasan internal boleh lebih longgar daripada agent yang hendak mengubah data pelanggan. Blog yang sama juga menyebut pendekatan human on the loop, yaitu manusia mengontrol kualitas keluaran setelah eksekusi workflow selesai.
Menyusun pemeriksaan berlapis di dalam workflow
Mengetahui metode belum cukup. Blog n8n menekankan bahwa bagian terpenting adalah apa yang terjadi setelah masalah terdeteksi. Keluaran yang ditandai harus punya tujuan: cek tambahan, coba ulang, workflow error, atau seseorang yang mengambil keputusan akhir.
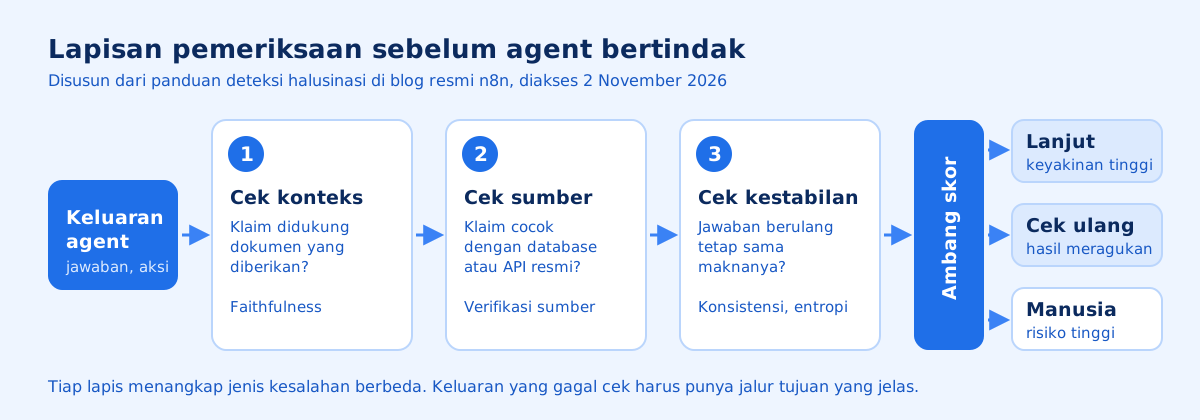
Di n8n, ada beberapa fitur bawaan yang bisa mengisi lapisan-lapisan ini. Saya petakan sesuai dokumentasi resminya, termasuk apa yang tidak bisa dilakukan.
Guardrails: penjaga kebijakan, belum detektor halusinasi
Menurut dokumentasi node Guardrails, node ini dipakai untuk menegakkan kebijakan keamanan dan konten pada teks. Ia bisa memeriksa masukan sebelum dikirim ke model, atau keluaran model sebelum dipakai di langkah berikutnya.
Ada dua mode. Check Text for Violations mengirim item yang melanggar ke cabang Fail. Sanitize Text mengganti temuan seperti URL, kunci rahasia, atau data pribadi dengan placeholder. Pilihan pemeriksaannya meliputi Keywords, Jailbreak, NSFW, PII, Secret Keys, Topical Alignment, URLs, Custom, dan Custom Regex. Pemeriksaan berbasis LLM butuh Chat Model yang tersambung dan memakai ambang 0,0 sampai 1,0.
Perhatikan daftar itu. Tidak ada satu pun yang bernama "hallucination" atau "faithfulness". Guardrails menjaga agar agent tidak membocorkan data pribadi, tidak keluar topik, dan tidak menyisipkan tautan aneh. Itu penting, tetapi urusannya berbeda. Opsi Custom bisa diberi prompt sendiri, misalnya "tandai klaim yang tidak ada di konteks berikut". Hasilnya tetap penilaian satu model, jadi perlakukan sebagai sinyal, belum bukti.
Evaluations: menguji sebelum dan sesudah rilis
Fitur Evaluations di n8n menjalankan kumpulan kasus uji melewati workflow. Halaman pengantar evaluasi membaginya menjadi dua jenis. Light evaluation dipakai saat membangun, dengan sedikit contoh yang dibandingkan secara visual. Metric-based evaluation dipakai setelah rilis, dengan dataset lebih besar dan skor angka.
Halaman metric-based evaluation mencantumkan metrik bawaan berikut:
| Metrik | Yang diukur | Skala |
|---|---|---|
| Correctness (berbasis AI) | Apakah makna jawaban sesuai jawaban acuan | 1 sampai 5 |
| Helpfulness (berbasis AI) | Apakah jawaban menjawab pertanyaan | 1 sampai 5 |
| String Similarity | Kedekatan teks per karakter dengan jawaban acuan | 0 sampai 1 |
| Categorization | Sama persis dengan jawaban acuan atau tidak | 0 atau 1 |
| Tools Used | Apakah eksekusi memakai tool | 0 sampai 1 |
Kamu juga bisa membuat metrik sendiri, misalnya skor faithfulness hasil hitungan langkah lain, lalu memasukkannya lewat opsi Custom Metrics. Dokumentasi n8n mengingatkan bahwa menghitung metrik menambah biaya dan waktu. Karena itu ada operasi untuk memeriksa apakah eksekusi sedang dalam mode evaluasi, supaya logika metrik tidak ikut berjalan di produksi.
Soal paket, dokumentasi menyebut light evaluation tersedia di semua paket n8n Cloud dan self-hosted Registered Community, Business, serta Enterprise. Metric-based evaluation tersedia di Cloud Pro dan Enterprise serta self-hosted Enterprise. Pengguna Registered Community dan Starter bisa memakainya untuk satu workflow.
Evaluations bukan detektor yang berjalan di setiap eksekusi produksi. Fungsinya mengukur kualitas pada dataset, jadi kamu tahu apakah perubahan prompt atau model memperbaiki atau malah merusak. Dokumentasi n8n menyebut input yang memicu bug bisa ditambahkan ke dataset, lalu seluruh dataset dijalankan ulang sebagai uji regresi setelah bug diperbaiki. Kebiasaan ini menurut saya jauh lebih berharga daripada memilih detektor paling canggih.
Human review per tool
Untuk lapisan terakhir, n8n punya fitur human-in-the-loop untuk tools. Saat AI Agent hendak memakai tool yang ditandai butuh tinjauan, workflow berhenti dan mengirim permintaan persetujuan. Peninjau melihat tool apa yang akan dipakai beserta parameternya, lalu memilih Approve atau Deny. Kalau ditolak, aksi batal dan agent diberi tahu.
Permintaan persetujuan bisa dikirim lewat Chat bawaan n8n, Slack, Discord, Telegram, Microsoft Teams, Gmail, WhatsApp Business Cloud, Google Chat, atau Microsoft Outlook. Dokumentasinya menyarankan fitur ini untuk aksi yang tidak bisa dibatalkan, kebutuhan kepatuhan, keputusan bernilai tinggi, dan masa awal ketika kepercayaan pada agent belum terbentuk.
Yang saya suka dari pendekatan ini: persetujuan bisa dipasang per tool. Tool baca data tidak perlu ditahan, sedangkan tool kirim email atau hapus data bisa. Dokumentasi juga mengingatkan agar system prompt menjelaskan tool mana yang butuh persetujuan dan bagaimana agent menanggapi penolakan.
Error Trigger dan riwayat eksekusi
Kalau workflow gagal, node Error Trigger bisa menjalankan workflow terpisah khusus penanganan error. Dua catatan dari dokumentasinya: Error Trigger hanya berjalan saat workflow otomatis gagal, jadi tidak bisa diuji lewat eksekusi manual. Node Stop And Error bisa dipakai untuk mengirim pesan khusus ke workflow error itu.
Ini berguna untuk halusinasi yang terdeteksi tetapi tidak bisa ditangani otomatis. Alih-alih membiarkan keluaran mencurigakan diam-diam diteruskan, workflow sengaja dihentikan dengan pesan yang jelas, lalu workflow error memberi tahu orang yang bertanggung jawab. Riwayat eksekusi kemudian membantu menelusuri apa yang diterima dan dihasilkan agent saat itu.
Memilih tingkat pemeriksaan sesuai risiko
Memasang semua lapisan di setiap workflow itu mahal dan lambat. Saya lebih suka mulai dari pertanyaan: kalau agent ini salah, siapa yang rugi dan seberapa cepat kesalahannya ketahuan?
| Jenis tugas agent | Risiko | Lapisan yang saya sarankan |
|---|---|---|
| Meringkas rapat atau dokumen untuk dibaca sendiri | Rendah | Cek terhadap konteks saat evaluasi. Pembaca tetap memeriksa |
| Menjawab pertanyaan internal tim dari dokumen | Sedang | Faithfulness, plus tautan ke dokumen asal di setiap jawaban |
| Menjawab chat pelanggan soal produk dan kebijakan | Tinggi | Faithfulness, Guardrails untuk topik dan data pribadi, eskalasi ke manusia bila skor rendah |
| Menyebut harga, stok, atau status pesanan | Tinggi | Verifikasi ke database atau API sebelum dikirim |
| Mengirim email, mengubah data, atau melakukan pembayaran | Sangat tinggi | Human review per tool, ditambah Error Trigger untuk kegagalan |
Tabel di atas adalah pendapat saya, disusun dari prinsip di dokumentasi n8n. Ia bukan aturan resmi. Ada tiga keputusan yang saya pegang saat memakainya.
Saya memilih verifikasi sumber dulu, LLM juri belakangan. Untuk data yang punya sumber kebenaran, mencocokkan langsung lebih murah, lebih cepat, dan lebih mudah dijelaskan. Juri LLM cukup dipakai untuk teks bebas yang memang tidak bisa dicocokkan dengan tabel.
Saya tidak menyarankan memakai cek konsistensi berulang di jalur bervolume tinggi. Lima panggilan model untuk satu jawaban mungkin wajar di laporan bulanan. Untuk ratusan chat per hari, biayanya cepat terasa, sementara hasilnya tetap hanya sinyal.
Mulai ketat, lalu longgarkan berdasarkan data. Ini sejalan dengan saran dokumentasi human review: aktifkan tinjauan saat kepercayaan belum terbentuk, kurangi setelah terbukti. Urutan sebaliknya, melepas agent bebas lalu menambah pengaman setelah ada keluhan, berarti pelangganmu yang menjadi penguji pertama.
Ada juga alternatif di luar n8n. Kalau timmu terbiasa menulis Python, DeepEval dan pustaka guardrail lain bisa dijalankan di pipeline pengujian sendiri. Blog n8n menyebut kombinasi semacam ini sebagai pola umum: framework evaluasi menghitung metrik, sedangkan logika workflow menentukan nasib keluarannya. Kelebihan n8n adalah semuanya ada di kanvas yang sama. Kekurangannya, metode seperti semantic entropy tetap harus kamu rakit sendiri.
Satu hal lagi yang perlu diterima sejak awal: deteksi tidak menjamin semua kesalahan tertangkap. Blog n8n menyebut skor bergantung pada kualitas konteks dan metode evaluasi. Ambang bisa menghasilkan alarm palsu atau melewatkan kesalahan halus. Karena itu jejak eksekusi yang lengkap sama pentingnya dengan detektornya. Saat ada yang lolos, kamu perlu bisa melihat masukan, konteks, keluaran, dan aksi lanjutan agent untuk memperbaiki workflow.
Ringkasan dan langkah berikutnya
Checklist sebelum agent dilepas ke produksi
- Sudah tahu jenis halusinasi yang paling mungkin muncul di kasus ini
- Jawaban dari dokumen dicek terhadap konteks, dan definisi skornya dipahami
- Angka, harga, stok, dan status dicocokkan ke database atau API
- Tool yang mengirim pesan, mengubah data, atau membayar butuh persetujuan manusia
- Keluaran yang gagal cek punya jalur jelas: cek ulang, workflow error, atau manusia
- Ada dataset uji, dan setiap bug baru masuk sebagai kasus uji
- Ambang skor ditentukan dari data sendiri, bukan disalin dari contoh
- Riwayat eksekusi cukup lengkap untuk menelusuri kesalahan yang lolos
Cheat sheet metode deteksi
| Metode | Menangkap | Tidak menangkap | Fitur n8n terdekat |
|---|---|---|---|
| Faithfulness | Jawaban yang menyimpang dari konteks | Dokumen sumber yang salah | Custom Metrics di Evaluations, atau langkah LLM terpisah |
| Konsistensi diri | Jawaban yang tidak stabil | Jawaban salah yang konsisten | Dirakit sendiri |
| Semantic entropy | Konfabulasi, ketidakpastian makna | Kebenaran faktual | Dirakit sendiri |
| Verifikasi sumber | Klaim yang bertentangan dengan data resmi | Klaim tanpa sumber acuan | Node database atau HTTP Request |
| Ambang dan manusia | Kasus berisiko tinggi | Kesalahan yang lolos ambang | Human review per tool |
| Guardrails | Data pribadi, keluar topik, jailbreak, URL | Halusinasi faktual secara umum | Node Guardrails |
Kalau kamu sedang merancang workflow agent baru, gambar dulu lapisan pemeriksaannya sebelum menulis prompt. n8n Workflow Generator di eduwebmu bisa membantu menyusun kerangka workflow dari deskripsi kebutuhanmu. Sebutkan di deskripsinya bahwa kamu butuh cabang untuk keluaran yang gagal cek dan langkah persetujuan sebelum aksi ke luar. Setelah kerangkanya jadi, cocokkan dengan checklist di atas.
Pertanyaan yang sering diajukan
Apakah halusinasi AI agent bisa dihilangkan sepenuhnya?
Tidak. Blog resmi n8n sendiri menyebut halusinasi tidak bisa dicegah sepenuhnya. Yang bisa dilakukan adalah menangkap lebih banyak keluaran yang tidak bisa dipercaya dengan beberapa lapis pemeriksaan.
Apa beda faithfulness dan cek sumber?
Faithfulness memeriksa apakah jawaban sesuai dengan konteks yang diberikan ke model. Cek sumber memeriksa apakah klaimnya benar menurut sumber resmi di luar konteks itu, misalnya database atau API.
Apakah node Guardrails di n8n bisa mendeteksi halusinasi?
Bukan itu fungsi utamanya. Dokumentasi n8n menyebut Guardrails untuk kebijakan keamanan dan konten, seperti PII, jailbreak, dan URL. Opsi Custom yang berbasis LLM bisa diberi prompt pemeriksaan sendiri, tetapi hasilnya tetap penilaian model.
Fitur Evaluations n8n tersedia di paket apa?
Menurut dokumentasi n8n, light evaluation tersedia di semua paket n8n Cloud serta self-hosted Registered Community, Business, dan Enterprise. Metric-based evaluation tersedia di Cloud Pro dan Enterprise serta self-hosted Enterprise, dengan pengecualian satu workflow untuk Registered Community dan Starter.
Kapan agent wajib menunggu persetujuan manusia?
Saat tool yang dipanggil melakukan aksi yang sulit dibatalkan, seperti mengirim pesan keluar, mengubah data pelanggan, menghapus data, atau membayar. n8n menyediakan human review per tool untuk kasus seperti ini.
Apakah meminta model menjawab berkali-kali cukup untuk mendeteksi halusinasi?
Tidak cukup. Jawaban yang konsisten hanya sinyal kestabilan. Beberapa jawaban bisa sama-sama salah, jadi cek konsistensi perlu dipasangkan dengan cek konteks atau cek sumber.
Sumber dan referensi
Semua sumber diakses 2 November 2026.
- 1.n8n Blog, "Hallucination Detection Methods for AI Agent Workflows" (22 Oktober 2026)blog.n8n.io(buka di tab baru)
- 2.n8n Docs, "Guardrails"docs.n8n.io(buka di tab baru)
- 3.n8n Docs, "Understand why to test"docs.n8n.io(buka di tab baru)
- 4.n8n Docs, "Use metrics to measure quality"docs.n8n.io(buka di tab baru)
- 5.n8n Docs, "Run quick evaluations"docs.n8n.io(buka di tab baru)
- 6.n8n Docs, "Human-in-the-loop for tools"docs.n8n.io(buka di tab baru)
- 7.n8n Docs, "Error Trigger"docs.n8n.io(buka di tab baru)
- 8.DeepEval Docs, "Faithfulness"deepeval.com(buka di tab baru)
- 9.Farquhar, Kossen, Kuhn, Gal, "Detecting hallucinations in large language models using semantic entropy", Nature 630, 625-630 (terbit daring 19 Juni 2024)nature.com(buka di tab baru)
ai-agenthalusinasin8nevaluasi-llm